 테크·IT
Ollama는 로컬 컴퓨터에서 대규모 언어 모델, 즉 LLM을 내려받고 실행하고 관리하는 도구다. 처음에는 터미널에서 모델을 돌리는 간단한 런타임으로 알려졌지만, 2026년 6월 기준으로는 데스크톱 앱, 로컬 API, OpenAI 호환 API, Cloud 모델, 웹 검색 API, 코딩 도구 실행까지 묶은 오픈 모델 실행 플랫폼에 가깝다.
사용자가 Ollama를 찾는 이유는 단순하다. ChatGPT 같은 클라우드 서비스에 데이터를 계속 보내지 않고도, 내 PC나 사내 서버에서 모델을 직접 실행할 수 있기 때문이다. 작은 모델은 노트북에서도 돌릴 수 있고, 큰 모델은 GPU 워크스테이션이나 Ollama Cloud로 넘겨 쓸 수 있다. 로컬에서 시작해 필요할 때만 클라우드로 확장하는 구조가 Ollama의 현재 방향이다.
이 글은 입력 자료의 핵심을 바탕으로 Ollama를 다시 정리한 위키 문서다. 공식 문서와 모델 라이브러리, GitHub 릴리스, 보안 리포트를 대조해 설치 방식, API 구조, 모델별 선택 기준, Cloud 요금제, 하드웨어 요구, 보안 주의점을 한 번에 볼 수 있게 구성했다.
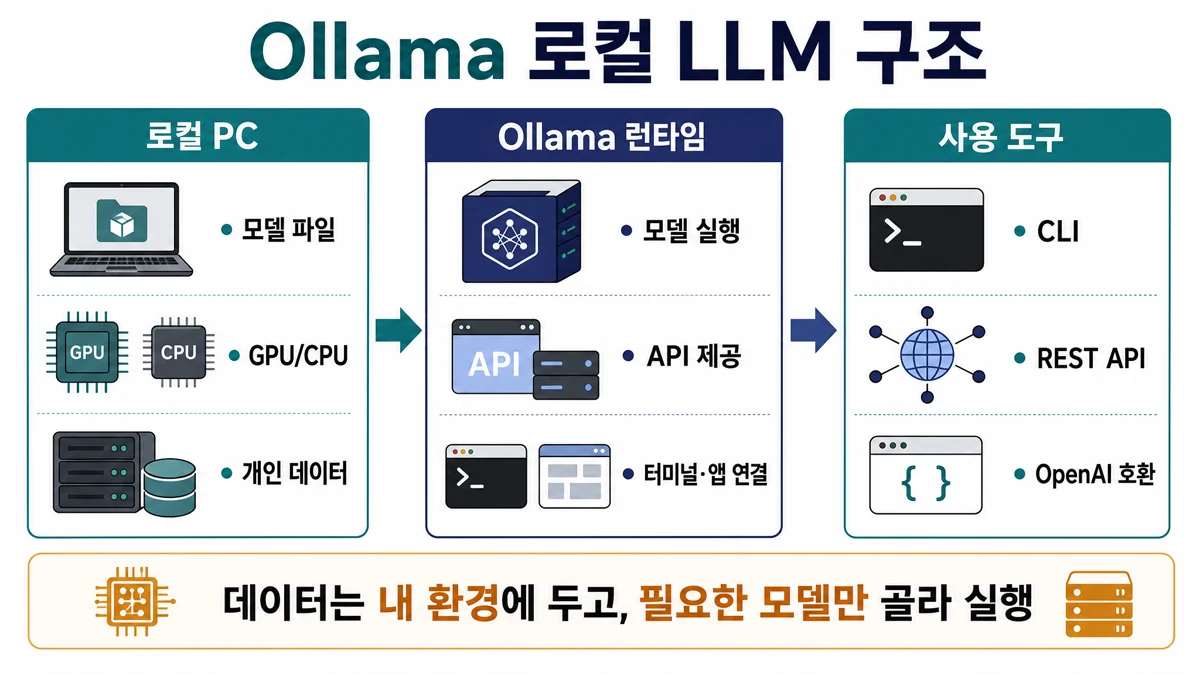 그림 1. Ollama가 로컬 PC의 모델 파일과 GPU·CPU를 런타임으로 묶어 CLI·REST API·앱 연결로 제공하는 흐름.
1. Ollama가 하는 일
Ollama의 핵심은 모델 실행을 패키지 관리처럼 단순하게 만드는 것이다. 사용자는 모델 파일을 직접 찾아 변환하고 서버를 띄우는 대신, 모델 이름을 지정해 내려받고 바로 대화하거나 API로 호출한다. 공식 문서는 Ollama를 gpt-oss, Gemma 4, DeepSeek-R1, Qwen3 같은 대형 모델을 실행하기 쉬운 방식으로 설명한다.
1.1. 로컬 런타임
- Ollama는 macOS, Windows, Linux에서 사용할 수 있다. Linux에서는 설치 스크립트, 데스크톱 환경에서는 다운로드 앱, 서버 환경에서는 Docker 이미지가 자주 쓰인다.
- 기본 로컬 API 주소는 http://localhost:11434/api 이다. 설치 후 Ollama가 실행 중이면 애플리케이션은 이 주소로 채팅, 텍스트 생성, 임베딩, 모델 목록 조회, 모델 내려받기를 요청할 수 있다.
- 모델 관리는 pull, run, list, show, rm 같은 명령으로 이뤄진다. 개발자 입장에서는 모델을 하나의 이름과 태그로 다루는 감각이 중요하다. 예를 들어 gpt-oss:20b, gemma4:12b, qwen3:8b처럼 모델군과 크기를 함께 지정한다.
1.2. API와 앱
- Ollama는 자체 API와 OpenAI 호환 API를 함께 제공한다. 기존 OpenAI SDK를 쓰는 도구는 base URL만 localhost:11434/v1 로 바꿔 Ollama 모델을 호출할 수 있다.
- OpenAI 호환 범위는 chat completions, responses, vision, tools, JSON mode, streaming, reasoning effort 등 주요 기능을 포함한다. 모든 OpenAI 기능을 완전히 대체한다는 뜻은 아니지만, 로컬 모델을 기존 앱에 붙이기에는 충분히 넓다.
- 공식 Python·JavaScript 라이브러리도 있다. 간단한 실험은 CLI로 시작하고, 앱 연동은 REST API나 라이브러리로 옮기는 흐름이 자연스럽다.
| 구분 | 핵심 기능 | 대표 사용 |
|---|---|---|
| CLI | 모델 실행·다운로드·삭제·앱 실행 | 개인 실험, 빠른 테스트 |
| 로컬 API | chat, generate, embed, tags, pull | 앱·RAG·자동화 연동 |
| OpenAI 호환 API | /v1/chat/completions, /v1/responses 등 | 기존 OpenAI SDK 기반 도구 전환 |
| 데스크톱 앱 | 대화형 사용, 모델 선택 | 비개발자·일반 사용자 |
| Cloud API | ollama.com을 원격 Ollama 호스트처럼 사용 | 큰 모델, 병렬 작업, 외부 GPU |
핵심 포인트: Ollama는 모델 자체를 더 똑똑하게 만드는 도구가 아니라, 모델을 가져오고 실행하고 앱에 연결하는 런타임이다. 그래서 좋은 모델 선택, 하드웨어, 보안 설정이 함께 맞아야 성능이 나온다.
2. 왜 로컬 LLM의 표준처럼 쓰이는가
Ollama가 빠르게 퍼진 이유는 기능이 많아서라기보다 첫 경험이 짧기 때문이다. 사용자는 설치 후 모델 이름을 입력하고 곧바로 대화를 시작한다. 모델 파일 형식, GPU 오프로딩, 서버 프로세스, API 라우팅을 처음부터 모두 이해할 필요가 없다.
2.1. 진입 장벽
- 가장 큰 장점은 명령 구조가 짧다는 점이다. 모델을 실행하고, 내려받고, API로 호출하는 흐름이 비교적 일관적이다.
- 모델 라이브러리가 크다. Llama, Gemma, Qwen, DeepSeek, Mistral, Phi, Granite, 임베딩 모델까지 한 곳에서 탐색할 수 있다. 모델 페이지에는 크기, 컨텍스트 길이, 입력 유형, Cloud 지원 여부가 표시된다.
- GitHub 프로젝트 규모도 크다. 2026년 6월 현재 ollama/ollama 저장소는 17만 개가 넘는 스타를 기록하고 있으며, 로컬 LLM 분야에서 개발자 인지도가 높다.
2.2. 프라이버시와 비용
- 로컬 실행은 입력 데이터가 내 장비 안에 머문다는 장점이 있다. 사내 문서 요약, 코드베이스 분석, 개인 자료 RAG처럼 외부 API 전송이 부담스러운 작업에 맞다.
- 자체 하드웨어에서 실행하는 만큼 토큰당 API 비용은 없다. 다만 GPU 전기료, 장비 비용, 모델 다운로드 저장 공간, 운영 시간이 비용으로 바뀐다.
- 로컬 모델은 인터넷이 끊겨도 쓸 수 있다. Ollama 홈페이지도 미션 크리티컬 작업은 완전히 오프라인으로 실행할 수 있다고 강조한다.
2.3. 한계도 분명하다
- 작은 모델은 빠르지만 성능 한계가 있다. 큰 모델은 정확도와 추론력이 좋지만 VRAM과 메모리를 많이 쓴다.
- 여러 사용자가 동시에 쓰는 서비스형 추론에는 vLLM, SGLang, TGI 같은 고성능 서빙 프레임워크가 더 어울릴 수 있다. Ollama는 편의성과 개발자 경험이 강점이지, 대규모 GPU 클러스터 최적화가 주목적인 도구는 아니다.
- 기본 보안 기능이 기업용 인증 서버처럼 완성돼 있다고 보면 안 된다. 인터넷에 노출할 경우 리버스 프록시, 인증, 방화벽, 모니터링을 별도로 붙여야 한다.
3. 설치와 기본 사용 흐름
처음 설치할 때는 운영체제와 사용 목적을 먼저 나눈다. 개인 PC에서 대화형으로 쓰려면 데스크톱 앱이 편하고, 서버나 자동화 파이프라인에 붙일 때는 Linux 또는 Docker 배포가 낫다.
3.1. 운영체제별 선택
- macOS는 공식 다운로드와 터미널 설치를 모두 제공한다. Apple Silicon에서는 Metal 가속을 활용할 수 있어 작은 모델부터 중형 모델까지 실험하기 좋다.
- Windows는 데스크톱 앱과 네이티브 실행이 쉬운 편이다. NVIDIA GPU가 있으면 CUDA 기반 성능을 기대할 수 있고, 최신 문서 기준으로 Vulkan 백엔드도 Windows·Linux에서 추가 GPU 지원을 맡는다.
- Linux는 서버 운영과 Docker 배포에 유리하다. NVIDIA GPU 컨테이너를 쓰려면 NVIDIA Container Toolkit이 필요하고, AMD GPU는 ROCm 또는 Vulkan 조건을 확인해야 한다.
| 환경 | 추천 방식 | 맞는 상황 | 확인할 것 |
|---|---|---|---|
| 개인 노트북 | 데스크톱 앱 또는 CLI | 채팅, 문서 요약, 모델 테스트 | RAM, 저장 공간, 발열 |
| 개발 PC | CLI + API | IDE, 코딩 에이전트, 로컬 RAG | GPU VRAM, 모델 크기 |
| 사내 서버 | Linux 서비스 | 팀 내부 API, 자동화 | 접근 제어, 로그, 방화벽 |
| 컨테이너 | Docker | 재현 가능한 배포 | GPU 패스스루, 볼륨, 포트 |
| 외부 GPU 필요 | Ollama Cloud | 큰 모델, 병렬 요청 | 요금제, 사용량, 데이터 정책 |
3.2. 첫 실행에서 확인할 것
- 모델 크기는 파일 크기와 거의 직결된다. 1B~4B급은 가볍고, 7B~14B는 개인용 기준에서 가장 많이 쓰이며, 30B 이상은 GPU·메모리 여유가 중요하다.
- 컨텍스트 길이는 길수록 좋기만 한 값이 아니다. 긴 문서를 넣으면 KV cache 메모리 사용이 커지고 응답 속도가 떨어질 수 있다. 문서 전체를 무조건 넣기보다 검색·요약·청크 전략을 함께 써야 한다.
- 같은 모델명이라도 태그가 다르면 용도가 달라질 수 있다. instruct, coder, vision, cloud, mlx, q4 같은 태그는 모델의 입력 방식·실행 위치·양자화·최적화 방식을 알려준다.
4. 모델 라이브러리 읽는 법
Ollama 모델 라이브러리는 단순 목록이 아니다. 모델명, 태그, 크기, 컨텍스트, 입력 유형, 도구 호출 지원, thinking 지원, cloud 지원을 함께 봐야 한다. 입력 자료에 나온 모델들도 이 관점으로 다시 정리할 필요가 있다.
4.1. 범용 채팅과 추론
- gpt-oss는 OpenAI의 오픈웨이트 모델군으로 Ollama에서 20B와 120B 계열을 제공한다. 모델 페이지 기준 128K 컨텍스트를 지원하며, reasoning, tools, cloud 태그가 붙어 있다. 20B는 로컬·저지연 용도, 120B는 더 큰 GPU나 Cloud 사용에 맞다.
- Gemma 4는 Google DeepMind의 오픈 모델 계열로, Ollama 페이지에서 텍스트·이미지 입력, thinking, tools, audio, cloud 태그가 확인된다. E2B·E4B는 엣지 배포, 12B·26B·31B는 워크스테이션급 작업에 맞는 식으로 나뉜다.
- DeepSeek-R1은 오픈 추론 모델 계열로 작은 증류 모델부터 큰 모델까지 폭이 넓다. 수학·코딩·논리 추론을 로컬에서 실험하려는 사용자에게 자주 선택된다.
4.2. 코딩과 에이전트
- Qwen3-Coder 계열은 코딩, 도구 사용, 긴 컨텍스트 에이전트 작업에 맞춰진 모델군이다. 코드 생성보다 코드베이스 탐색, 수정, 장기 작업을 맡길 때 후보가 된다.
- GLM-5.1, GLM-5, MiniMax M2.x, Kimi K2 계열처럼 cloud 태그가 붙은 대형 모델은 로컬 PC보다 Ollama Cloud에서 쓰는 모델로 이해하는 편이 안전하다. 일반 노트북에서 무리하게 돌릴 대상이 아니다.
- Mistral, Devstral, Codestral, CodeLlama, Granite Code 같은 계열은 특정 언어·코드베이스·상업 라이선스 조건을 함께 봐야 한다. 코딩 모델은 정확도만이 아니라 라이선스, 컨텍스트 길이, 도구 호출 안정성이 중요하다.
4.3. 비전·멀티모달·임베딩
- Gemma 4, Qwen3-VL, LLaVA, MiniCPM-V 같은 모델은 이미지 입력을 처리한다. 문서 OCR, 화면 설명, UI 스크린샷 분석에는 텍스트 모델보다 비전 모델이 맞다.
- 임베딩 모델은 답변을 직접 생성하기보다 문장을 벡터로 바꿔 검색에 쓴다. nomic-embed-text, Qwen3-Embedding, EmbeddingGemma, bge-m3, mxbai-embed-large 같은 모델은 로컬 RAG의 기반이 된다.
- OCR 특화 모델은 일반 비전 모델과 구분해야 한다. GLM-OCR, DeepSeek-OCR처럼 문서 구조와 텍스트 추출에 맞춘 모델은 PDF·스캔 문서 처리에서 더 안정적일 수 있다.
| 용도 | 먼저 볼 모델군 | 선택 기준 |
|---|---|---|
| 가벼운 개인 채팅 | Gemma 4 E2B/E4B, Qwen 소형, Llama 소형 | 응답 속도, RAM |
| 한국어 포함 범용 작업 | Qwen, Gemma, Llama, Mistral | 한국어 품질, 컨텍스트 |
| 코딩 에이전트 | Qwen3-Coder, gpt-oss, Devstral, Codestral | 도구 호출, 긴 작업 안정성 |
| 추론·수학 | gpt-oss, DeepSeek-R1, QwQ, Phi reasoning | thinking 지원, 지연 시간 |
| 이미지 이해 | Gemma 4, Qwen3-VL, LLaVA, MiniCPM-V | 이미지 해상도, OCR 능력 |
| RAG 검색 | nomic-embed-text, bge-m3, Qwen3-Embedding | 언어, 차원, 검색 품질 |
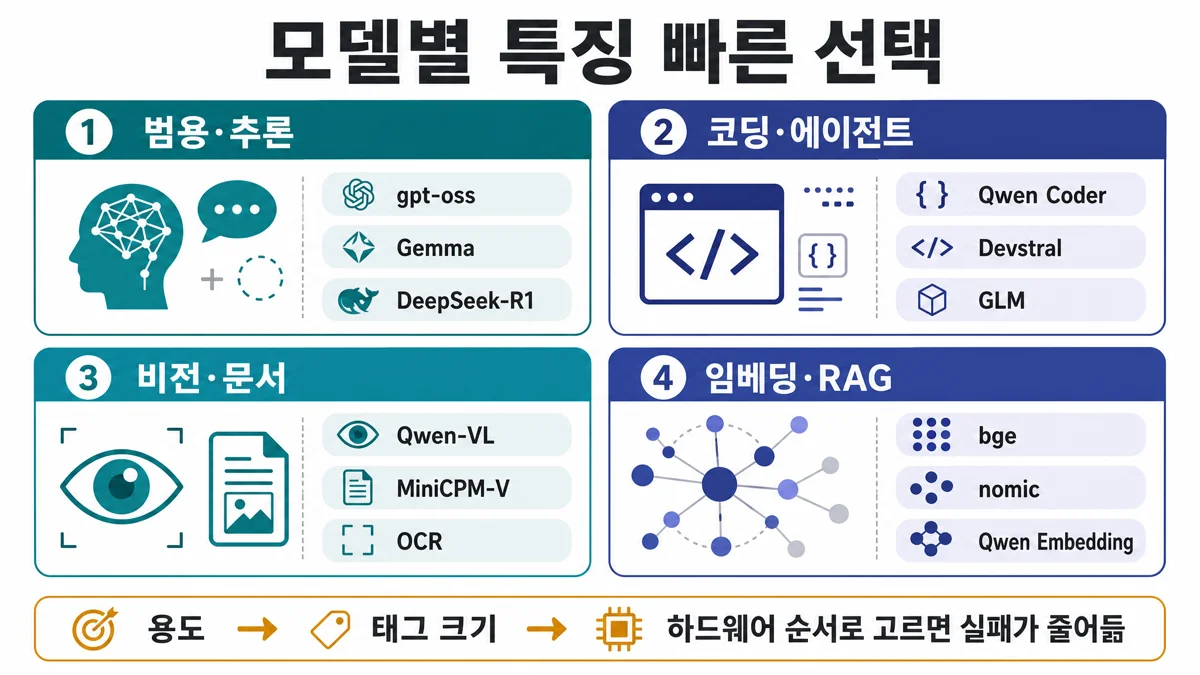 그림 3. 범용·추론, 코딩·에이전트, 비전·문서, 임베딩·RAG로 모델군을 나누어 고르는 빠른 선택표.
5. 각 모델별 특징 상세
Ollama 모델 라이브러리를 볼 때는 "무엇이 제일 좋다"보다 "어떤 작업에 맞는가"를 먼저 봐야 한다. 같은 오픈 모델이라도 로컬 채팅, 코딩 에이전트, 이미지 이해, 임베딩 검색, 문서 OCR에 맞는 모델이 다르다. 아래 표는 입력 자료에 나온 주요 모델군과 Ollama 라이브러리에서 자주 확인되는 모델을 목적별로 다시 정리한 것이다.
5.1. 범용·추론 모델
- gpt-oss는 OpenAI의 오픈웨이트 추론 모델군이다. Ollama에서는 20B와 120B 계열을 중심으로 쓰며, 모델 페이지 기준 tools, thinking, cloud 태그가 붙는다. 20B는 로컬 실험과 낮은 지연 시간에 맞고, 120B는 단일 고성능 GPU나 Cloud 사용을 전제로 보는 편이 안전하다. 코드 설명, 논리 추론, 에이전트 작업, 구조화 출력이 필요한 워크플로에 잘 맞는다.
- Gemma 4는 Google DeepMind 계열의 멀티모달 오픈 모델군이다. E2B·E4B는 엣지와 노트북, 12B·26B·31B는 워크스테이션급 작업에 어울린다. 텍스트와 이미지 입력을 함께 다루고, 일부 모델은 오디오·thinking·tools 태그까지 포함한다. 이미지가 섞인 문서 이해, 제품 스크린샷 분석, 로컬 범용 비서에 쓰기 좋다.
- DeepSeek-R1은 추론 중심 모델군이다. 작은 증류 모델부터 큰 모델까지 폭이 넓어 수학, 논리, 코드 추론을 로컬에서 시험하기 좋다. 다만 reasoning 모델은 일반 채팅보다 응답이 길어지고 지연 시간이 늘 수 있으므로, 짧은 질의 응답에는 소형 범용 모델이 더 효율적일 때가 많다.
- Qwen3 / Qwen3.5 / Qwen3.6 계열은 다국어, 긴 컨텍스트, 코딩, 멀티모달 라인업이 넓은 것이 장점이다. 한국어와 영어가 섞인 기술 문서, 코드 설명, 화면 이해, 에이전트 작업을 한 모델군 안에서 비교하기 쉽다. 태그별 차이가 크므로 단순히 Qwen이라는 이름보다 coder, vl, embedding, thinking 여부를 확인해야 한다.
| 모델군 | 강점 | 적합한 작업 | 주의할 점 |
|---|---|---|---|
| gpt-oss | 추론, tools, 구조화 출력 | 코딩 보조, 에이전트, 논리 작업 | 큰 모델은 Cloud 또는 고성능 GPU 필요 |
| Gemma 4 | 멀티모달, 온디바이스, 긴 컨텍스트 | 이미지 포함 문서, 로컬 비서, OCR 보조 | 모델 크기별 입력 모달리티 확인 필요 |
| DeepSeek-R1 | 단계적 추론, 수학·코드 문제 | 계산, 알고리즘, 논리 검토 | 응답 길이와 지연 시간 증가 가능 |
| Qwen3 계열 | 다국어, 코딩, 비전, 임베딩 폭 | 한국어·영어 혼합 작업, RAG, 에이전트 | 태그별 용도가 크게 다름 |
5.2. 코딩·에이전트 모델
- Qwen3-Coder는 코드 생성만이 아니라 코드베이스 탐색, 다중 파일 수정, 도구 사용을 염두에 둔 모델군이다. 긴 컨텍스트와 tool calling이 중요할 때 후보가 된다. 로컬 개발 도구에 붙일 때는 작은 모델로 빠른 수정, 큰 cloud 모델로 장기 작업을 나눠 쓰는 구성이 현실적이다.
- Devstral / Codestral / Mistral 계열은 코드 이해와 소프트웨어 엔지니어링 작업에서 자주 거론된다. Mistral 계열은 소형부터 대형까지 폭이 있고, Devstral은 SWE 스타일의 코드베이스 작업에 초점을 둔다. 라이선스와 상업 사용 조건이 모델별로 다를 수 있어 서비스에 넣기 전 확인이 필요하다.
- GLM-5.1 / GLM-5 / GLM-4.7-Flash는 에이전트 엔지니어링과 장기 작업을 강조하는 모델군으로 분류할 수 있다. GLM-5.1 같은 대형 cloud 모델은 일반 노트북용이 아니라 복잡한 코딩 자동화, 긴 계획 수립, 시스템 단위 변경 검토에 더 어울린다. GLM-4.7-Flash처럼 더 가벼운 라인은 속도와 비용 균형을 볼 때 후보가 된다.
- MiniMax M2.x는 코딩, 실무 생산성, agentic workflow를 강조하는 라인이다. 입력 자료에 나온 M2.1·M2.5·M2.7 같은 모델은 클라우드 기반 대형 작업 후보로 보는 것이 안전하다. 긴 작업을 맡길 때는 한 번에 모든 파일을 던지기보다 목표, 제약, 검증 명령을 나눠 주는 방식이 좋다.
- Kimi K2 계열은 긴 컨텍스트와 에이전트 작업을 강점으로 내세우는 모델군이다. 장문 코드 리뷰, 여러 단계의 계획, 디자인·코딩 혼합 작업에 맞지만, 모델 크기와 실행 위치를 확인해야 한다. cloud 태그가 붙은 모델은 로컬 실행보다 Ollama Cloud 사용을 우선 고려한다.
| 모델군 | 성격 | 잘 맞는 작업 | 운영 팁 |
|---|---|---|---|
| Qwen3-Coder | 코딩 에이전트 | 코드 수정, 브라우저·도구 사용 | context와 tools 태그 확인 |
| Devstral/Codestral | 코드베이스 작업 | 다중 파일 편집, SWE 작업 | 라이선스와 모델 크기 확인 |
| GLM-5.1/GLM-5 | 장기 에이전트 | 큰 계획, 복잡한 시스템 변경 | Cloud 모델로 보는 편이 현실적 |
| MiniMax M2.x | 생산성·코딩 | 실무 자동화, 코딩 워크플로 | 검증 단계를 프롬프트에 포함 |
| Kimi K2 | 긴 컨텍스트 | 장문 분석, 장기 계획 | 실행 위치와 사용량 확인 |
5.3. 비전·멀티모달 모델
- Qwen3-VL은 Qwen 계열의 비전-언어 모델이다. 이미지 속 텍스트, 화면 구성, 도표, UI를 언어로 설명해야 할 때 후보가 된다. 단순 OCR 전용이라기보다 이미지 이해와 추론을 함께 맡기는 용도에 가깝다.
- Gemma 4 비전 모델은 이미지와 텍스트를 함께 다루는 범용 멀티모달 작업에 적합하다. 제품 이미지 설명, 문서 화면 요약, 시각 자료 기반 질의 응답처럼 정확한 설명과 일반 추론이 함께 필요한 작업에 맞다.
- MiniCPM-V는 경량 멀티모달 모델군으로 분류된다. 스마트폰이나 노트북 같은 제한된 환경에서 이미지 이해를 시험할 때 후보가 된다. 아주 복잡한 문서 OCR보다 빠른 화면 설명, 간단한 이미지 질의 응답에 더 잘 맞는 편이다.
- LLaVA 계열은 오래된 대표 오픈 비전 모델군이다. 최신 모델보다 성능이 항상 앞선다고 보기는 어렵지만, 예제와 커뮤니티 자료가 많아 비전 LLM 구조를 실험하기 좋다.
5.4. OCR·문서 처리 모델
- GLM-OCR은 복잡한 문서 이해와 OCR에 초점을 둔 모델군이다. 표, 다단 문서, PDF 페이지처럼 단순 이미지 캡션보다 구조 추출이 중요한 경우 후보가 된다.
- DeepSeek-OCR은 문서 이미지를 토큰 효율적으로 처리하는 OCR 계열로 정리할 수 있다. 입력 자료처럼 "텍스트를 이미지로 압축해 토큰을 줄인다"는 접근은 긴 문서 처리 비용을 줄이는 데 의미가 있다.
- MedGemma는 의료 텍스트·영상 이해에 특화된 Gemma 기반 모델군이다. 일반 건강 정보 요약에는 참고 모델로 쓸 수 있지만, 의료 판단이나 진단을 자동화하는 용도로 쓰면 안 된다. 임상 결정은 전문가 검증이 필요하다.
- TranslateGemma와 FunctionGemma는 범용 채팅보다 특정 기능에 맞춘 모델이다. TranslateGemma는 번역, FunctionGemma는 작은 함수 호출 분류나 로컬 라우팅 보조처럼 제한된 작업에 어울린다.
5.5. 임베딩·RAG 모델
- nomic-embed-text는 Ollama에서 가장 널리 쓰이는 오픈 임베딩 모델 중 하나다. 문서 검색, 개인 지식베이스, 로컬 RAG의 기본 후보로 좋다.
- bge-m3 / bge-large는 다국어 검색과 다양한 길이의 텍스트 검색에 강점이 있다. 한국어·영어 문서가 섞인 지식베이스라면 bge-m3를 후보에 넣을 만하다.
- Qwen3-Embedding은 Qwen 계열 기반의 임베딩·랭킹 모델군이다. Qwen 채팅 모델과 함께 쓰면 모델군을 맞추기 쉽고, 다국어 검색 품질을 비교하기 좋다.
- EmbeddingGemma는 온디바이스 RAG에 어울리는 경량 임베딩 모델이다. 작은 앱이나 개인 노트 검색처럼 속도와 배포 크기가 중요한 경우 후보가 된다.
- mxbai-embed-large, snowflake-arctic-embed, all-minilm, paraphrase-multilingual, granite-embedding은 각각 대형 임베딩, 엔터프라이즈 검색, 초경량 검색, 다국어 의미 검색, IBM Granite 생태계 연동에 맞춰 비교할 수 있다.
| 모델군 | 역할 | 추천 상황 | 피해야 할 사용 |
|---|---|---|---|
| nomic-embed-text | 범용 임베딩 | 개인 RAG, 문서 검색 | 답변 생성 모델로 오해 |
| bge-m3 | 다국어 검색 | 한국어·영어 혼합 문서 | 짧은 분류 작업에 과한 구성 |
| Qwen3-Embedding | Qwen 기반 검색 | Qwen 채팅 모델과 조합 | 채팅 모델 대체 |
| EmbeddingGemma | 경량 임베딩 | 온디바이스 RAG | 대규모 엔터프라이즈 검색 단독 사용 |
| mxbai/bge/snowflake 계열 | 검색 품질 비교 | 검색 랭킹 실험 | 모델명만 보고 무검증 선택 |
5.6. 선택을 빠르게 끝내는 기준
- 문장만 처리하면 범용 텍스트 모델을 고른다. 처음에는 Gemma, Qwen, Llama, Mistral의 7B~14B급이 무난하다.
- 코드를 고치거나 도구를 쓰게 할 것이면 coder, tools, thinking 태그를 먼저 본다. Qwen3-Coder, gpt-oss, Devstral, GLM, MiniMax 같은 모델군이 후보가 된다.
- 이미지나 화면이 들어가면 vision 태그가 있는 모델을 고른다. Qwen3-VL, Gemma 4, MiniCPM-V, LLaVA 계열을 비교한다.
- 문서를 검색해 답하게 할 것이면 채팅 모델보다 임베딩 모델을 먼저 정한다. RAG에서는 검색 품질이 답변 품질의 절반 이상을 차지한다.
- 큰 모델이 필요하지만 장비가 부족하면 cloud 태그가 있는 모델을 쓴다. 로컬에서 무리하게 대형 모델을 돌리는 것보다 비용과 시간을 예측하기 쉽다.
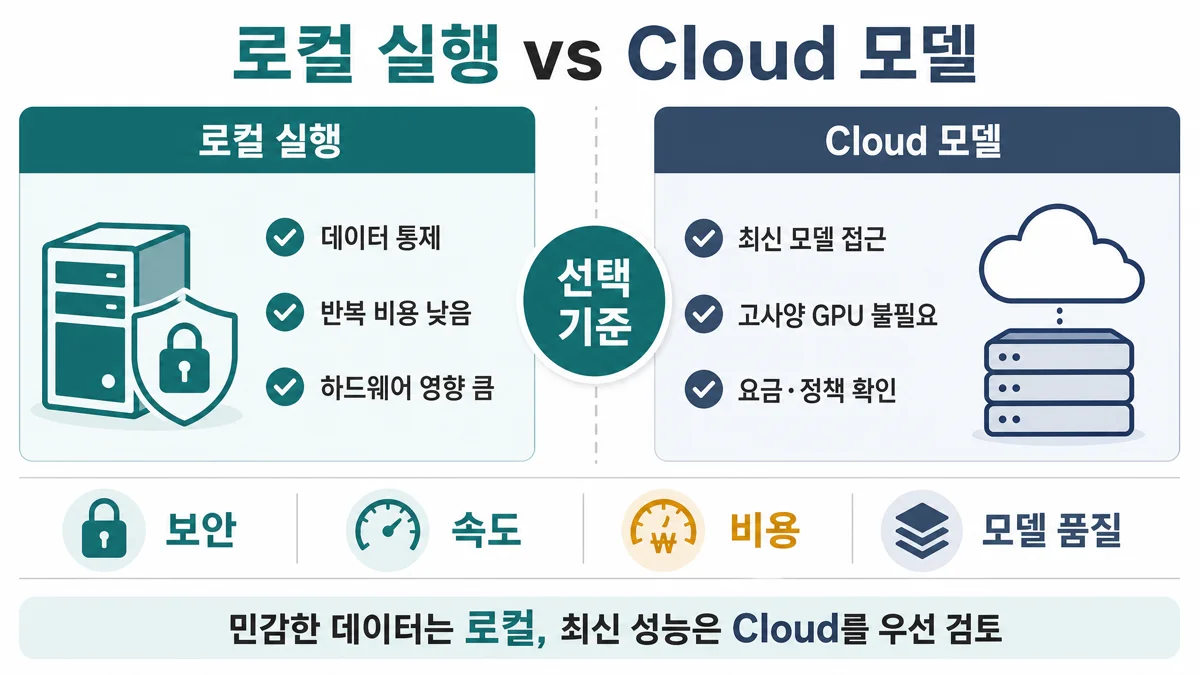 그림 2. 민감한 데이터와 반복 비용은 로컬 실행, 최신 성능과 고사양 모델 접근은 Cloud 모델을 우선 검토하는 선택 기준.
6. Ollama Cloud의 의미
Ollama Cloud는 로컬 Ollama 경험을 유지하면서 원격 GPU에서 큰 모델을 돌리게 해주는 기능이다. 로컬 API를 쓰는 것처럼 cloud 태그가 붙은 모델을 호출하거나, ollama.com API를 원격 호스트처럼 직접 사용할 수 있다.
6.1. 로컬과 Cloud의 연결
- 사용자는 gpt-oss:120b-cloud 같은 모델을 pull한 뒤 로컬 API로 호출할 수 있다. 로컬 앱은 그대로 두고 실제 추론만 Ollama Cloud가 맡는 식이다.
- ollama.com API를 직접 쓰려면 API key가 필요하다. 이 경우 https://ollama.com/api 가 원격 Ollama 호스트 역할을 한다.
- Cloud는 큰 모델, 병렬 요청, 최신 정보가 필요한 웹 검색 작업에 의미가 있다. 로컬 GPU가 작아도 대형 모델을 테스트할 수 있다는 점이 강하다.
6.2. 요금제와 데이터 정책
- 공식 가격 페이지 기준 Free는 0달러이며 로컬 실행, 공개 모델, CLI·API·데스크톱 앱, 일부 Cloud 모델 접근을 포함한다.
- Pro는 월 20달러 또는 연 200달러이며 Free보다 50배 많은 Cloud 사용량과 3개 동시 Cloud 모델 실행을 제공한다.
- Max는 월 100달러이며 Pro보다 5배 많은 사용량과 10개 동시 Cloud 모델 실행을 제공한다.
- Ollama는 Cloud 사용량을 고정 토큰 수가 아니라 GPU 시간 중심의 실제 인프라 사용량으로 설명한다. 또 가격 페이지에서 prompt와 response 데이터를 학습에 쓰지 않고, 협력 호스팅 제공자에게도 no logging, no training, zero data retention 정책을 요구한다고 밝힌다.
| 플랜 | 월 요금 | 동시 Cloud 모델 | 적합한 사용 |
|---|---|---|---|
| Free | 0달러 | 1개 | 로컬 위주, 큰 모델 가벼운 평가 |
| Pro | 20달러 | 3개 | 일상 작업, 코딩 자동화, 리서치 |
| Max | 100달러 | 10개 | 지속 에이전트, 병렬 작업, 대형 모델 장시간 사용 |
7. API 연동과 개발 워크플로
Ollama를 앱에 붙일 때는 자체 API를 쓸지, OpenAI 호환 API를 쓸지 먼저 정한다. 새로 만드는 앱이면 Ollama API가 직관적이고, 이미 OpenAI SDK로 짜인 앱이면 호환 API가 빠르다.
7.1. 자체 API
- chat은 대화 메시지 배열을 받아 다음 assistant 응답을 만든다. 일반 챗봇, 에이전트, 멀티턴 상담에 가장 많이 쓰인다.
- generate는 단일 prompt 기반 생성에 맞다. 간단한 텍스트 변환, 요약, 분류 작업에 붙이기 쉽다.
- embed는 입력 텍스트를 벡터로 바꾼다. RAG에서는 문서를 청크로 나눈 뒤 embed로 벡터화하고, 질문도 같은 임베딩 모델로 벡터화해 가까운 문서를 찾는다.
7.2. OpenAI 호환 API
- base URL을 http://localhost:11434/v1/ 로 바꾸고 api key에는 임의 값을 넣는 방식으로 OpenAI SDK 예제를 거의 그대로 쓸 수 있다. 로컬 모드에서는 key가 요구되지만 실제 인증에는 쓰이지 않는다.
- vision 입력, tools, JSON mode, reasoning effort까지 지원 범위가 넓어졌다. 특히 코딩 에이전트, 자동화 도구, 브라우저 사용 에이전트가 Ollama 모델을 실험하기 쉬워졌다.
- 다만 호환 API는 부분 호환이다. 운영 전에 사용 중인 필드, 스트리밍 응답 형식, tool call 결과, 오류 처리 방식을 실제 모델로 검증해야 한다.
7.3. 코딩 도구 통합
- 공식 Quickstart는 OpenClaw, Claude Code, Codex, OpenCode 같은 도구를 ollama launch 명령으로 실행하는 흐름을 안내한다.
- 이 통합은 단순 채팅보다 실무 영향이 크다. 모델이 코드 수정, 파일 탐색, 명령 실행, 웹 검색을 함께 수행하면 로컬 LLM이 개인 개발 워크플로 안으로 들어온다.
- 코딩 도구에 붙일 모델은 모델 지능뿐 아니라 도구 호출 안정성, 긴 컨텍스트 처리, 실패 후 복구 능력이 중요하다. 작은 모델로는 간단한 수정, 큰 cloud 모델로는 긴 리팩터링을 맡기는 식의 분업이 현실적이다.
8. 하드웨어와 성능 기준
Ollama 성능은 모델 크기, 양자화, 컨텍스트 길이, GPU 종류, 메모리 대역폭에 크게 좌우된다. 같은 모델이라도 CPU만 쓰는 노트북과 RTX 4090 데스크톱에서는 체감이 완전히 다르다.
8.1. GPU 지원
- NVIDIA는 공식 하드웨어 문서 기준 compute capability 5.0 이상을 지원한다. 일부 구세대 GPU는 최신 드라이버 조건이 더 까다롭다.
- AMD는 Linux에서 ROCm v7 기반 지원이 핵심이며, Windows도 HIP7 capable driver stack 조건을 확인해야 한다. 추가로 Vulkan 백엔드가 Windows와 Linux에서 GPU 지원 범위를 넓힌다.
- Apple GPU는 Metal API로 가속된다. Apple Silicon Mac은 소형·중형 모델 실험에 편하고 전력 효율도 좋다.
8.2. 모델 크기 감각
- 1B~4B 모델은 빠르지만 어려운 추론이나 긴 코드 작업에는 한계가 있다. 대신 분류, 간단 요약, 로컬 자동완성, 가벼운 챗봇에 좋다.
- 7B~14B 모델은 개인 PC에서 가장 균형이 좋다. 한국어 대화, 일반 요약, RAG 답변, 간단한 코딩에 쓸 수 있다.
- 20B~32B 모델은 품질이 올라가지만 VRAM 압박이 커진다. 24GB급 GPU 이상이 있거나 양자화를 적극 활용해야 한다.
- 70B 이상 또는 100B급 모델은 개인 PC보다 서버 GPU나 Cloud가 현실적이다. 모델 페이지에 cloud 태그가 붙은 경우에는 로컬보다 Cloud 사용을 먼저 고려한다.
| 모델 크기 | 체감 위치 | 추천 작업 |
|---|---|---|
| 1B~4B | 가볍고 빠름 | 분류, 짧은 요약, 엣지 자동화 |
| 7B~14B | 개인용 균형점 | 일반 채팅, RAG, 초안 작성 |
| 20B~32B | 고품질 로컬 | 코딩, 추론, 긴 문서 |
| 70B 이상 | 고사양·Cloud | 복잡한 에이전트, 장문 추론 |
| 임베딩 300M~8B | 검색 전용 | 문서 검색, RAG, 추천 |
9. 보안 운영에서 가장 조심할 점
Ollama는 기본적으로 로컬 실행 도구다. 그래서 안전하게 쓰려면 "내 컴퓨터 안에서만 접근 가능하게 둔다"는 전제가 중요하다. 문제는 서버 배포나 Docker 설정 과정에서 0.0.0.0으로 열어 인터넷에 노출하는 순간 생긴다.
9.1. 공개 노출 위험
- 2026년 1월 The Hacker News는 SentinelOne과 Censys 조사 결과를 인용해 130개국에서 17만 5천 개의 공개 Ollama 호스트가 관찰됐다고 보도했다. 기사에 따르면 상당수는 cloud와 residential network에 흩어진 비관리 AI 컴퓨트 인프라였다.
- 같은 보도는 Ollama가 기본적으로 127.0.0.1:11434에 바인딩되지만, 0.0.0.0이나 public interface로 바꾸면 외부에서 접근할 수 있다고 설명했다.
- tool calling을 켠 모델은 단순 텍스트 생성보다 위험하다. 모델이 API, 파일, 명령, 외부 시스템과 이어져 있으면 노출된 엔드포인트가 실제 작업 권한으로 이어질 수 있다.
9.2. 취약점과 업데이트
- 2024년 Wiz Research는 CVE-2024-37032, 일명 Probllama를 공개했다. 이 취약점은 악성 manifest와 path traversal을 통해 파일 덮어쓰기와 원격 코드 실행으로 이어질 수 있었고, Ollama 0.1.34 이상으로 업데이트하라고 권고됐다.
- 이 사례는 오래된 버전 방치와 인터넷 노출이 결합될 때 위험이 커진다는 점을 보여준다. 로컬 AI 서버도 웹 서버처럼 업데이트, 접근 제어, 로그 확인이 필요하다.
- 2026년 6월 GitHub Releases 기준 Ollama 최신 릴리스는 v0.30.7이다. 실제 운영 전에는 GitHub Releases와 공식 다운로드 페이지에서 최신 버전을 다시 확인하는 것이 안전하다.
9.3. 최소 보안 체크리스트
- 개인 PC에서는 localhost 바인딩을 유지한다. 외부 접속이 필요 없다면 포트 11434를 인터넷에 열지 않는다.
- 팀 내부에서 공유할 때는 VPN, 방화벽, 리버스 프록시 인증, IP allowlist를 붙인다. 공개 인터넷에 그대로 두는 구성은 피한다.
- Docker에서는 포트 매핑을 신중히 한다. -p 11434:11434는 호스트 인터페이스 정책에 따라 외부 노출로 이어질 수 있다.
- tool calling, 파일 접근, 쉘 실행 권한이 있는 에이전트는 별도 샌드박스와 계정 권한 분리를 둔다.
- 모델 파일과 프롬프트 로그에 민감정보가 남지 않도록 저장 경로, 백업, 로그 정책을 정한다.
10. 상황별 선택 기준
Ollama는 "무조건 로컬"도 아니고 "Cloud가 정답"도 아니다. 목적과 장비에 따라 나눠 쓰는 편이 실용적이다.
10.1. 개인 사용자
- 처음에는 4B~8B급 모델로 시작한다. 설치, 모델 다운로드, API 호출, 응답 속도를 확인한 뒤 크기를 키우는 순서가 좋다.
- 문서 요약과 개인 지식 검색은 임베딩 모델을 함께 붙이면 품질이 오른다. 단순히 긴 문서를 통째로 넣는 것보다 RAG 구조가 안정적이다.
- 큰 모델을 가끔만 쓴다면 GPU 업그레이드보다 Cloud 모델이 비용 면에서 나을 수 있다.
10.2. 개발자와 1인 서비스
- 로컬에서는 작은 모델로 빠른 분류, 초안, 테스트를 처리한다. 비용이 들지 않아 반복 실험에 좋다.
- 코드 수정이나 긴 에이전트 작업은 gpt-oss, Qwen3-Coder, Devstral, GLM, MiniMax 같은 모델군을 비교한다. 단, 큰 모델은 Cloud 태그와 사용량을 먼저 확인한다.
- OpenAI SDK 기반 앱은 Ollama 호환 API로 프로토타입을 빠르게 만들 수 있다. 운영 전에는 응답 품질과 오류 형식을 별도로 검증한다.
10.3. 회사와 팀
- 사내 데이터가 핵심이면 로컬 또는 사내 서버 배포가 유리하다. 다만 사내망이라고 해서 인증을 생략하면 안 된다.
- 팀원이 여러 명이면 동시 요청, 큐 대기, GPU 점유, 모델별 메모리 사용량을 모니터링해야 한다.
- 외부 Cloud 모델을 쓰는 경우 데이터 정책과 지역, 로그 보존 여부, 사용량 제한을 문서화한다. Ollama 가격 페이지의 정책은 좋은 출발점이지만, 조직 보안 기준에는 별도 검토가 필요하다.
| 상황 | 추천 구성 | 피해야 할 선택 |
|---|---|---|
| 노트북 개인 실험 | 소형 모델 + 데스크톱 앱 | 처음부터 70B 모델 다운로드 |
| 로컬 RAG | 임베딩 모델 + 7B~14B 채팅 모델 | 문서 전체를 매번 프롬프트에 삽입 |
| 코딩 자동화 | tools 지원 모델 + 샌드박스 | 권한 큰 에이전트 공개 노출 |
| 대형 추론 | Cloud 모델 또는 서버 GPU | CPU만으로 대형 모델 운영 |
| 팀 내부 API | VPN·인증·방화벽 | 0.0.0.0 공개 바인딩 |
11. 공식 확인 링크
Ollama 관련 정보는 모델과 요금제, 지원 기능이 빠르게 바뀐다. 아래 링크를 기준으로 최신 상태를 다시 확인하는 습관이 필요하다.
| 확인 항목 | 링크 |
|---|---|
| 공식 홈페이지 | https://ollama.com/ |
| 공식 문서 | https://docs.ollama.com/ |
| 모델 라이브러리 | https://ollama.com/library |
| API 소개 | https://docs.ollama.com/api/introduction |
| OpenAI 호환 API | https://docs.ollama.com/api/openai-compatibility |
| Cloud 문서 | https://docs.ollama.com/cloud |
| 가격 정책 | https://ollama.com/pricing |
| 하드웨어 지원 | https://docs.ollama.com/gpu |
| Docker 배포 | https://docs.ollama.com/docker |
| GitHub Releases | https://github.com/ollama/ollama/releases |
| Probllama 보안 리포트 | https://www.wiz.io/blog/probllama-ollama-vulnerability-cve-2024-37032 |
| 공개 노출 보안 보도 | https://thehackernews.com/2026/01/researchers-find-175000-publicly.html |
12. 마무리
앞에서 다룬 Ollama의 핵심만 짧게 정리한다.
- Ollama는 로컬 LLM 실행 도구에서 Cloud, 앱 실행, OpenAI 호환 API까지 확장된 오픈 모델 플랫폼에 가깝다.
- 처음에는 작은 모델로 설치와 API 흐름을 익히고, 품질이 필요할 때 모델 크기나 Cloud 사용을 늘리는 방식이 현실적이다.
- 모델 선택은 이름보다 태그, 크기, 컨텍스트 길이, 입력 모달리티, tools·thinking·cloud 지원 여부를 함께 봐야 한다.
- RAG는 채팅 모델만으로 끝나지 않는다. 임베딩 모델, 문서 분할, 검색 품질이 답변 품질을 좌우한다.
- Ollama Cloud는 큰 모델과 병렬 작업에는 편하지만, 사용량·요금·데이터 정책을 공식 페이지에서 다시 확인해야 한다.
- 보안에서는 11434 포트 공개 노출을 피하고, 외부 접근이 필요하면 인증·방화벽·리버스 프록시를 붙여야 한다.
- 최신 릴리스와 모델 목록은 자주 바뀌므로 운영 전 공식 문서와 GitHub Releases를 확인한다.
「Ollama는 로컬에서 시작하는 도구지만, 운영 기준은 서버처럼 잡아야 한다.」 개인 실험은 가볍게 시작해도 된다. 다만 팀과 서비스에 붙이는 순간 모델 품질, 비용, 보안, 업데이트 책임까지 함께 설계해야 오래 간다.
자주 묻는 질문
- Ollama는 ChatGPT 같은 서비스인가요?
Ollama는 ChatGPT처럼 하나의 완성된 챗봇 서비스라기보다, 여러 오픈 모델을 로컬이나 Cloud에서 실행하게 해주는 런타임입니다. 사용자는 모델을 직접 고르고, CLI·데스크톱 앱·API로 호출하며, 필요하면 기존 애플리케이션에 붙여 씁니다.
- Ollama를 쓰면 데이터가 외부로 나가지 않나요?
로컬 모델을 실행하면 프롬프트와 응답은 기본적으로 내 장비에서 처리됩니다. 다만 Cloud 모델, 웹 검색 API, 외부 도구 호출을 쓰면 네트워크 요청이 발생하므로 작업별로 어떤 기능을 쓰는지 구분해야 합니다.
- 처음 설치하면 어떤 모델부터 써보는 것이 좋나요?
처음에는 4B~8B급 경량 모델로 설치와 속도를 확인하는 편이 좋습니다. 이후 문서 요약, 코딩, 이미지 이해, RAG처럼 목적이 분명해지면 Gemma, Qwen, gpt-oss, DeepSeek, 임베딩 모델 등으로 나눠 비교하는 것이 효율적입니다.
- Ollama Cloud는 로컬 실행과 어떻게 다른가요?
로컬 실행은 내 CPU·GPU·메모리로 모델을 돌리고, Cloud는 Ollama의 원격 GPU 인프라에서 큰 모델을 실행합니다. 로컬 API 흐름을 유지하면서 cloud 태그가 붙은 모델을 사용할 수 있어, 큰 모델을 가끔 쓰는 사용자에게 특히 편합니다.
- OpenAI SDK로 만든 앱을 Ollama에 연결할 수 있나요?
가능합니다. Ollama는 OpenAI API의 일부와 호환되는 엔드포인트를 제공하므로 base URL을 localhost:11434/v1 로 바꾸는 방식으로 기존 SDK 기반 앱을 시험할 수 있습니다. 다만 모든 필드가 완전 동일한 것은 아니어서 운영 전 검증이 필요합니다.
- Ollama를 인터넷에 공개해도 괜찮나요?
권장되지 않습니다. Ollama는 기본적으로 localhost 접근을 전제로 쓰는 도구이며, 외부에 열 때는 인증, 방화벽, VPN, 리버스 프록시 같은 보호 장치가 필요합니다. 특히 tool calling이 켜진 에이전트는 더 강한 접근 제어가 필요합니다.
- 로컬 RAG를 만들 때 채팅 모델만 있으면 되나요?
채팅 모델만으로도 긴 문서를 넣어 답하게 할 수 있지만, 안정적인 RAG에는 임베딩 모델이 거의 필수입니다. 문서를 작은 조각으로 나누고 임베딩한 뒤 질문과 가까운 조각만 채팅 모델에 넣어야 속도와 정확도가 함께 좋아집니다.
- NVIDIA GPU가 없으면 Ollama를 쓸 수 없나요?
쓸 수는 있습니다. CPU 실행, Apple Metal, AMD ROCm, Vulkan 지원 같은 선택지가 있습니다. 다만 큰 모델은 GPU 가속이 없으면 매우 느릴 수 있으므로, 장비가 약할수록 작은 모델이나 Cloud 모델을 고려하는 것이 좋습니다.
- Ollama와 LM Studio, vLLM은 어떻게 다르게 봐야 하나요?
Ollama는 CLI·API·모델 관리와 개발 도구 통합이 강한 런타임입니다. LM Studio는 데스크톱 GUI 경험이 강하고, vLLM은 대규모 동시 추론 서버에 더 초점이 있습니다. 개인 실험, 앱 연동, 대규모 서빙 중 어디가 목표인지에 따라 선택이 달라집니다.
- 운영 중인 Ollama 버전은 왜 자주 확인해야 하나요?
모델 실행 도구는 기능 변화도 빠르고 보안 이슈도 발생할 수 있습니다. 과거 CVE-2024-37032처럼 업데이트로 해결된 취약점 사례가 있었기 때문에, GitHub Releases와 공식 다운로드 페이지를 기준으로 최신 버전을 유지하는 것이 안전합니다.
- Ollama 모델을 고를 때 모델명보다 먼저 봐야 할 기준은 무엇인가요?
모델명보다 태그와 용도를 먼저 봐야 합니다. 채팅이면 범용 텍스트 모델, 코딩이면 coder·tools 태그, 이미지가 있으면 vision 태그, RAG면 임베딩 모델을 고르는 식입니다. 같은 Qwen이나 Gemma 계열이라도 크기와 태그가 다르면 실행 위치와 적합한 작업이 크게 달라집니다.