 테크·IT
코딩 에이전트가 멀티파일 편집·도구 호출·장시간 추론까지 맡게 되면서, 어떤 벤치마크를 믿을지가 실무 선택의 핵심이 됐다. SWE-bench Verified 점수만으로 모델을 고르던 시대는 지났다. Cursor는 2026년 3월 블로그 How we compare model quality in Cursor에서 자체 평가 체계 CursorBench를 공개했고, 현재 프로덕션 버전은 CursorBench 3.1이다. 공식 리더보드는 cursor.com/cursorbench에서 확인할 수 있다.
여기서는 CursorBench가 왜 만들어졌는지, 공개 벤치마크의 한계, 3.1 버전의 과제 구성, 2026년 7월 2일 기준 36개 모델 순위, 가족별 특징, 비용 대비 성능 해석까지 한 번에 정리한다. Cursor IDE 사용자가 모델을 고를 때 참고용으로 쓰면 된다.
1. 이 글의 읽는 순서
- CursorBench가 무엇인지 — SWE-bench와 무엇이 다른지부터 본다.
- 왜 만들었는지 — 공개 벤치마크의 정렬·채점·오염 한계를 이해한다.
- 3.1 리더보드 — 36개 모델 전체 순위와 비용·토큰·스텝을 확인한다.
- 패밀리별 특징 — Fable·Opus·GPT-5.5·Composer 등 제조사·티어별로 읽는다.
- 상황별 선택 — 내 작업·예산에 맞는 모델 후보를 고른다.
2. CursorBench란 무엇인가
CursorBench는 Cursor 엔지니어링 팀의 실제 Cursor 세션에서 뽑은 과제로 에이전트를 평가하는 내부 오프라인 eval 스위트다. 공개 GitHub 이슈가 아니라, 개발자가 에이전트에게 던진 짧고 모호한 요청과 그 결과로 커밋된 코드를 짝지어 채점한다.
| 구분 | CursorBench | SWE-bench 계열 |
|---|---|---|
| 과제 출처 | 실제 Cursor 사용·내부 코드베이스 | 공개 저장소 GitHub 이슈 |
| 작업 설명 | 의도적으로 짧고 모호함 | 이슈 본문처럼 상세 |
| 정답 범위 | 에이전트형 채점기로 다양한 해법 허용 | 패치 diff 일치에 가깝게 채점 |
| 과제 규모 | 멀티파일·대량 LOC 편집 비중 큼 | 버그 수정·단일 PR 중심 |
| 오염 위험 | 낮음(비공개·통제 소스) | 학습 데이터 유입·기억 재현 논란 |
Cursor는 정답 정확성(solution correctness) 외에도 코드 품질, 효율성, 상호작용 방식까지 본다. 다만 공개 리더보드에 올라오는 숫자는 주로 정확성 점수(%)이며, 과제당 비용·토큰·스텝도 함께 공개한다.
2.1. Cursor Blame으로 과제를 수집하는 이유
과제 수집에는 Cursor Blame이 쓰인다. 커밋된 코드를 거슬러 올라가 어떤 에이전트 요청이 그 코드를 만들었는지 추적한다. 덕분에 「개발자 질의」와 「정답 역할을 하는 해결책」이 자연스럽게 한 쌍이 된다. 몇 달마다 스위트를 갱신해 에이전트 사용 패턴 변화를 반영한다.
2.2. 내부에서 보는 네 가지 축
공개 리더보드는 정답 정확성 위주지만, Cursor는 내부적으로 아래까지 함께 본다.
| 축 | 의미 | 리더보드 반영 |
|---|---|---|
| 정답 정확성 | 과제 요구를 맞췄는가 | 점수(%) |
| 코드 품질 | 패치·리팩터 결과의 유지보수성 | 직접 수치 없음 |
| 효율성 | 토큰·스텝·시간 대비 성과 | 토큰/과제·스텝/과제 |
| 상호작용 | 도구 선택·대화 방식의 실용성 | 온라인 eval로 보완 |
에이전트형 채점기(agentic grader) 는 짧은 지시만으로도 여러 타당한 해법을 인정하기 위해 쓰인다. 공개 벤치의 「골드 패치 일치」와 달리, 「요구를 충족했는가」에 가깝게 판단한다.
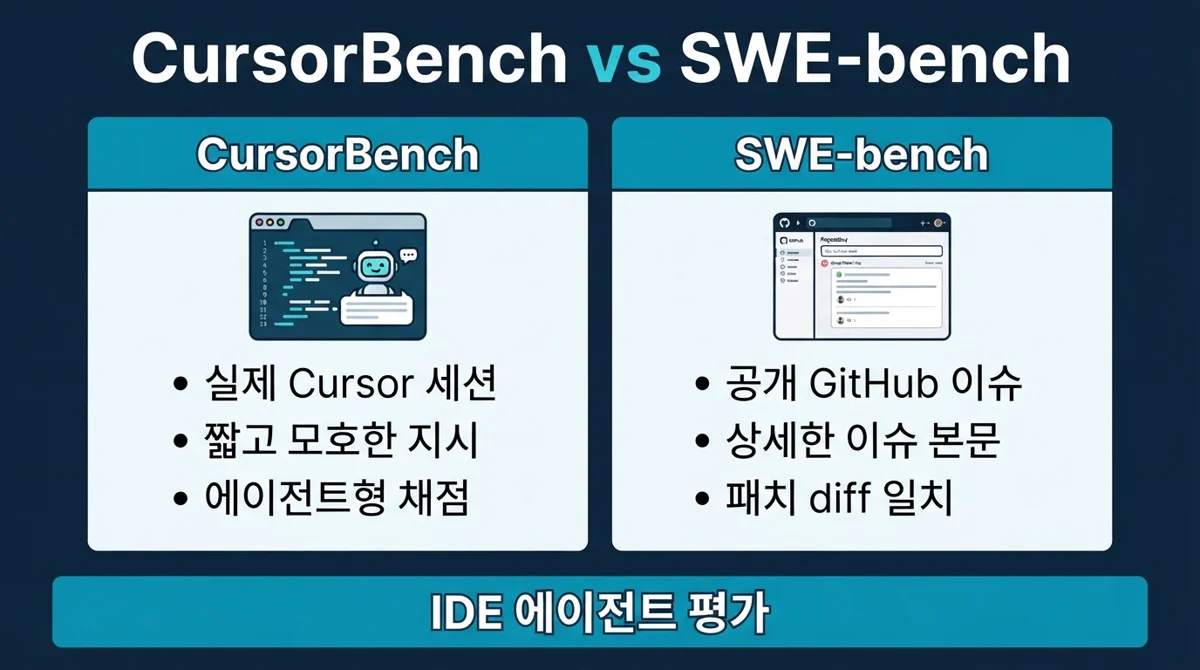 그림 1. CursorBench는 짧은 실사용 요청과 에이전트형 채점이 핵심이다
3. CursorBench가 탄생한 배경
개발자들은 이제 에이전트에게 한 파일 패치가 아니라 아래 같은 일을 맡긴다.
- 모노레포·멀티 워크스페이스에서 여러 패키지 동시 수정
- 프로덕션 로그·에러 트레이스 조사 후 수정
- 리팩터링·계획 수립·코드 리뷰까지 포함한 장시간 작업
요청 범위가 커질수록, 예전 벤치마크로는 프런티어 모델 간 체감 차이를 구분하기 어려워졌다. Cursor는 이를 해결하려고 하이브리드 평가를 쓴다.
| 레이어 | 역할 |
|---|---|
| 오프라인 CursorBench | 모델 간 격차를 크게 드러내는 통제 실험 |
| 온라인 eval | 실제 트래픽·A/B로 「채점기엔 맞는데 쓰기 불편한」 회귀 포착 |
오프라인 점수만 최적화하면, 개발자가 제품에서 느끼는 품질과 어긋날 수 있다. Cursor는 의미 검색 도구 제거 실험(ablation)처럼 통제된 온라인 실험으로 원인을 좁힌 뒤, CursorBench 순위가 온라인 지표와 맞는지 교차 검증한다.
4. 공개 벤치마크의 세 가지 문제
Cursor 블로그가 지적한 공개 오프라인 eval의 한계는 다음 세 가지로 요약된다.
4.1. 정렬(alignment) 부족
대부분의 SWE 벤치마크는 버그 수정에 치우쳐 있다. Terminal-Bench는 체스 최선 수 찾기 같은 퍼즐형 과제 비중이 크다. 실무에서 에이전트에게 맡기는 일—코드베이스 이해, 계획, 리뷰, 모호한 지시 해석—과 결이 다르다.
4.2. 채점(grading)의 경직성
공개 과제는 정답 패치가 하나라고 가정하는 경우가 많다. 실제 개발자 요청은 명세가 느슨해 여러 타당한 접근이 존재한다. 벤치마크는 대안 해법에 불이익을 주거나, 인위적 제약을 덧붙여 「채점 가능한 문제」로 바꾼다. 둘 다 실력 측정과는 거리가 있다.
4.3. 오염(contamination)
SWE-bench Verified·Pro·Multilingual은 공개 저장소에서 과제를 가져온다. 최전선 모델이 골드 패치를 기억만으로 재현할 수 있다는 지적이 이어졌고, OpenAI는 미해결 과제 상당수에 결함 있는 테스트가 있다는 분석 뒤 SWE-bench Verified 결과 보고를 중단했다. 프런티어 구간에서는 점수가 포화되며 개발자 체감과 다른 모델을 구분하지 못한다.
5. CursorBench의 특장점
| 특장점 | 설명 |
|---|---|
| 실사용 정렬 | Cursor 세션 기반이라 IDE·에이전트 워크플로와 맞음 |
| 모호한 지시 | 짧은 프롬프트 + 에이전트형 grader로 실무 대화 방식 반영 |
| 모델 간 분리력 | 공개 벤치가 포화된 구간에서도 순위 차이가 큼 |
| 비용·토큰·스텝 공개 | 정확도만이 아니라 과제당 자원 비교 가능 |
| 버전 관리 | 3.0→3.1처럼 eval 버전 내에서만 점수 비교 권장 |
초기 버전 대비 CursorBench-3 시점에는 편집 LOC·평균 파일 수가 약 2배 늘었다. SWE-bench Verified·Pro·Multilingual보다 정답 패치 줄 수가 훨씬 많은 과제가 포함된다. LOC만으로 난이도를 단정할 수는 없지만, 멀티파일·장시간 작업 비중이 커졌음을 보여 준다.
6. 버전별 변화: 3.0과 3.1
| 버전 | 초점 | 비고 |
|---|---|---|
| CursorBench 3.0 | 편집(edit), 리팩터, 버그 수정 | 초기 공개 세트 |
| CursorBench 3.1 | 코드베이스 이해, 버그 탐색, 계획, 코드 리뷰 | 일부 편집 과제 채점 기준 개선 |
2026년 5월 업데이트로 더 어려운 과제가 추가됐다. Cursor는 동일 eval 버전 안에서만 점수를 비교하라고 명시한다. 3.0과 3.1 숫자를 직접 나란히 두면 과제 분포가 달라 오해가 생길 수 있다.
7. CursorBench 3.1 리더보드 (2026년 7월 2일 기준)
아래 표는 공식 리더보드 기준 전체 36모델 순위다. 점수가 높을수록 좋다. 과제당 비용은 각 모델의 공개 토큰 단가(입력·캐시 읽기·캐시 쓰기·출력)를 실제 사용량에 적용한 평균이다.
| 순위 | 모델 | 점수 | 과제당 비용 | 토큰/과제 | 스텝/과제 |
|---|---|---|---|---|---|
| 1 | Fable 5 Max | 72.9% | $18.02 | 63,842 | 76 |
| 2 | Fable 5 Extra High | 72.0% | $13.74 | 48,754 | 63 |
| 3 | Fable 5 High | 70.6% | $10.81 | 37,173 | 54 |
| 4 | Fable 5 Medium | 69.8% | $8.27 | 28,507 | 47 |
| 5 | Opus 4.7 Max | 64.8% | $11.02 | 62,989 | 96 |
| 6 | GPT-5.5 Extra High | 64.3% | $4.37 | 17,905 | 46 |
| 7 | Fable 5 Low | 64.2% | $5.70 | 18,882 | 36 |
| 8 | Opus 4.8 Max | 63.8% | $7.59 | 77,370 | 60 |
| 9 | Composer 2.5 | 63.2% | $0.55 | 15,152 | 37 |
| 10 | GPT-5.5 High | 62.6% | $3.59 | 13,329 | 40 |
| 11 | Opus 4.8 Extra High | 62.1% | $6.14 | 55,622 | 54 |
| 12 | Opus 4.7 Extra High | 61.6% | $7.11 | 43,942 | 72 |
| 13 | Sonnet 5 Max | 61.2% | $6.87 | 93,485 | 93 |
| 14 | Opus 4.7 High | 59.4% | $5.01 | 32,227 | 59 |
| 15 | GPT-5.5 Medium | 59.2% | $2.22 | 9,065 | 35 |
| 16 | Opus 4.8 High | 58.4% | $4.41 | 36,788 | 45 |
| 17 | Sonnet 5 Extra High | 58.4% | $5.23 | 58,228 | 86 |
| 18 | Sonnet 5 High | 57.0% | $3.74 | 41,735 | 66 |
| 19 | Opus 4.8 Medium | 56.6% | $3.83 | 31,684 | 41 |
| 20 | Sonnet 5 Medium | 54.9% | $2.57 | 27,469 | 53 |
| 21 | GLM 5.2 Max | 54.6% | $3.11 | 51,312 | 83 |
| 22 | Opus 4.8 Low | 54.3% | $2.93 | 22,726 | 36 |
| 23 | Opus 4.7 Medium | 52.7% | $2.93 | 19,193 | 41 |
| 24 | Kimi K2.7 Code | 52.7% | $1.92 | 32,902 | 70 |
| 25 | Composer 2 | 52.2% | $0.56 | 14,163 | 40 |
| 26 | GLM 5.2 High | 50.7% | $2.46 | 30,621 | 76 |
| 27 | Gemini 3.5 Flash | 49.8% | $1.94 | 35,105 | 79 |
| 28 | Sonnet 4.6 Max | 49.0% | $3.09 | 40,280 | 55 |
| 29 | GPT-5.5 Low | 48.8% | $1.19 | 4,923 | 24 |
| 30 | Sonnet 4.6 High | 48.8% | $3.06 | 37,352 | 57 |
| 31 | Opus 4.7 Low | 48.3% | $1.87 | 13,164 | 29 |
| 32 | Sonnet 5 Low | 47.7% | $1.46 | 17,028 | 37 |
| 33 | Kimi 2.6 | 47.6% | $1.27 | 24,783 | 56 |
| 34 | Sonnet 4.6 Medium | 46.0% | $2.64 | 31,360 | 50 |
| 35 | Sonnet 4.6 Low | 41.5% | $1.89 | 21,211 | 50 |
| 36 | Kimi 2.5 | 31.9% | $0.87 | 9,446 | 30 |
7.1. 상위 5모델 요약
| 순위 | 모델 | 한 줄 해석 |
|---|---|---|
| 1 | Fable 5 Max | 최고 점수·최고 비용의 프리미엄 |
| 2~4 | Fable 5 Extra High~Medium | 점수 70%대·비용 단계적 절감 |
| 5 | Opus 4.7 Max | Anthropic 플래그십·스텝 96으로 탐색 많음 |
| 6 | GPT-5.5 Extra High | OpenAI 상위 티어·Fable Low와 점수 근접 |
| 9 | Composer 2.5 | Opus 4.8 Max급 점수·과제당 0.55달러 |
Cursor는 작은 점수 차이가 통계적으로 의미 없을 수 있다고 밝힌다. 62.6%와 62.1%처럼 0.5%p 차이만으로 「확실히 우위」라고 말하기는 어렵다.
7.2. 산점도로 읽는 방법
리더보드 차트는 정확성(세로) 과 과제당 비용·토큰·스텝(가로) 을 함께 그린다. 가로축이 과제당 비용일 때 이상적인 위치는 왼쪽 위—비용은 낮고 점수는 높은 구간이다. Fable 5 Max는 점수 1위지만 과제당 약 18달러로 프리미엄 구간에 있다. Composer 2.5는 63.2%에 약 0.55달러로 같은 차트에서 가성비 축의 대표 모델로 자주 언급된다.
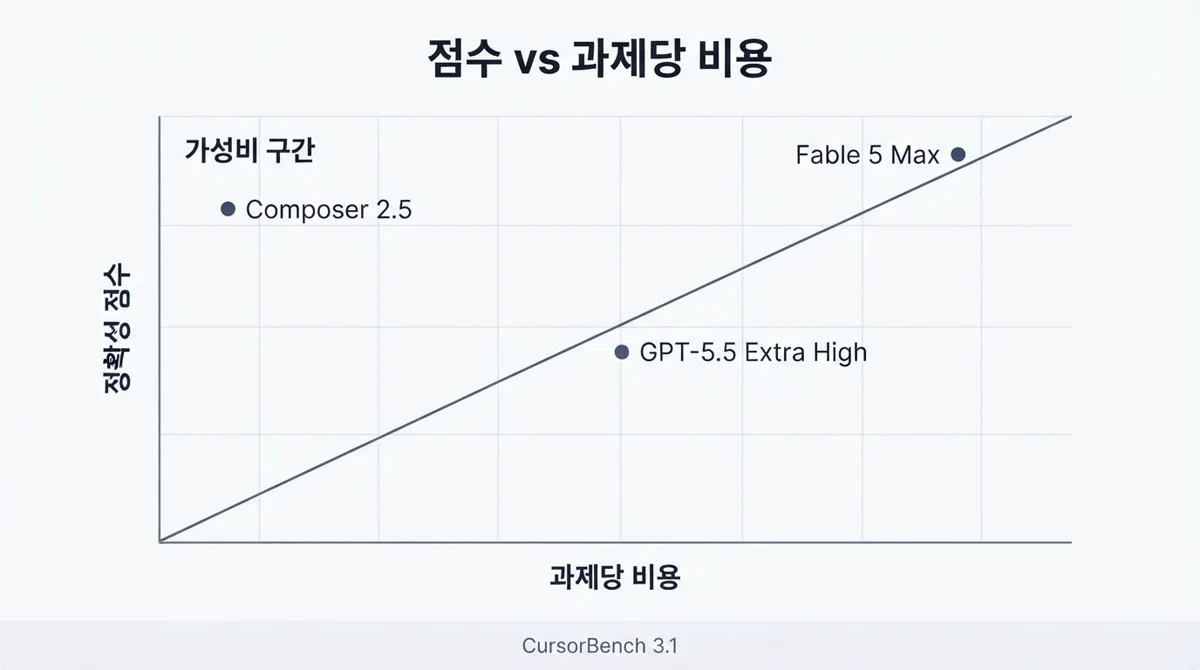 그림 2. 왼쪽 위가 저비용·고점수 구간이며 Composer 2.5가 대표적이다
8. 모델 패밀리별 특징
8.1. effort 티어(Low~Max)란
CursorBench 리더보드에는 같은 모델명에 Low·Medium·High·Extra High·Max 접미가 붙는 항목이 많다. 이는 추론 깊이·도구 호출 허용·응답 시간 예산을 단계별로 둔 effort 설정이다. 티어가 올라갈수록 점수는 오르는 경우가 많지만, 과제당 비용·토큰·스텝도 함께 늘어난다.
| 티어 | 일반적 의미 | 선택 힌트 |
|---|---|---|
| Low | 빠른 시도, 얕은 탐색 | 초안·단순 수정 |
| Medium | 균형 | 일상 개발 |
| High | 깊은 추론 | 멀티파일·버그 추적 |
| Extra High / Max | 최대 예산 | 장애 조사·대규모 리팩터 |
Fable 5·GPT-5.5·Opus·Sonnet 모두 이 패턴을 따른다. Composer 2.5는 리더보드에 단일 행으로 올라가며, Standard/Fast 가격 티어는 별도 문서를 본다.
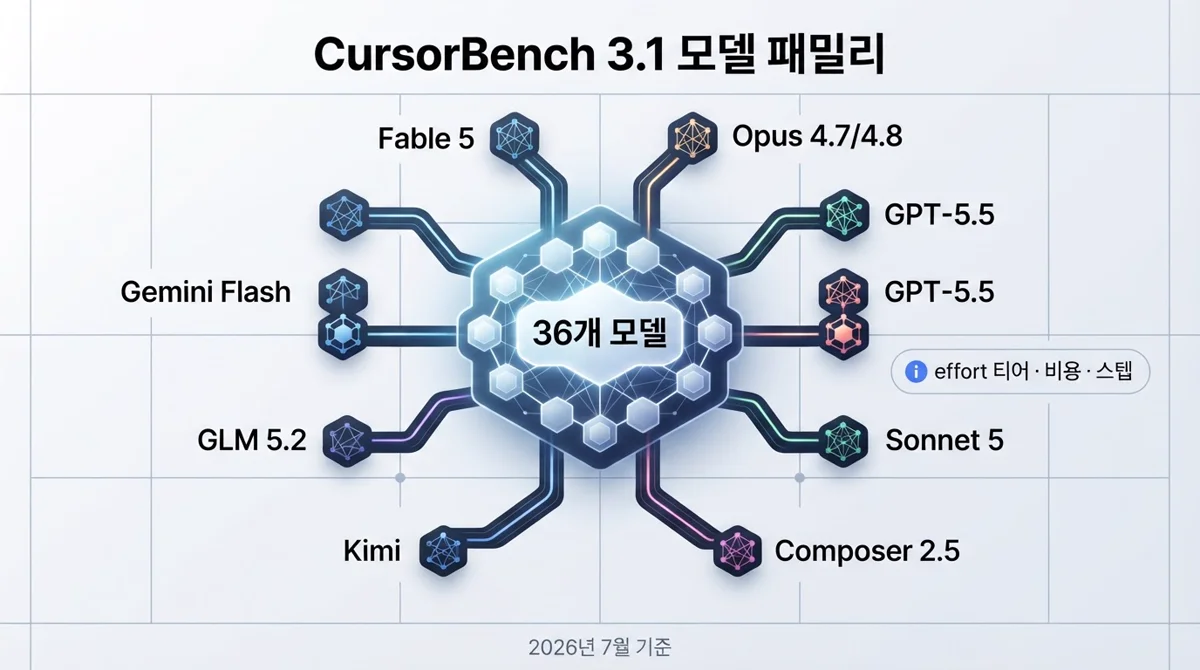 그림 3. 패밀리마다 effort 티어와 가격·점수 곡선이 다르다
8.2. Fable 5 (Anthropic Mythos-class)
| 항목 | 내용 |
|---|---|
| 정체성 | Anthropic이 공개한 Mythos-class 상위 코딩·에이전트 모델. CursorBench 3.1에서 1~4위·7위를 Fable 5 effort 티어가 독점 |
| effort 티어 | Low·Medium·High·Extra High·Max — 추론·도구 사용 깊이에 따라 점수·비용이 계단식 상승 |
| 강점 | 모호한 멀티파일 과제, 버그 탐색, 계획·리뷰. Max 72.9%로 리더보드 최고 |
| 약점 | 비용·토큰·스텝 모두 상위권. Max는 과제당 7만 토큰·76스텝 수준 |
| 선택 기준 | 예산 여유가 있고 한 번에 맞추는 품질이 최우선일 때 |
Fable 5 Low(64.2%)만 해도 GPT-5.5 Extra High(64.3%)와 점수가 비슷한데, Low는 과제당 약 5.7달러로 Max 대비 약 1/3 비용이다. 「최고 티어가 아니어도 상위권」이라는 점이 CursorBench 분리력의 예시다.
8.3. Claude Opus 4.7 / 4.8
| 항목 | 내용 |
|---|---|
| 순위대 | Opus 4.7 Max 5위(64.8%), Opus 4.8 Max 8위(63.8%) |
| 특징 | 장기 에이전트 작업·복잡 지시에 강한 플래그십 Claude 라인 |
| 4.7 vs 4.8 | 4.7 Max가 4.8 Max보다 점수·비용 모두 약간 높게 측정됨(동일 버전 내 비교). 4.8 Max는 토큰 77,370으로 가장 많은 토큰을 쓰는 상위 모델 중 하나 |
| 스텝 | Opus 4.7 Max는 96스텝으로 최다 스텝 — 더 많은 도구 호출·탐색 패턴 가능 |
| 선택 기준 | Anthropic 생태계 선호, Fable 대비 검증된 Opus 라인이 필요할 때 |
8.4. GPT-5.5 (OpenAI)
| 항목 | 내용 |
|---|---|
| 순위대 | Extra High 6위(64.3%), High 10위(62.6%), Medium 15위(59.2%), Low 29위(48.8%) |
| 특징 | effort 티어에 따라 점수·비용이 함께 움직임. Extra High는 Fable 5 Low와 점수 근접하나 과제당 약 4.37달러 |
| 효율 | Medium은 59.2%에 9,065 토큰·35스텝 — 상위권 대비 짧은 궤적 |
| 선택 기준 | OpenAI 단일 스택, Codex·ChatGPT와 연계된 워크플로 |
8.5. Claude Sonnet 4.6 / Sonnet 5
| 항목 | 내용 |
|---|---|
| Sonnet 5 | Max 13위(61.2%) ~ Low 32위(47.7%). Max는 토큰 93,485·스텝 93으로 고비용·다스텝 |
| Sonnet 4.6 | Max 28위(49.0%) ~ Low 35위(41.5%). 5세대 대비 한 단계 아래 구간 |
| 특징 | 일상 코딩·빠른 반복에 쓰기 좋은 미드·하이 티어로 알려졌으나, CursorBench 3.1의 어려운 과제에서는 Opus·GPT-5.5 상위 티어와 격차 존재 |
| 선택 기준 | 속도·단가 균형, 대규모 리팩터보다는 중간 난이도 작업 |
8.6. Composer 2.5 / Composer 2 (Cursor 자체 모델)
| 항목 | 내용 |
|---|---|
| 순위 | Composer 2.5 9위 63.2%, Composer 2 25위 52.2% |
| 베이스 | Moonshot AI 오픈소스 Kimi K2.5 체크포인트(MoE, 총 파라미터 약 1T·추론 시 활성 약 32B). Cursor가 후학습 85% 비중으로 RL·합성 코딩 과제 25배 확대 |
| 가격 | 공식 문서 기준 Standard $0.50/M 입력·$2.50/M 출력. Fast 변형은 $3/$15 |
| CursorBench 의미 | Composer 2 대비 +11%p — 같은 베이스에서 Cursor 후학습 기여가 큼. Kimi 2.5(36위 31.9%)와 점수 격차가 이를 뒷받침 |
| 선택 기준 | Cursor IDE·CLI 기본 에이전트, 포함 usage pool, 과제당 0.55달러 수준의 가성비 |
Composer 2.5는 Opus 4.8 Max(63.8%)와 점수가 거의 같으면서 비용은 약 1/14 수준으로 측정된다. 「최고 점수」가 아니라 실사용 비용 대비 성능을 볼 때 핵심 후보다.
8.7. GLM 5.2 (Zhipu)
| 항목 | 내용 |
|---|---|
| 순위 | Max 21위(54.6%), High 26위(50.7%) |
| 특징 | 중국 Zhipu AI 계열. Max는 스텝 83으로 탐색이 긴 편 |
| 선택 기준 | GLM 생태계·다국어·비용 실험 |
8.8. Kimi K2.7 Code / Kimi 2.6 / Kimi 2.5 (Moonshot)
| 항목 | 내용 |
|---|---|
| 순위 | K2.7 Code 24위(52.7%), Kimi 2.6 33위(47.6%), Kimi 2.5 36위(31.9%) |
| 관계 | Composer 2.5는 K2.5 베이스 + Cursor RL. 동일 베이스라도 후학습 차이가 31.9% vs 63.2%로 이어짐 |
| K2.7 Code | 오픈 체크포인트 기반 코드 특화. Composer 2.5보다 낮으나 과제당 약 1.92달러 |
| 선택 기준 | Moonshot 모델 직접 사용, Composer와 분리된 API 전략 |
8.9. Gemini 3.5 Flash (Google)
| 항목 | 내용 |
|---|---|
| 순위 | 27위 49.8%, 과제당 $1.94, 스텝 79 |
| 특징 | 플래시급 속도·단가에 가깝게 포지셔닝. CursorBench 3.1의 고난도 멀티파일 과제에서는 상위 프런티어보다 낮은 점수 |
| 선택 기준 | 짧은 질의·빠른 초안, 비용 민감 작업 |
9. 공개 벤치마크와 숫자 비교
CursorBench만으로 모델을 판단하면 안 된다. 다른 벤치도 측정 축이 다르다.
| 벤치마크 | 측정 초점 | CursorBench와의 관계 |
|---|---|---|
| SWE-bench Verified | 공개 이슈 패치 | 포화·오염 논란. Fable 5는 외부 표에 95%대도 보고되나 CursorBench와 순위 상관은 완전하지 않음 |
| SWE-bench Pro | 더 어려운 SWE | 여전히 이슈-패치 프레이밍 |
| Terminal-Bench | 터미널·퍼즐형 에이전트 | Cursor가 정렬 부족 예로 든 계열 |
| CursorBench 3.1 | 모호한 멀티파일 Cursor 과제 | IDE 에이전트 선택에 가장 직접적 |
Haiku급 경량 모델이 SWE-bench에서는 GPT-5와 비슷해 보이다가 CursorBench에서는 체감 차이가 드러난다는 분석이 Cursor 블로그에 있다. 「벤치 1위 = 내 프로젝트 1위」가 아니다.
10. 상황별 모델 선택 참고
| 상황 | 우선 고려 | 이유 |
|---|---|---|
| 대규모 리팩터·프로덕션 장애 조사 | Fable 5 High~Max, GPT-5.5 Extra High | 점수 상위, 다파일·계획·리뷰 과제 비중 |
| 일일 개발·비용 상한 엄격 | Composer 2.5, GPT-5.5 Medium, Opus 4.8 Low | 0.55~3달러/과제 구간 |
| Anthropic만 사용 | Fable 5 Medium 이상 또는 Opus 4.7 High+ | 동일 벤치 내 Anthropic 라인 비교 |
| OpenAI·Codex 연동 | GPT-5.5 High~Extra High | 62~64% 구간·상대적 저비용 |
| 속도·초안 위주 | Gemini 3.5 Flash, Kimi 2.6, Sonnet 5 Low | 낮은 스텝·토큰 다만 점수 48~50%대 |
| 오픈소스 베이스 실험 | Kimi K2.7 Code, Kimi 2.5 | Composer 후학습 효과와 분리해 베이스 성능 확인 |
모델은 Cursor 설정·구독 플랜·포함 usage에 따라 선택 가능 목록이 달라진다. 리더보드에 있어도 계정에서 비활성일 수 있다.
11. 앞으로의 eval 방향
CursorBench-3 과제는 공개 벤치보다 길지만 여전히 한 세션 안에서 끝난다. Cursor는 앞으로 장시간 자율 에이전트(로컬 PC에서 며칠 돌리는 형태) 비중이 커질 것으로 보고, 채점 비용 절감·외부 API 연동 재현성·오프라인 vs 체감 격차 축소를 과제로 꼽는다.
12. 마무리
앞에서 본 CursorBench 내용을 짧게 묶는다.
- CursorBench는 실제 Cursor 세션에서 만든 과제로, 공개 SWE 벤치의 정렬·채점·오염 문제를 피하려는 Cursor 전용 eval이다.
- 3.1은 코드 이해·버그 탐색·계획·리뷰 비중이 커졌고, 2026년 7월 2일 기준 1위는 Fable 5 Max 72.9%, 가성비 축 대표는 Composer 2.5 63.2%·$0.55/과제다.
- 점수는 정확성 중심이며, 비용·토큰·스텝을 함께 봐야 실무 선택과 맞는다.
- 같은 eval 버전 안에서만 비교하고, 1%p 미만 차이는 통계적 우열로 단정하지 않는다.
- SWE-bench·Terminal-Bench와 축이 다르다. Cursor 사용자는 리더보드를 IDE 모델 선택의 한 축으로 쓰되, 자신의 저장소·스택으로 직접 시험하는 것이 최종 검증이다.
- 벤치 점수·가격·모델명은 제품 업데이트에 따라 변동한다. 결정 전 공식 리더보드를 다시 확인한다.
「벤치 점수는 참고 지표이고, 내 코드베이스에서의 통과율이 정답이다」 — 프리미엄 모델은 어려운 한 방에, Composer·Medium 티어는 반복 작업에 배분하는 식으로 역할을 나누면 비용과 품질 균형을 잡기 쉽다.
자주 묻는 질문
- CursorBench는 무엇을 측정하나요?
Cursor 엔지니어의 실제 Cursor 세션에서 나온 모호한 멀티파일 과제로 에이전트를 평가합니다. 공개 리더보드는 주로 정답 정확성(%)과 과제당 비용·토큰·스텝을 보여 줍니다. 코드 품질·효율·상호작용도 내부적으로 본다고 Cursor가 밝혔습니다.
- SWE-bench와 CursorBench의 가장 큰 차이는?
SWE-bench는 공개 GitHub 이슈 패치에 가깝고 버그 수정 중심입니다. CursorBench는 짧고 모호한 실사용 요청·내부 코드·에이전트형 채점을 씁니다. 공개 벤치는 학습 데이터 오염·포화 논란이 있고, CursorBench는 IDE 에이전트 선택과 정렬된다고 Cursor가 설명합니다.
- CursorBench 3.1 1위 모델은 무엇인가요?
2026년 7월 2일 기준 공식 리더보드 1위는 Fable 5 Max로 72.9%입니다. 과제당 평균 비용은 약 18.02달러, 토큰 63,842, 스텝 76으로 측정됩니다. Anthropic Mythos-class 상위 티어가 상위권을 차지합니다.
- Composer 2.5는 왜 점수 대비 비용이 낮게 나오나요?
Composer 2.5는 Kimi K2.5 베이스에 Cursor 후학습(RL·합성 과제 25배)을 얹은 Cursor 전용 모델입니다. 63.2%에 과제당 약 0.55달러로, Opus 4.8 Max와 점수는 비슷하나 비용은 훨씬 낮게 측정됩니다. MoE 구조와 짧은 에이전트 궤적(37스텝)이 반영된 결과입니다.
- Fable 5 Low와 GPT-5.5 Extra High는 어떻게 비교하나요?
둘 다 64%대 초반입니다. Fable 5 Low는 64.2%, GPT-5.5 Extra High는 64.3%로 거의 같습니다. 비용은 Fable 5 Low 약 5.70달러, GPT-5.5 Extra High 약 4.37달러입니다. Cursor는 작은 점수 차이를 통계적으로 무의미할 수 있다고 안내합니다.
- CursorBench 3.0 점수와 3.1을 직접 비교해도 되나요?
권장하지 않습니다. 2026년 5월 3.1 업데이트로 더 어려운 과제가 추가되어 과제 분포가 바뀌었습니다. Cursor는 동일 eval 버전 내에서만 점수를 비교하라고 명시합니다.
- Kimi 2.5와 Composer 2.5 점수 차이는 무엇을 뜻하나요?
둘 다 Kimi K2.5 계열이지만 CursorBench 3.1에서 Kimi 2.5는 31.9%, Composer 2.5는 63.2%입니다. 같은 오픈 체크포인트라도 Cursor의 에이전트 특화 후학습이 점수에 크게 기여함을 보여 줍니다. Composer 2는 52.2%로 전 세대 대비 약 11%p 상승했습니다.
- Sonnet 5 Max는 왜 토큰과 스텝이 많나요?
Sonnet 5 Max는 61.2%에 토큰 93,485·스텝 93으로 상위권 중 가장 긴 궤적 중 하나입니다. 더 많은 도구 호출과 탐색으로 과제를 풀었을 가능성이 있으나, Fable 5 Max보다 점수는 낮고 비용도 큽니다. 효율보다 시도 횟수가 많은 패턴으로 해석할 수 있습니다.
- CursorBench 점수만 보고 모델을 고르면 안 되는 이유는?
벤치는 Cursor 환경의 특정 과제 분포를 반영합니다. SWE-bench·Terminal-Bench와 순위가 다를 수 있고, 내 저장소 난이도·언어·프레임워크와도 어긋날 수 있습니다. 리더보드는 후보를 좁히는 용도로 쓰고, 실제 프로젝트에서 검증하는 것이 안전합니다.
- 과제당 비용은 어떻게 계산되나요?
각 모델의 공개 per-million-token 가격(입력·캐시 읽기·캐시 쓰기·출력)을 CursorBench 3.1 과제에서 실제 사용한 토큰에 적용한 뒤 과제별로 평균 낸 값입니다. 구독 포함 usage·할인은 반영되지 않을 수 있습니다.
- Gemini 3.5 Flash는 CursorBench에서 어느 정도인가요?
2026년 7월 2일 기준 27위, 49.8%, 과제당 약 1.94달러, 스텝 79입니다. 플래시급 속도·단가에 맞는 포지션이지만, 3.1의 고난도 멀티파일·리뷰 과제에서는 Fable·GPT-5.5·Composer 상위권보다 낮은 점수입니다.
- CursorBench 리더보드는 어디서 보나요?
공식 페이지는 https://cursor.com/cursorbench 입니다. 배경 설명은 https://cursor.com/blog/cursorbench 블로그를 참고하면 됩니다. 모델·점수·비용은 업데이트될 수 있으므로 글 작성 시점과 다를 수 있습니다.