 테크·IT
로컬에서 LLM 추론, 이미지 생성, 영상 인코딩까지 GPU를 고를 때는 게이밍 벤치마크만으로는 부족하다. 같은 12GB VRAM이라도 텐서 코어 세대·메모리 대역폭·NVENC 세대가 작업마다 우선순위를 바꾼다. RTX 4070 Super와 5070, 중고 3090과 50시리즈, 16GB 소비자 카드와 RTX 6000 Pro까지 AI 기준으로 정리했다.
GPU 치수·케이스 장착 길이·PSU·12V-2x6·발열·듀얼 GPU 슬롯·RAM·NVMe까지 시스템 빌드 팁도 포함했다.
가격·재고는 메모리 품귀로 출시 정가(MSRP)와 실거래가 차이가 클 수 있다. 당근마켓 중고 는 아래 「2026년 6월 15일」 절에 별도 정리했다. 구매 직전에는 최신 시세와 공식 스펙을 다시 확인하는 편이 안전하다.
1. AI 개발 + 영상편집 — 사기 전에 외울 규칙
본문 표·당근 시세 보기 전에 먼저 본다. 아래 번호는 구매 우선순위 이다.
1.1. 절대 원칙
| # | 규칙 |
|---|---|
| 1 | AMD·인텔 GPU는 사지 않는다. 이 작것들은 사지 않는다 |
| 8 | 1번은 반드시 준수한다 |
로컬 LLM·ComfyUI·ffmpeg NVENC 본업이면 CUDA·NVENC가 기본이다. ROCm은 있어도 시간 세금 이 붙는다.
1.2. 용도별 우선순위
| 구분 | 우선순위 |
|---|---|
| AI 개발 | VRAM 최우선 — 모델이 안 들어가면 세대·TOPS는 의미 없다 |
| 영상 편집 | 50시리즈 최우선 — NVENC 9세대·AV1 하드웨어 인코딩 |
| 40시리즈(Ada) | 4070 Super부터 산다. 그 아래는 AI·코덱 밸런스가 애매한 경우가 많다 |
1.3. 당근 중고 — 이 가격이면 우선 검토 (2026년 6월 감각)
| # | GPU | 목표 매수가 | 꼭 확인 |
|---|---|---|---|
| 2 | RTX 5060 Ti 16GB | 60만원대 | 8GB 변종 아님 → 16GB 인지. 이 구간이면 FP4·AV1·16GB 올라운드 가성비가 터진다 |
| 3 | RTX 5070 12GB | 70만원 내외 | 급처·지역가. 85만 넘으면 5070 Ti와 가격 비교 |
| 4 | RTX 5070 Ti 16GB | 110만원 내외 | 영상+AI 균형 1순위 후보 |
| 5 | RTX 5080 16GB | 170만원 내외 | 50시리즈 상위·영상 코덱 우선 빌드 |
| 6 | RTX 3060 Ti | 울트라급 입문 | 최저가 체험용. AI만 보면 VRAM 때문에 3060 12GB·5060 Ti 16GB가 위인 경우가 많다 |
1.4. 24GB가 필요하면 — RTX 3090
당근 중고 75~100만원 이 24GB 입문의 정석 구간이다. AV1·FP4·신품 보증이 더 중요하면 50시리즈(위 표)와 만원 단위로 비교한다. 3090은 전력·발열·중고 리스크·AV1 없음이 약점이다.
| 상황 | AMD·인텔을 고민해도 되나 |
|---|---|
| 게이밍만, AI·ffmpeg 안 함 | 본 글 범위 밖 |
| LLM·이미지 AI·다빈치 AI·NVENC | 규칙 1로 복귀 |
| 「VRAM 많은데 싸다」 RX 16GB | CUDA·문서 지옥 각오 |
아래 「AMD·Intel 16GB (참고)」 절은 게이밍·가성비 비교용 이다. AI·영상 본업이면 결국 NVIDIA 표 로 돌아온다.
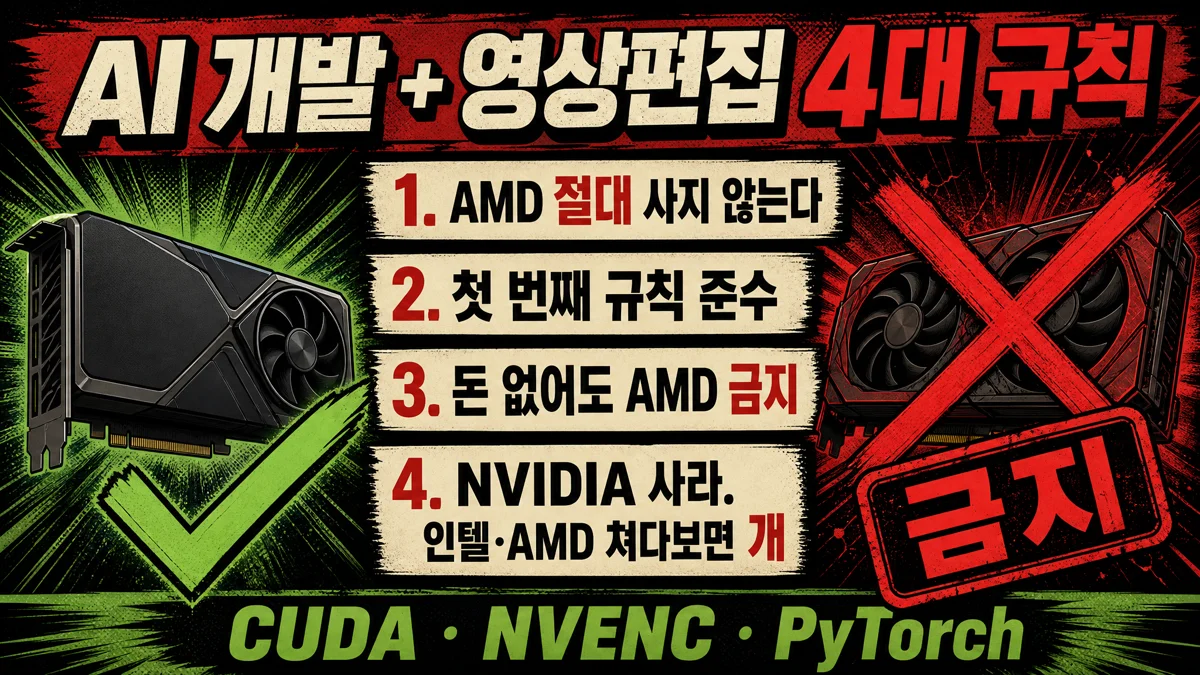
그림 0. 0번 규칙 — AMD·인텔 금지, 당근 목표가, AI는 VRAM·영상은 50시리즈
2. AI GPU를 가르는 세 가지 기준
로컬 AI에서 카드 성능을 나누는 순서는 대체로 아래와 같다.
| 순위 | 기준 | 왜 중요한가 |
|---|---|---|
| 1 | VRAM 용량 | 모델 가중치·KV 캐시가 GPU 메모리에 들어가야 한다. 넘치면 시스템 RAM으로 넘어가며 속도가 급락한다 |
| 2 | 메모리 대역폭 | 추론은 매 토큰마다 가중치를 읽는 작업이라, TFLOPS보다 GB/s가 체감 속도를 좌우하는 경우가 많다 |
| 3 | 텐서 코어 세대·FP4 | Blackwell(50시리즈)의 FP4는 저정밀 추론 효율을 높이지만, 프레임워크·모델이 지원해야 효과가 난다 |
게이밍은 래스터화·레이트레이싱·클럭에 민감하고, AI는 위 세 가지가 먼저 걸린다. 그래서 게이밍에서 5% 차이인 두 카드가 AI에서는 다른 그림이 될 수 있다.
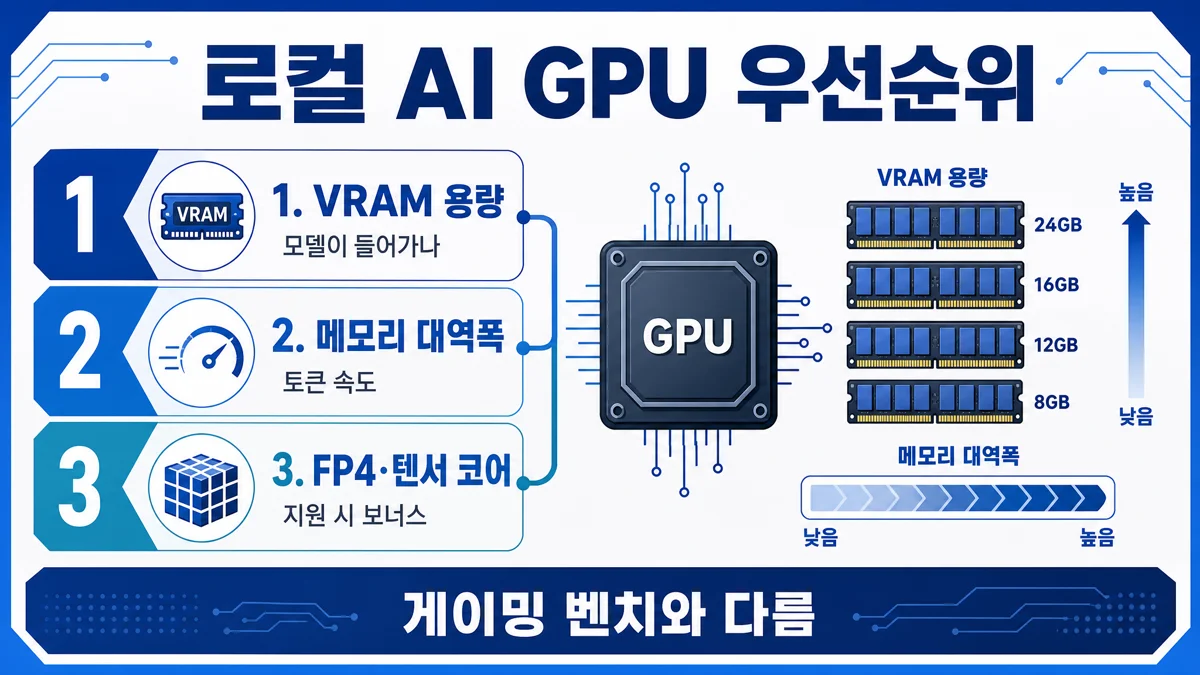 그림 1. AI GPU는 게이밍 벤치가 아니라 VRAM → 대역폭 → FP4 순으로 본다
3. TOPS·FP4·sparsity 숫자 읽는 법
제조사 스펙에 나오는 AI TOPS는 정밀도·측정 조건이 제각각이라 그대로 비교하면 안 된다.
FP4(4비트 부동소수점) 는 Blackwell(50시리즈) 5세대 텐서 코어가 하드웨어로 지원하는 형식이다. Ada(40시리즈)인 RTX 4070 Super에는 FP4 항목 자체가 없다. RTX 5070의 988 TOPS(FP4)와 4070 Super의 568 TOPS(FP8 등)는 서로 다른 눈금이다.
sparsity(희소성) 는 가중치 절반이 0이라고 가정해 연산을 건너뛴 이론 최대치다. 실제 모델이 그만큼 희소하지 않으면 스펙만큼 나오지 않는다. dense 기준으로는 sparsity 수치의 절반 정도로 보는 편이 현실적이다.
| 항목 | RTX 5070 (Blackwell) | RTX 4070 Super (Ada) |
|---|---|---|
| 텐서 코어 | 5세대 | 4세대 |
| FP4 | 지원 (스펙 최대 약 988 TOPS) | 미지원 |
| FP8 | 지원 | 지원 |
| VRAM | 12GB GDDR7 | 12GB GDDR6X |
| 메모리 대역폭 | 약 672 GB/s | 약 504 GB/s |
| CUDA 코어 | 6,144 | 7,168 |
5070은 코어 수는 적지만 GDDR7 대역폭과 FP4·AMP(AI Management Processor) 덕분에 양자화 추론·최신 프레임워크 경로에서는 유리할 수 있다. 다만 둘 다 12GB라 모델 크기 한계는 동일하다.
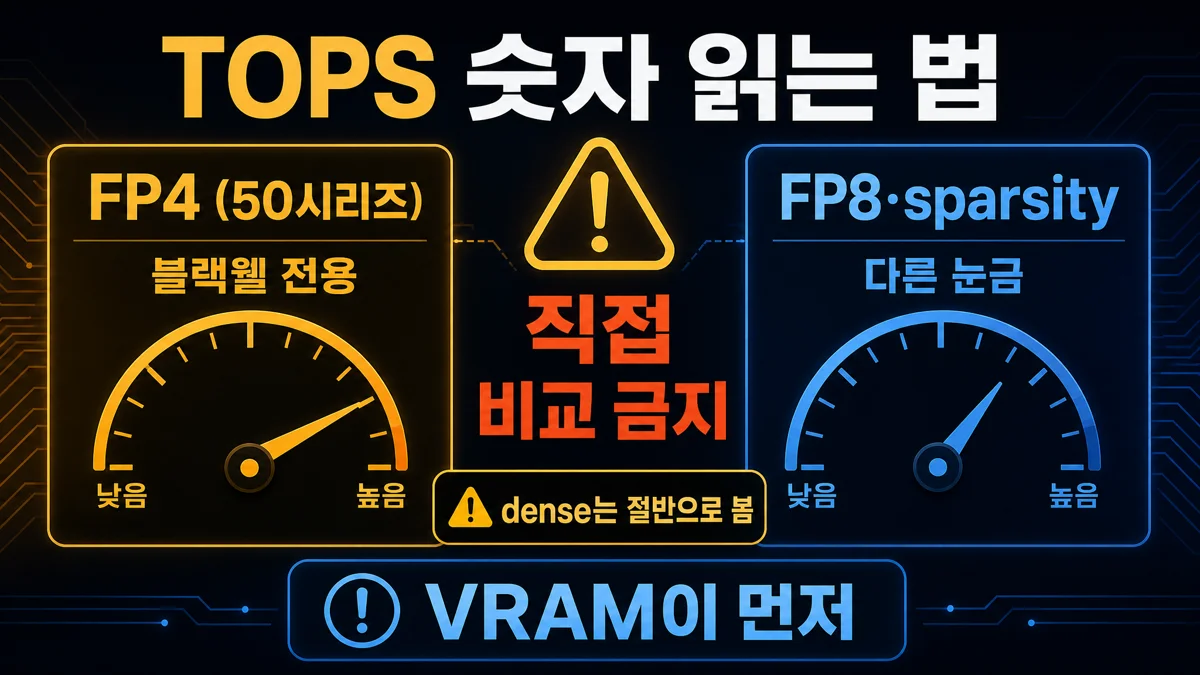 그림 2. 제조사 TOPS는 정밀도가 달라 직접 비교하면 안 된다
4. RTX 4070 Super vs 5070 — 게이밍 5%인데 AI는 왜 다르가
1440p·레이트레이싱 게이밍에서는 두 카드가 비슷한 구간에 모이는 리뷰가 많다. CUDA 코어·클럭·메모리 용량이 비슷하면 래스터 성능 차이가 작게 나온다.
AI 쪽은 달라진다.
- 5070: 5세대 텐서 코어, FP4, GDDR7 672 GB/s. TensorRT·양자화 추론에서 메모리 효율이 좋아진다.
- 4070 Super: CUDA 코어가 더 많고 전력(약 220W)이 낮지만 FP4 없음, 대역폭 504 GB/s.
12GB로 돌리기 좋은 대략적 구간은 7~8B급 FP16, 13B 전후 Q4 양자화 정도다. 더 큰 모델은 둘 다 VRAM이 먼저 막힌다.
영상 인코딩까지 겸한다면 5070이 NVENC 9세대·AV1 하드웨어 인코딩을 갖춘 점에서 유리하다(아래 ffmpeg 절 참고).
5. RTX 3090 vs 5070 — 세대가 높아도 VRAM이 먼저다
Ampere 3090과 Blackwell 5070을 AI만 놓고 보면 「세대가 높은 쪽이 무조건 이긴다」가 성립하지 않는다.
| 항목 | RTX 3090 | RTX 5070 |
|---|---|---|
| VRAM | 24GB GDDR6X | 12GB GDDR7 |
| 메모리 대역폭 | 약 936 GB/s | 약 672 GB/s |
| 텐서 코어 | 3세대 (Ampere) | 5세대 (Blackwell) |
| FP4 | 미지원 | 지원 |
| NVENC | 7세대, AV1 인코딩 미지원 | 9세대, AV1 지원 |
| 전력 | 약 350W | 약 250W |
| 구매 형태 | 중고 위주 | 신품 |
큰 LLM·파인튜닝·긴 컨텍스트 는 24GB가 먼저다. 70B급도 Q4 양자화·듀얼 GPU(NVLink) 조합으로 3090 커뮤니티 활용 사례가 많다. 12GB 5070은 같은 모델을 올리지 못하거나 양자화·오프로딩에 의존한다.
5070이 앞서는 조건 은 모델이 12GB 안에 들어가고, FP4·FP8 경로를 쓰는 최신 추론·이미지 생성 위주일 때다. 속도는 빠를 수 있지만 VRAM을 넘기면 의미가 없어진다.
3090 단점은 전력·발열·중고 리스크·FP4 미지원·AV1 인코딩 부재다. 신품 보증·전기료·최신 코덱이 중요하면 50시리즈를 같이 본다.
6. 영상 편집·ffmpeg — NVENC와 AV1이 기준을 바꾼다
ffmpeg·다빈치·프리미어에서 GPU 가속 인코딩은 CUDA 코어보다 NVENC(인코더)·NVDEC(디코더) 전용 블록이 담당한다. 세대마다 HEVC·AV1 품질·속도가 달라진다.
| GPU | NVENC 세대 | AV1 인코딩 | VRAM |
|---|---|---|---|
| RTX 3090 | 7세대 | 미지원 | 24GB |
| RTX 4070 Ti Super | 8세대 | 지원 | 16GB |
| RTX 5070 / 5070 Ti | 9세대 | 지원 | 12GB / 16GB |
| RTX 5090 | 9세대 (3개) | 지원 | 32GB |
순수 트랜스코딩·AV1보내기는 5070 계열이 3090보다 유리하다. 4K·8K 인코딩도 VRAM 12~16GB면 대부분 충분하다. AI처럼 VRAM을 폭식하지 않는다.
다빈치 리졸브·프리미어의 AI 마스크·노이즈 제거·업스케일을 많이 쓰면 다시 VRAM이 중요해져 24GB 3090·4090 쪽이 나을 수 있다.
ffmpeg에서 GPU 인코딩을 쓰려면 코덱을 명시해야 한다. 예: -c:v h264nvenc, -c:v hevcnvenc, -c:v av1_nvenc. CPU 인코딩(libx264 등)이면 GPU 세대 차이는 거의 없다.
7. VRAM 16GB 라인업 — AI와 영상 겸용
16GB는 「영상 인코딩은 충분 + 중형 AI 모델까지」에 맞는 용량대다. 70B급 단일 카드 구동은 여전히 부족하다.
7.1. NVIDIA 16GB 소비자 카드
| 모델 | VRAM·메모리 | 대역폭 | NVENC·AV1 | FP4 | MSRP(출시가) |
|---|---|---|---|---|---|
| RTX 5060 Ti 16GB | 16GB GDDR7 | 448 GB/s | 9세대·AV1 | 지원 | $429 |
| RTX 4070 Ti Super | 16GB GDDR6X | 672 GB/s | 8세대·AV1 | 미지원 | $799 |
| RTX 5070 Ti | 16GB GDDR7 | 896 GB/s | 9세대·AV1 | 지원 | $749 |
| RTX 5080 | 16GB GDDR7 | 960 GB/s | 9세대·AV1 | 지원 | $999 |
| RTX 4080 Super | 16GB GDDR6X | 736 GB/s | 8세대·AV1 | 미지원 | $999 |
5060 Ti 16GB는 FP4·AV1·16GB를 가장 저렴하게 묶지만 128비트 버스라 대역폭 448 GB/s로 큰 모델 추론은 답답할 수 있다. 영상+AI 균형 은 5070 Ti 16GB가 자주 거론된다. 5080은 16GB 중 연산·대역폭이 가장 높다.
7.2. AMD·Intel 16GB (참고)
RX 9070 XT·7800 XT 등 16GB AMD 카드는 영상·AV1·가성비 게이밍에는 강점이 있으나, PyTorch·Stable Diffusion·LLM 생태계는 CUDA(NVIDIA)가 호환·속도·문서 면에서 유리하다. AI를 본격적으로 할 계획이면 NVIDIA 쪽이 안전하다.
8. 시스템 RAM으로 VRAM을 대체할 수 있나
기술적으로는 llama.cpp·Ollama 등이 GPU VRAM 초과분을 시스템 RAM에 두는 오프로딩 을 지원한다. 다만 AI 실사용에서 체감은 크게 떨어진다.
| 경로 | 대역폭(대략) |
|---|---|
| RTX 3090 VRAM | 약 936 GB/s |
| RTX 5070 Ti VRAM | 약 896 GB/s |
| DDR5 시스템 RAM | 약 50~90 GB/s |
| PCIe 4.0 x16 (GPU↔RAM) | 약 32 GB/s |
GPU가 시스템 RAM 데이터를 쓰면 PCIe 병목을 거친다. VRAM 대비 수십 배 느린 통로다.
| 상태 | 체감(예시) |
|---|---|
| 모델 전체가 VRAM에 적재 | 초당 수십 토큰 수준도 가능 |
| 일부 레이어 RAM 오프로드 | 초당 1~5 토큰 또는 그 이하 |
| 대부분 CPU·RAM 처리 | 실사용 어려움 |
영상 트랜스코딩은 스트리밍 방식이라 VRAM을 많이 쓰지 않아 이 문제가 거의 없다.
통합 메모리 는 예외다. Apple M 시리즈·AMD Strix Halo 등은 CPU·GPU가 같은 메모리 풀을 쓰며 PCIe 병목이 없다. 대신 데스크탑 CUDA 생태계·게이밍·일부 전문 앱과는 다른 트레이드오프가 있다.
9. AI 작업 기준 GPU 순위 (30·40·50·6000 Pro)
아래 순위는 로컬 LLM 추론·이미지 생성·양자화 활용 을 기준으로 한 참고표다. 학습·파인튜닝 전문·듀얼 GPU는 별도 설계가 필요하다.
| 순위 | GPU | VRAM | 대역폭 | FP4 | 아키텍처 | MSRP·시세(대략) | 핵심 이유 |
|---|---|---|---|---|---|---|---|
| 1 | RTX PRO 6000 Blackwell | 96GB GDDR7 ECC | 1,792 GB/s | 지원 | Blackwell | 워크스테이션 $8,000대 | 단일 카드로 대형 LLM·MoE·파인튜닝. ECC·MIG |
| 2 | RTX 5090 | 32GB GDDR7 | 1,792 GB/s | 지원 | Blackwell | $1,999 | 소비자급 최상위 VRAM·대역폭·FP4 |
| 3 | RTX 6000 Ada | 48GB GDDR6 ECC | 960 GB/s | 미지원 | Ada | $2,000대 | VRAM 48GB. FP4 없음, 5090보다 대역폭 낮음 |
| 4 | RTX 4090 | 24GB GDDR6X | 1,008 GB/s | 미지원 | Ada | $1,600 출시 | 24GB+대역폭. 5090 대비 추론 느림 |
| 5 | RTX 3090 / 3090 Ti | 24GB GDDR6X | 936 / 1,008 GB/s | 미지원 | Ampere | 중고 $600~900 | 24GB 가성비. 전력·중고·FP4·AV1 인코딩 약점 |
| 6 | RTX 5080 | 16GB GDDR7 | 960 GB/s | 지원 | Blackwell | $999 | 신기능·속도 우수, 16GB 한계 |
| 7 | RTX 5070 Ti | 16GB GDDR7 | 896 GB/s | 지원 | Blackwell | $749 | 16GB 밸런스·영상+AI 겸용 |
| 8 | RTX 4080 Super | 16GB GDDR6X | 736 GB/s | 미지원 | Ada | $999 | 16GB·준수 성능, 50시리즈에 밀림 |
| 9 | RTX 4070 Ti Super | 16GB GDDR6X | 672 GB/s | 미지원 | Ada | $799 | 16GB 입문~중급 |
| 10 | RTX 5060 Ti 16GB | 16GB GDDR7 | 448 GB/s | 지원 | Blackwell | $429 | 저가 16GB·FP4·AV1, 대역폭 낮음 |
| 11 | RTX 4060 Ti 16GB | 16GB GDDR6 | 288 GB/s | 미지원 | Ada | $449 | 16GB지만 대역폭 병목 |
| 12 | RTX 3060 12GB | 12GB GDDR6 | 360 GB/s | 미지원 | Ampere | $300 전후 | 최저가 입문·7~8B급 |
9.1. VRAM별 대략적 모델 구간 (Q4·양자화 기준, 여유 컨텍스트 전제)
| VRAM | 단일 GPU에서 자주 논의되는 구간 |
|---|---|
| 12GB | 7~8B FP16, 13B 전후 Q4 |
| 16GB | 14~27B Q4 (모델·컨텍스트에 따라 변동) |
| 24GB | 32B급 Q4, 13B FP16 |
| 32GB | 32B Q4 여유, 일부 70B Q3~Q4 경계 |
| 48GB+ | 파인튜닝·대형 추론 워크스테이션 |
수치는 도구·양자화·KV 캐시 길이에 따라 달라진다. 「들어간다」와 「쾌적하다」는 별개다.
10. 용도별 선택 정리
| 우선 작업 | 현실적인 후보 | 이유 |
|---|---|---|
| 큰 LLM·로컬 70B급·파인튜닝 | 중고 3090 24GB, 4090, 5090 32GB, 6000 Ada/Pro | VRAM이 1순위 |
| 영상 ffmpeg·AV1·다빈치보내기 | 5070 Ti 16GB, 5080, 5090 | NVENC 9세대·AV1 |
| 영상+AI 균형·16GB | 5070 Ti 16GB | 896 GB/s·FP4·AV1·16GB |
| 예산 16GB·입문 AI | 5060 Ti 16GB | 가격 대비 FP4·16GB |
| 최저가 입문 | 3060 12GB | 12GB·저전력, 대역폭·세대 한계 |
| 워크스테이션·ECC·96GB | RTX PRO 6000 Blackwell | 소비자 카드로 불가능한 용량 |
3090 vs 5070 Ti 16GB 를 동시에 고민한다면: AI 모델 크기가 16GB를 넘으면 3090, 영상 AV1·신품·FP4·전력이 더 중요하면 5070 Ti 쪽이 맞는 경우가 많다.
5090 vs 듀얼 3090 은 예산·전력·소음·NVLink 필요 여부로 갈린다. 48GB가 필요하면 듀얼 3090, 단일 카드 32GB·최고 대역폭·FP4면 5090.
11. 폼팩터 — 타워·오픈프레임·랙 중 무엇을 고를까
GPU만 사서 끼우면 끝이 아니다. 폼팩터 는 냉각·소음·확장·책상 아래 배치까지 한꺼번에 정한다.
| 형태 | 장점 | 단점 | 언제 맞나 |
|---|---|---|---|
| 미들·풀 타워 ATX | 조용·정리된 배선·책상 배치 | 듀얼 3슬롯 GPU 간격·길이 제약 | 단일 GPU·5070 Ti·4090 1장 |
| 풀·E-ATX 타워 | GPU 길이 400mm+·듀얼 x16 간격 | 부피·무게 | 듀얼 3090/4090·5090+워크스테이션 CPU |
| 오픈 프레임·마이닝 랙 | 최고 공기 접촉·다중 GPU 냉각 | 소음·먼지·미관 | 24/7 추론·듀얼 이상·실험용 |
| 4U 랙·서버형 케이스 | 다중 GPU 공기 통로·산업용 팬 | 가격·소음·데스크 공간 | 4장 이상·상시 가동 |
| SFF(소형) | 책상 위 컴팩트 | 고전력 GPU·길이 304mm 한계 | 5060 Ti·5070 FE 등 SFF-Ready만 |
게이밍용 「유리 패널·조용한 케이스」 는 AI 지속 부하 에는 역으로 불리할 때가 많다. 메쉬 전면·넓은 GPU 클리어런스·하드 드라이브 케이지 제거가 24/7 온도에 더 중요하다.
12. 그래픽카드 물리 치수 — 길이·슬롯 두께·높이
파트너사 카드는 공식 FE(파운더스 에디션)와 치수가 크게 다르다. 구매 전 AIB 제조사 스펙 시트 를 본다.
12.1. 대표 FE·참고 치수 (NVIDIA 공식·리뷰 기준)
| 모델 | 길이(L) | 높이(H) | 슬롯 | TGP·전력 | 비고 |
|---|---|---|---|---|---|
| RTX 5090 FE | 304 mm | 137 mm | 2슬롯 | 575 W | SFF-Ready, 12V-2x6 1개 |
| RTX 5080 FE | 304 mm | 137 mm | 2슬롯 | 360 W | SFF-Ready |
| RTX 5070 Ti FE | 304 mm | 137 mm | 2슬롯 | 300 W | 다수 AIB는 더 김 |
| RTX 5070 FE | 242 mm | 112 mm | 2슬롯 | 250 W | 12GB |
| RTX 4090 FE | 304 mm | 137 mm | 3슬롯 | 450 W | 12VHPWR |
| RTX 3090 FE | 313 mm | 138 mm | 3슬롯 | 350 W | 24GB, NVLink |
| RTX 5060 Ti 16GB | 약 240~250 mm | 제각각 | 2~2.5슬롯 | 180 W | 128비트·16GB |
12.2. 파트너 카드 예시 (같은 GPU라도 다름)
| 모델 예 | 길이 | 슬롯 | 제조사 권장 PSU |
|---|---|---|---|
| MSI RTX 5090 Gaming Trio OC | 359 mm | 3.5슬롯(약 70 mm) | 1000 W+ |
| PNY RTX 5090 Triple Fan OC | 328.7 mm | 3.5슬롯 | 1000 W |
| ASUS 등 SFF-Ready 5080/5070 | 298~304 mm | 2.5슬롯(약 50 mm) | 모델별 상이 |
304 mm 는 5090·5080 FE와 SFF-Ready 상한에 자주 나온다. 338 mm·359 mm 급 트리플 팬 OC는 풀타워 GPU 클리어런스 360 mm+ 를 요구한다. 케이스 스펙이 「330 mm 지원」이면 MSI Gaming Trio 같은 모델은 물리적으로 안 들어간다.
12.3. NVIDIA SFF-Ready 기준 (50시리즈)
공식 SFF-Ready 프로그램은 대략 길이 304 mm · 높이 151 mm · 두께 2.5슬롯(약 50 mm) 를 상한으로 둔다. 5090은 FE만 이 목록에 올라가는 경우가 많고, 대부분의 파트너 5090은 더 크다.
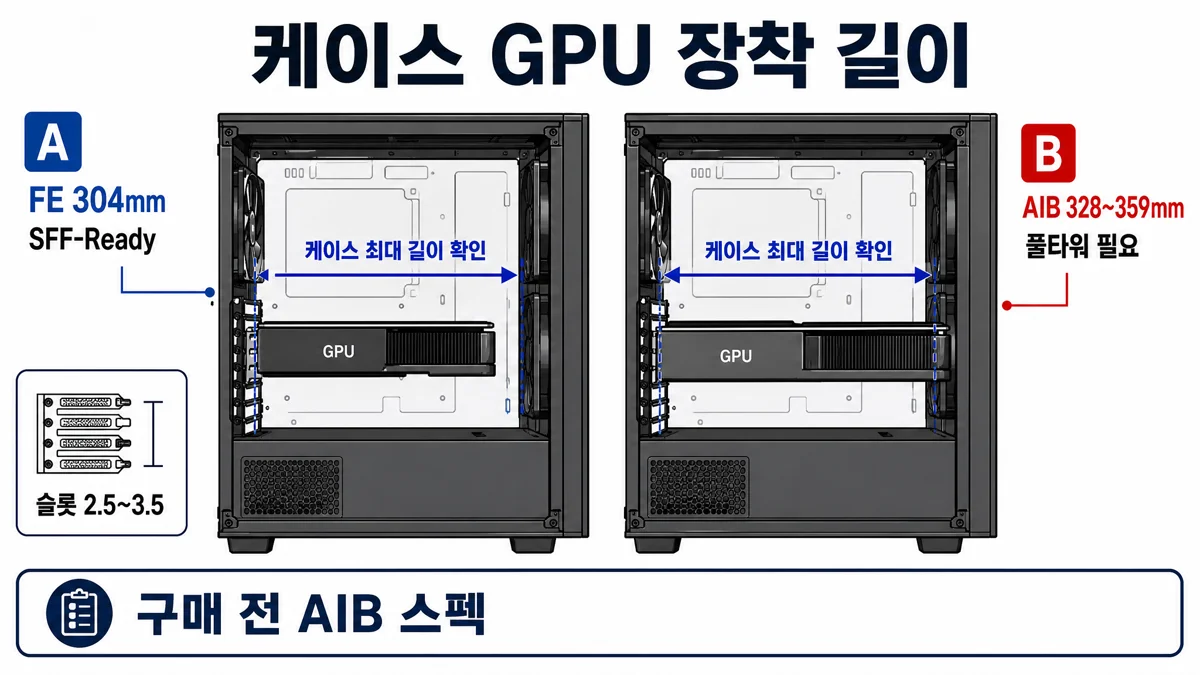 그림 3. 케이스 GPU 길이 표기와 AIB 실제 치수(304 vs 359mm)를 반드시 대조
13. 케이스 GPU 최대 장착 길이 — 확인 절차
케이스 제조사 표기는 「GPU 최대 xxx mm」 하나로 끝나지 않는다. 아래를 합산 한다.
| 확인 항목 | 이유 |
|---|---|
| GPU 최대 길이(mm) | 전면 팬·HDD 케이지·라디에이터와 간섭 |
| 슬롯 두께(2 / 2.5 / 3 / 3.5) | 아래 PCIe 슬롯·M.2 방열판과 겹침 |
| 전원 케이블 여유 35~40 mm | 12V-2x6 직선 구간(아래 절) |
| 수직 장착 시 측면 50~60 mm | 리저 케이블·팬 흡입 공간 |
| CPU 쿨러 높이 | 긴 GPU와 쿨러가 동시에 막히는 경우 |
실측 공식(전원 케이블): 카드 높이(mm) + 최소 35 mm = 측면 패널까지 필요 거리. 149 mm AIB 5090이면 약 184 mm 이상이어야 패널을 닫을 때 케이블이 눌리지 않는다.
듀얼 GPU면 두 번째 x16 슬롯까지 3슬롯 이상 간격 이 필요하다. 3슬롯 카드 2장이면 사실상 6슬롯 분량 + 공기 간격 1슬롯이 이상적이다.
14. 발열·공기 흐름 — 게이밍과 다른 24/7 AI 부하
게이밍은 부하가 들쭉날쭉해서 GPU가 쉬는 구간이 있다. LLM 추론·Stable Diffusion·ffmpeg 일괄 인코딩은 GPU 사용률이 오래 높게 유지된다.
| 원칙 | 내용 |
|---|---|
| 전면 메쉬·후면·상단 배기 | 전면→후면 직선 흐름. 측면 배기 는 열 순환만 만들어 피한다 |
| 약한 양압 | 흡입 CFM을 배기보다 60:40 정도로 — 먼지·유입 안정 |
| 24/7 팬 베어링 | 슬리브 대신 FDB·라이플 베어링 |
| 먼지 필터 | 6개월 방치 시 흡입 30~50% 감소. 분기 점검 |
| GPU 팬 커브 | AI는 「조용 우선」보다 80°C 이하 유지 쪽. 스로틀링이 토큰/초를 깎는다 |
| 실내 온도 | 여름 28°C+ 실내는 GPU 베이스 온도를 그만큼 올린다 |
듀얼 GPU 는 위 카드가 아래 카드 열을 먹는다. 블로워형(후면 배기)은 소음은 크지만 적층에 유리하고, 오픈 에어는 단일·간격 넓을 때 유리하다. 슬롯 사이 1칸 비우기 는 듀얼 오픈에어에서 체감 온도 차이가 크다.
수직 장착은 보기 좋지만 케이스마다 측면 패널과 50~60 mm 미만이면 오히려 막힌다. 리저는 PCIe 4.0/5.0 정품급, 각도 어댑터는 플러그 직후 35 mm 직선을 유지하는 제품을 고른다.
15. 파워 서플라이 — GPU별 권장 와트
AI·영상은 순간 피크 가 게이밍보다 길게 이어진다. PSU는 지속 부하의 50~80% 구간 에 두는 편이 효율·소음·안정에 낫다. 80 PLUS Gold 이상·모듈러·ATX 3.1(12V-2x6 네이티브) 권장.
15.1. 단일 GPU 빌드
| GPU | TGP(공식) | 실제 피크(대략) | 최소 PSU | 권장 PSU | 비고 |
|---|---|---|---|---|---|
| RTX 3060 12GB | 170 W | ~200 W | 550 W | 650 W | 입문 |
| RTX 5060 Ti 16GB | 180 W | ~220 W | 550 W | 650 W | 8핀·16GB |
| RTX 5070 / 5070 Ti | 250~300 W | ~280~330 W | 650 W | 750~850 W | 12V-2x6 |
| RTX 5080 | 360 W | ~400 W | 750 W | 850 W | |
| RTX 4070 Ti Super | 285 W | ~320 W | 650 W | 750 W | 8세대 NVENC |
| RTX 4090 | 450 W | ~520 W | 850 W | 1000 W | 12VHPWR |
| RTX 3090 | 350 W | ~380 W | 750 W | 850~1000 W | 중고·8핀 |
| RTX 5090 | 575 W | ~600~650 W | 1000 W | 1200 W | NVIDIA 공식 1000 W, 여유는 1200 W |
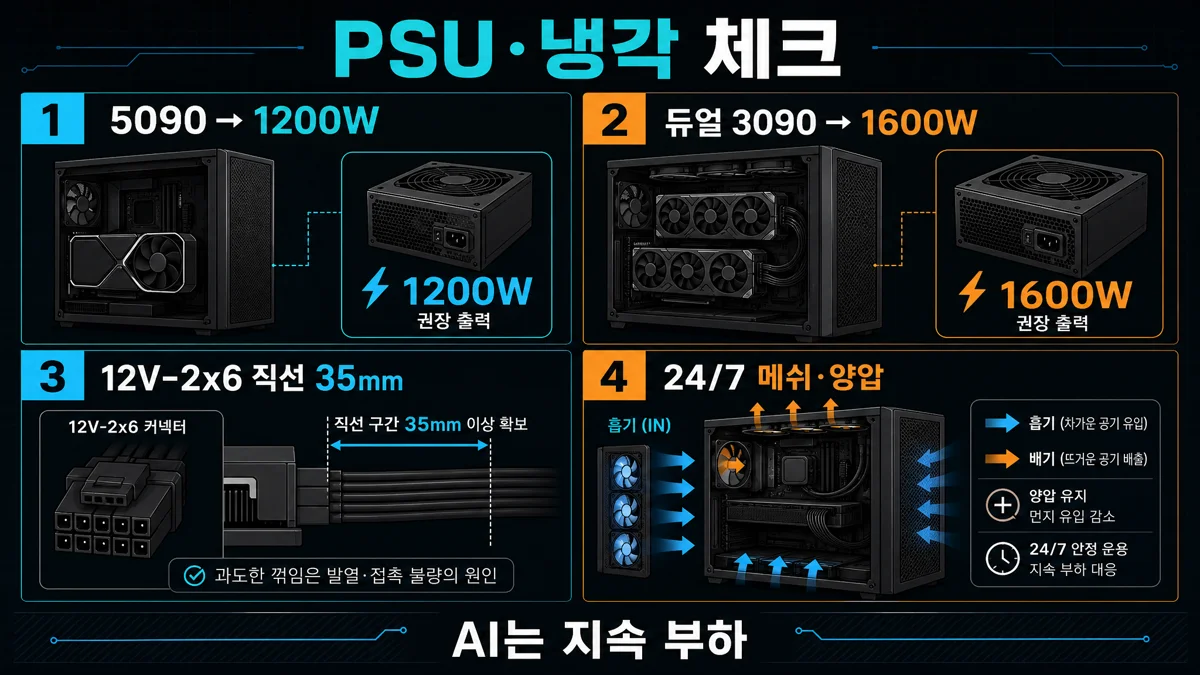 그림 4. GPU TGP 합산 후 PSU 여유·12V-2x6 직선 35mm·24/7 냉각을 함께 본다
CPU를 Ryzen 9·Core Ultra 9급으로 풀 부하 돌리면 위 권장에 +100~150 W 를 더해 본다. 9950X+5090 동시 부하는 900~1000 W 피크도 나온다.
15.2. 듀얼·다중 GPU
| 구성 | 지속 전력(대략) | 최소 PSU | 권장 PSU |
|---|---|---|---|
| 2× RTX 3090 | ~1,060 W | 1200 W | 1600 W |
| 2× RTX 4090 | ~1,200 W | 1200 W | 1600 W |
| 2× RTX 5090 | ~1,550~1,650 W | 1600 W | 2000 W 또는 듀얼 PSU |
| 4× RTX 4090 | ~2,0 kW+ | 2× 1500 W 분리 | 워크스테이션·랙 전용 |
듀얼 5090은 단일 1600 W도 피크에서 타이트 하다. AM5는 듀얼 PSU 보드가 드물어 TRX50·워크스테이션 보드·2×1500 W 분리 급전이 논의된다.
콘센트·차단기: 1000 W급은 230 V 기준 약 4.5 A, 1600 W는 약 7 A. 멀티 GPU는 전용 회로 가 안전하다.
16. 12V-2x6·12VHPWR 전원 — 케이블·클리어런스
RTX 50 시리즈(5070 Ti·5080·5090 등)와 40 시리즈 고전력 카드는 12V-2x6(또는 12VHPWR) 단일 커넥터를 쓴다.
| 규칙 | 내용 |
|---|---|
| 완전 체결 | 틈 없이 딸깍까지. 미체결 시 국부 발열·용융 사례 |
| 직선 구간 35~40 mm | 커넥터 직후 급격한 꺾임 금지 |
| 측면 패널 압력 | 케이블이 플러그를 밀면 접촉 불량 |
| 네이티브 케이블 | 검증된 PSU 동봉 12V-2x6 우선. 저가 어댑터 다단 연결 지양 |
| 90°·180° 어댑터 | 직선 30~40 mm 유지되는 일체형만. 패널 클리어런스 부족 시 |
| 수직 장착 | 유리 패널과 20~25 mm 미만이면 각도 어댑터 검토 |
5090 FE는 길이 304 mm·높이 137 mm지만, AIB 149~150 mm 높이 는 케이블까지 합쳐 185 mm 클리어런스가 필요하다.
17. CPU·RAM·NVMe — GPU 다음 하드웨어
추론은 GPU 바운드라 CPU는 과투자할 필요가 적다. 다만 RAM·디스크는 체감이 크다.
17.1. CPU
| 용도 | 권장 |
|---|---|
| 단일 GPU 추론·영상 | Ryzen 7·Core i7 6~8코어 |
| 듀얼 GPU·전처리 많음 | Ryzen 9·Core i9 |
| 4GPU+·많은 PCIe 레인 | Threadripper TRX50·워크스테이션 |
PCIe 5.0 x16 슬롯은 50시리즈와 짝이 맞지만, 일부 5090/5080에서 Gen5 이슈 가 보고되어 Gen4 강제가 해결책인 경우도 있다.
17.2. 시스템 RAM
| 용도 | 권장 |
|---|---|
| 7~13B 위주 | 32 GB |
| 16GB GPU + 영상·멀티탭 | 64 GB |
| 70B 오프로드·듀얼 GPU | 64~128 GB |
| 파인튜닝·대형 데이터 | 128 GB+ |
RAM 용량을 늘려도 PCIe 오프로딩 속도는 거의 안 오른다. 다만 OS·브라우저·편집 앱과 GPU가 VRAM·디스크를 두고 모델을 나눌 여유 공간 은 필요하다. DDR5-6000대는 오프로드 시 소폭 유리할 수 있다.
17.3. 스토리지
| 항목 | 권장 |
|---|---|
| 형태 | NVMe SSD 필수 (SATA·HDD는 대형 모델 로딩에 수 분) |
| 용량 | 1 TB 최소, 모델 여러 개면 2~4 TB |
| 속도 | Gen4 5,000 MB/s+, Gen5는 70B급 로딩 단축 |
| 배치 | OS·앱과 모델 라이브러리 디스크 분리도 방법 |
70B Q4 파일 하나가 40 GB 전후 다. 여유 없으면 바로 디스크부터 찬다.
18. 듀얼 GPU·마더보드 — 슬롯 간격과 PCIe
| 항목 | 내용 |
|---|---|
| 물리 간격 | 두 x16 슬롯 사이 3슬롯 이상 (1번·4번 또는 1번·5번 위치) |
| 전기적 | 2번 슬롯 x8/x8이 추론에서 x16/x16과 3% 미만 차이로 알려짐 |
| mATX | 듀얼 풀사이즈 GPU 거의 불가 |
| NVLink | RTX 3090만 소비자 NVLink. 4090/5090은 PCIe 분할 |
| 동일 GPU 2장 | 드라이버·전력·발열 관리가 단순 |
B650 등 저가 보드는 2번 슬롯이 x4 로 떨어지는 경우가 있어 매뉴얼의 「듀얼 VGA」 레인 표를 반드시 본다.
19. 로컬 AI 소프트웨어·드라이버
| 계층 | 대표 도구 | 비고 |
|---|---|---|
| 드라이버 | NVIDIA Studio 또는 Game Ready 최신 | CUDA·TensorRT 호환 |
| 런타임 | CUDA Toolkit, cuDNN(프레임워크 요구 시) | |
| LLM | Ollama, llama.cpp, LM Studio, vLLM | VRAM·양자화 설정이 핵심 |
| 이미지 | ComfyUI, Automatic1111, Forge | VRAM+시스템 RAM |
| 영상 | ffmpeg NVENC, DaVinci·Premiere GPU | 코덱 명시 필수 |
| 모니터링 | nvidia-smi, HWiNFO | 24/7 온도·전력 |
Windows 11 64비트가 호환 문서가 가장 많다. Linux는 서버·다중 GPU에 강점이 있으나 게이밍·일부 편집 앱과는 트레이드오프다.
전력 제한·언더볼트: 5090·4090을 80~90% 전력 캡으로 돌려도 추론 체감은 작고 온도·소음·PSU 여유는 커진다. 24/7 상시 가동 빌드에서 자주 쓴다.
20. 영상 편집 병행 — 워크플로 실전 팁
| 작업 | 팁 |
|---|---|
| ffmpeg 배치 인코딩 | GPU 1장이면 -c:v av1_nvenc, 프리셋 p5~p7, CQ/VBR로 밤샘 일괄 처리 |
| 프록시 + 원본 | 편집은 프록시, 마스터는 AV1·HEVC NVENC로 최종 |
| 다빈치 AI | GPU 메모리 12GB 넘으면 16GB+ 권장. 24GB는 Fusion·Fairlight 여유 |
| AI 추론과 동시 | 같은 GPU에서 SD+인코딩 동시는 VRAM 경합. 순차 실행이 안전 |
| 디스크 | 원본 4K는 NVMe 별도. SATA SSD는 타임라인 스크러빙 병목 |
| RAM | 4K 타임라인+브라우저+LLM이면 64 GB가 편하다 |
3090은 AV1 인코딩이 없어 유튜브·배포용 AV1 은 50시리즈나 CPU libsvtav1로 보완한다.
21. 빌드 전 통합 체크리스트
| # | 확인 |
|---|---|
| 1 | 돌릴 모델 크기 → 필요 VRAM 확정 |
| 2 | GPU 실제 L×H×슬롯 → 케이스 GPU 길이·두께 |
| 3 | 12V-2x6 직선 35 mm + 카드 높이 → 측면 클리어런스 |
| 4 | TGP 합산 → PSU 50~80% 구간 |
| 5 | 듀얼이면 슬롯 3칸+·PSU 1200 W+ |
| 6 | RAM 32/64/128 GB · NVMe 1 TB+ |
| 7 | 전면 메쉬·필터·팬 곡선 — 24/7 온도 |
| 8 | 전용 콘센트·실내 냉방 |
| 9 | 드라이버·Ollama/ComfyUI·ffmpeg 테스트 |
| 10 | nvidia-smi로 풀부하 30분 온도·재부팅 없음 |
22. 당근마켓 중고 시세 (2026년 6월 15일)
아래는 당근마켓 직거래 를 수년간 보던 기준으로, 2026년 6월 15일에 실제로 눈에 띈 중고 그래픽카드 호가 를 정리한 표다. 네이버 쇼핑·중고나라·해외 시세가 아니라 당근 한정 이며, 지역·판매자 성향·박스·보증·마이닝 이력·AIB 모델에 따라 ±10~20%는 흔하다.
MSRP·신품 품귀와 별개로, 당근은 「오늘 당장 팔 사람」 가격이 섞인다. 관측치 는 그날 본 숫자, 적정 중고 범위 는 같은 VRAM·세대 안에서 반복 관측·빠진 매물을 보정해 잡은 구간이다. 범위 밖이면 박스·미개봉·급처·지역 프리미엄을 의심하면 된다.
22.1. 시세를 읽을 때 (당근 특유)
| 항목 | 왜 중요한가 |
|---|---|
| VRAM 변종 | 3060 12GB vs 8GB, 5060 8GB vs 16GB, 4060 Ti 8/16GB — 검색어가 같아도 스펙이 다르다 |
| 3080 10GB vs 12GB | 10GB는 당근에 많고 12GB는 훨씬 비싸다. AI는 10GB면 12GB 3060보다 불리한 경우가 많다 |
| 50시리즈 신품 대비 | 5070·5080은 신품 대기·프리미엄이 섞여 80~110만·180~200만처럼 넓게 퍼진다 |
| 3090·4090 | 그날 스캔에 없어도 당근에는 늘 올라온다. 아래 표는 당일 미관측·시세 추정 열로 구분 |
| 마이닝·수리 | 당근은 「정상가」 글과 「급처·이상 저가」 가 한 화면에 섞인다. 극단값은 범위 끝이 아니라 이상치로 본다 |
22.2. GPU 메모리·VRAM 한눈에 (중고 검색용)
| 모델 | VRAM | 메모리 종류 | 메모리 버스 | 대역폭(대략) | 비고 |
|---|---|---|---|---|---|
| GTX 1070 | 8GB | GDDR5 | 256-bit | 256 GB/s | AI·AV1 부적합, 레거시 |
| RTX 2060 | 6GB | GDDR6 | 192-bit | 336 GB/s | 6GB 한계 |
| RTX 2060 Super | 8GB | GDDR6 | 256-bit | 448 GB/s | 2060과 검색어 혼동 주의 |
| RTX 3050 | 8GB | GDDR6 | 128-bit | 224 GB/s | 입문 게이밍, AI 약함 |
| RTX 3060 12GB | 12GB | GDDR6 | 192-bit | 360 GB/s | 12GB 가성비 입문 AI |
| RTX 3060 8GB | 8GB | GDDR6 | 128-bit | 240 GB/s | 12GB보다 저렴·AI 한계 |
| RTX 3070 | 8GB | GDDR6 | 256-bit | 448 GB/s | VRAM 8GB가 병목 |
| RTX 3070 Ti | 8GB | GDDR6X | 256-bit | 608 GB/s | 3070 대비 속도↑ VRAM 동일 |
| RTX 3080 10GB | 10GB | GDDR6X | 320-bit | 760 GB/s | 10GB 한계, 가격은 싸게 나옴 |
| RTX 3080 12GB | 12GB | GDDR6X | 384-bit | 912 GB/s | 10GB보다 희소·비쌈 |
| RTX 3090 | 24GB | GDDR6X | 384-bit | 936 GB/s | 중고 AI 핵심, NVLink |
| RTX 4060 | 8GB | GDDR6 | 128-bit | 272 GB/s | 3060 12GB 대비 AI 불리 |
| RTX 4060 Ti 8GB | 8GB | GDDR6 | 128-bit | 288 GB/s | 대역폭 병목 |
| RTX 4060 Ti 16GB | 16GB | GDDR6 | 128-bit | 288 GB/s | 16GB·대역폭 트레이드오프 |
| RTX 4070 Super | 12GB | GDDR6X | 192-bit | 504 GB/s | FP4 없음 |
| RTX 4070 Ti Super | 16GB | GDDR6X | 256-bit | 672 GB/s | Ada 16GB |
| RTX 4080 Super | 16GB | GDDR6X | 256-bit | 736 GB/s | |
| RTX 4090 | 24GB | GDDR6X | 384-bit | 1,008 GB/s | 3090 상위, 중고 고가 |
| RTX 5060 8GB | 8GB | GDDR7 | 128-bit | 280 GB/s | FP4·AV1, VRAM 8GB |
| RTX 5060 Ti 8GB | 8GB | GDDR7 | 128-bit | 280 GB/s | 16GB 변종과 구분 |
| RTX 5060 Ti 16GB | 16GB | GDDR7 | 128-bit | 448 GB/s | 저가 16GB·FP4 |
| RTX 5070 | 12GB | GDDR7 | 192-bit | 672 GB/s | 신품 대비 당근 프리미엄 구간 |
| RTX 5070 Ti | 16GB | GDDR7 | 256-bit | 896 GB/s | 영상+AI 균형 |
| RTX 5080 | 16GB | GDDR7 | 256-bit | 960 GB/s | |
| RTX 5090 | 32GB | GDDR7 | 512-bit | 1,792 GB/s | 당근 최상위급 희소 |
22.3. 2026-06-15 당근 관측 + 적정 중고 범위
금액 단위: 만 원(₩). 「관측」은 그날 본 호가(복수면 나열), 「적정 범위」는 당근 직거래 기준 정상 체결에 가까운 구간이다.
22.3.1. 10·20시리즈 (레거시·입문)
| 모델 | VRAM | 6/15 관측(만원) | 적정 중고 범위 | AI 참고 |
|---|---|---|---|---|
| GTX 1070 | 8GB | 9 | 8 ~ 11 | 거의 비추. 디스플레이·가벼운 작업만 |
| RTX 2060 | 6GB | 18, 19, 19.5, 20 | 17 ~ 22 | 7B 미만·실험용 |
| RTX 2060 Super | 8GB | (19.5, 8GB 표기 혼재) | 18 ~ 24 | 2060 6GB보다 나으나 12GB 3060이 가성비 |
| RTX 3050 | 8GB | 20, 25 | 19 ~ 27 | 게이밍 입문, LLM은 답답 |
| RTX 3060 12GB | 12GB | 28, 29 | 26 ~ 32 | 저예산 AI 입문 1순위 |
| RTX 3060 8GB | 8GB | (당일 미관측) | 22 ~ 26 | 12GB보다 5~8만 싸면 고려, AI는 12GB 우선 |
| RTX 3070 | 8GB | 29 | 27 ~ 35 | 3060 12GB와 비슷한 가격대면 3060 쪽이 AI 유리 |
| RTX 3070 Ti | 8GB | 60 | 55 ~ 68 | 속도는 좋으나 VRAM 8GB — 가격 대비 AI는 애매 |
| RTX 3080 10GB | 10GB | 40, 48, 52 | 38 ~ 55 | 게이밍 잔존가치. AI는 10GB·대역폭은 나쁘지 않음 |
| RTX 3080 12GB | 12GB | (당일 미관측) | 52 ~ 62 | 10GB보다 10~15만 비싸는 편이 정상 |
22.3.2. 30·40시리즈 (Ampere·Ada 중고)
| 모델 | VRAM | 6/15 관측(만원) | 적정 중고 범위 | AI 참고 |
|---|---|---|---|---|
| RTX 3090 | 24GB | (당일 미관측) | 75 ~ 100 | 24GB 가성비. 전력·발열·AV1 없음 |
| RTX 3090 Ti | 24GB | (당일 미관측) | 88 ~ 108 | 3090 대비 소폭 프리미엄 |
| RTX 4060 | 8GB | 33, 35, 40 | 32 ~ 42 | 3060 12GB가 더 싸면 AI는 3060 |
| RTX 4060 Ti 8GB | 8GB | (당일 미관측) | 36 ~ 44 | 16GB 변종과 가격 차 반드시 확인 |
| RTX 4060 Ti 16GB | 16GB | (당일 미관측) | 46 ~ 58 | 16GB·대역폭 288 GB/s 한계 |
| RTX 4070 Super | 12GB | (당일 미관측) | 58 ~ 70 | 5070 신품과 가격 겹치면 세대·AV1 비교 |
| RTX 4070 Ti Super | 16GB | (당일 미관측) | 72 ~ 88 | Ada 16GB, 5070 Ti 신품과 대조 |
| RTX 4080 Super | 16GB | (당일 미관측) | 100 ~ 140 | 4080·4080 Super 혼용 검색. 5080 중고와 가격 겹치면 세대·AV1 비교 |
| RTX 4090 | 24GB | (당일 미관측) | 230 ~ 320 | 3090(75~100) 대비 고가. 속도·대역폭·Ada 세대 |
22.3.3. 50시리즈 (Blackwell·당일 관측 다수)
| 모델 | VRAM | 6/15 관측(만원) | 적정 중고 범위 | AI 참고 |
|---|---|---|---|---|
| RTX 5060 8GB | 8GB | 44, 46.5, 49, 60 | 42 ~ 62 | 60만은 박스·급처 아니면 고가. 44~52가 밀집 |
| RTX 5060 Ti 8GB | 8GB | 48, 52, 55 | 46 ~ 58 | 16GB 변종보다 싸야 정상 |
| RTX 5060 Ti 16GB | 16GB | (당일 미관측) | 55 ~ 68 | 60만대=16GB 변종 확인 후 강추. 8GB Ti와 혼동 금지 |
| RTX 5070 | 12GB | 70, 80, 100, 105 | 65 ~ 95 | 70만 내외 급처 우선. 90만 넘으면 5070 Ti와 비교 |
| RTX 5070 Ti | 16GB | (당일 미관측) | 100 ~ 125 | 110만 내외 목표. 영상+AI 균형 |
| RTX 5080 | 16GB | 170, 180, 190 | 160 ~ 185 | 170만 내외 목표. 영상·코덱 우선 |
| RTX 5090 | 32GB | 715 | 680 ~ 750 | 희소·프리미엄. 700만 전후가 당근 상단권 |
22.4. VRAM·만원당 가성비 (당근 중고 감각)
같은 돈이면 VRAM부터 본다. 2026년 6월 15일 당근 기준으로 자주 나오는 감각은 아래와 같다.
| 예산(만원) | VRAM을 최대로 | 균형(VRAM+세대) | 세대·기능 우선 |
|---|---|---|---|
| ~25 | 3060 12GB(28~29 관측) | 3060 12GB | 3050은 비추 |
| ~30 | 3060 12GB | 3070(8GB) — AI는 3060 | |
| ~40 | 3080 10GB 또는 4060 | 3060 12GB 여유 구매 | 4060 8GB는 AI 불리 |
| ~55 | 4060 Ti 16GB·5060 Ti 8GB | 5060 Ti 8GB | 3070 Ti 8GB는 VRAM 아깝다 |
| ~60 | 5060 Ti 16GB(60만대) | 4060 Ti 16GB | 3060 12GB |
| ~75 | 3090 24GB(75~100) | 5070 12GB(70만 내외) | 5070 Ti 검토 |
| ~100 | 3090 Ti · 5070 Ti(110만 내외) | 5070 Ti 16GB | 5080(170만+) |
| 230+ | 4090 24GB | 5080 16GB(180+) | 5090은 700만대 별도 |
당근에서 자주 보이는 착시: 3070 Ti(60만)·3080 10GB(40~52만)는 게이밍 벤치만 보면 매력적이지만, LLM은 3060 12GB(28~29만) 가 같은 돈 대비 VRAM이 낫다. 반대로 24GB가 필요하면 3090이 50시리즈 12GB보다 우선이다.
22.5. 세대별 당근 가격대 요약
| 세대 | 당근에서 흔한 가격대(만원) | AI 구매 노트 |
|---|---|---|
| Pascal (1070) | ~10 | AI 목적 비추 |
| Turing·입문 Ampere (2060·3050) | 17 ~ 27 | 실험·부족한 VRAM |
| Ampere 메인 (3060 12G·3070·3080) | 26 ~ 68 | 3060 12G·3090 만 AI 가성비, 3070/3080 10G는 VRAM 주의 |
| Ada (4060·4070·4090) | 32 ~ 320 | 4060 Ti 16GB 변종 확인. 4090은 230만+ |
| Blackwell (5060~5090) | 42 ~ 750 | FP4·AV1. 5060 Ti 16GB 60만대·5070 70만·5070 Ti 110만·5080 170만 목표 |
22.6. 중고 구매 체크 (당근 직거래)
| # | 확인 |
|---|---|
| 1 | 제품 박스·S/N·구매 영수증 — 50시리즈는 도난·리셀 주의가 더 큼 |
| 2 | furmark·3DMark·게임 짧게 — 아티팩트·다운클럭 |
| 3 | 온도·팬 소음 — AI는 24/7 부하 가정 |
| 4 | 12VHPWR·8핀 소켓 상태 — 3090·4090은 전원 단자 확인 |
| 5 | 「마이닝 안 함」 문구만 믿지 말고 VRAM 에러·메모리 테스트 권장 |
| 6 | 가격이 범위 하단 10% 이하면 이유(급처·불량·지역)를 반드시 물어본다 |
23. 상황별 최종 선택표
| 상황 | 추천 방향 |
|---|---|
| 예산 $600~900, 큰 모델이 최우선 | 중고 RTX 3090 24GB |
| 예산 $750, 영상+AI 둘 다 | RTX 5070 Ti 16GB |
| 예산 $430, 16GB·FP4·AV1 체험 | RTX 5060 Ti 16GB |
| 예산 $2,000, 소비자 최상위 | RTX 5090 32GB |
| 전문가·48GB+·ECC | RTX 6000 Ada 48GB 또는 PRO 6000 96GB |
| 게이밍만, AI 안 함 | GPU 세대보다 게임 벤치·가격 비교 |
| 70B 단일 카드·최소 양자화 | 24GB 이상 필수. 12~16GB 카드는 부적합 |
24. 마무리
로컬 AI GPU는 TOPS 숫자보다 VRAM·대역폭·실제 돌릴 모델 크기 순으로 보면 실수가 줄어든다.
- FP4 TOPS와 FP8 TOPS는 직접 비교하지 않는다. sparsity 수치는 dense 기준으로 절반 정도로 본다
- 게이밍 5% 차이와 AI 체감은 다를 수 있다. 12GB 한계는 4070 Super와 5070이 같다
- 세대가 높은 5070도 24GB 3090보다 큰 모델을 올리기는 어렵다. VRAM이 먼저다
- ffmpeg·AV1은 NVENC 세대가 핵심이다. 순수 인코딩은 50시리즈, 편집 앱 AI 효과까지면 VRAM도 본다
- 시스템 RAM 오프로딩은 「돌아가게」는 만들지만 쾌적한 추론 대체가 아니다
- 16GB는 영상+중형 AI, 24GB는 대형 LLM 입문, 32GB·48GB·96GB는 상위 구간이다
- 가격·품귀·중고 상태는 시점마다 변하므로 구매 직전 재확인이 필요하다
- GPU 구매 전 AIB 실제 길이·슬롯 두께·케이스 GPU 클리어런스(304 vs 359mm)를 반드시 대조한다
- 5090·5080은 PSU 1000~1200W·12V-2x6 직선 35mm·측면 패널 클리어런스를 함께 본다
- 24/7 AI는 메쉬 전면·양압·팬 곡선·먼지 필터가 게이밍 케이스 선택보다 중요하다
- RAM 64GB·NVMe 2TB는 GPU 다음으로 체감 큰 투자다. 듀얼 GPU는 슬롯 간격 3칸+·PSU 1200W+
- 당근마켓(2026-06-15): 3060 12GB 28~29만, 5060 Ti 16GB 60만대, 5070 70만 내외, 5070 Ti 110만, 5080 170만, 3090 24GB 75~100만, 5090 700만 전후 — VRAM·세대 먼저, 8GB/10GB 게이밍 잔존가에 속지 않는다
「VRAM으로 카드를 고르고, 치수·PSU·냉각으로 그 카드가 내 케이스에서 24/7 돌아가게 만든다」 — 예산과 작업(LLM·영상·듀얼 GPU)을 정한 뒤 GPU 표와 빌드 체크리스트를 같이 보면 된다.
자주 묻는 질문
- 당근에서 RTX 5060 Ti 16GB가 60만원대면 바로 사도 되나요?
본문 0번 규칙 2번에 해당합니다. 다만 5060 Ti 8GB 와 16GB 변종 가격이 다르니 제목·스펙·박스에서 16GB를 반드시 확인하세요. 60만원대 16GB라면 FP4·AV1·16GB를 한 번에 얻는 올라운드 가성비 구간입니다. 대역폭 448 GB/s라 큰 모델 추론은 5070 Ti보다 답답할 수 있어, 영상+AI 균형이면 5070 Ti(110만 내외)도 같이 봅니다.
- AI 개발·영상 편집용 PC인데 AMD RX 9070 XT 16GB를 사도 되나요?
본문 0번 절 1번·8번 기준으로는 비추입니다. VRAM 16GB·게이밍 가성비는 좋지만 PyTorch·ComfyUI·LLM 주류 스택은 CUDA(NVIDIA)가 문서·호환·속도 면에서 앞섭니다. ffmpeg는 NVENC·av1_nvenc가 NVIDIA 전용입니다. AI+영상 본업이면 당근 5060 Ti 16GB(60만대)·5070 Ti(110만)·3090(75~100만) 등 NVIDIA 라인을 먼저 보는 편이 낭비가 적습니다.
- RTX 5070의 988 TOPS와 4070 Super의 568 TOPS를 바로 비교해도 되나요?
안 됩니다. 5070은 FP4 기준, 4070 Super는 FP8 등 다른 정밀도 기준이 섞여 있을 수 있습니다. sparsity(희소성) 가정이 들어간 이론 최대치이기도 해서, 실제 추론 속도는 VRAM·대역폭·모델 양자화 방식에 더 크게 좌우됩니다.
- 게이밍 성능이 비슷한데 AI만 5070이 유리한 이유는?
게이밍은 CUDA 코어·클럭·래스터 성능 비중이 크고, AI 추론은 텐서 코어 세대·메모리 대역폭·지원 정밀도(FP4 등) 영향이 큽니다. 5070은 GDDR7 672 GB/s와 5세대 텐서 코어를 갖지만 VRAM은 4070 Super와 같이 12GB입니다.
- 중고 RTX 3090이 RTX 5070보다 AI에 나은 경우는?
모델이 12GB를 넘을 때입니다. 3090은 24GB VRAM과 약 936 GB/s 대역폭으로 32B급 Q4·13B FP16 등을 단일 카드로 돌리기 쉽습니다. 5070은 FP4·AV1 등 신기능이 있지만 12GB 한계가 먼저 옵니다.
- ffmpeg 영상 인코딩만 보면 3090과 5070 중 무엇이 좋나요?
순수 GPU 트랜스코딩·AV1보내기는 RTX 5070 계열이 유리합니다. NVENC 9세대와 AV1 하드웨어 인코딩을 지원하고, 3090(Ampere)은 AV1 인코딩이 없습니다. 다빈치 등 편집 앱의 AI 효과를 많이 쓰면 3090의 24GB가 다시 의미 있을 수 있습니다.
- VRAM 16GB 카드 중 영상과 AI를 같이 할 때 무난한 선택은?
RTX 5070 Ti 16GB가 자주 거론됩니다. 896 GB/s GDDR7, FP4, NVENC 9세대·AV1, 16GB를 한 카드에 묶었기 때문입니다. 예산이 낮으면 RTX 5060 Ti 16GB도 FP4·AV1·16GB를 저렴하게 제공하지만 대역폭 448 GB/s로 큰 모델 추론은 느릴 수 있습니다.
- 시스템 RAM을 늘리면 VRAM 부족을 해결할 수 있나요?
완전한 해결은 아닙니다. llama.cpp·Ollama 등은 VRAM 초과분을 RAM에 두는 오프로딩을 지원하지만, PCIe와 DDR5 대역폭이 VRAM보다 수십 배 느려 토큰 생성 속도가 급락합니다. RAM을 늘려도 「더 큰 모델을 쾌적하게」는 어렵고, VRAM이 큰 GPU가 근본 대안입니다.
- 로컬 LLM용 소비자 GPU 1순위는 무엇인가요?
예산과 모델 크기에 따라 다릅니다. 소비자 신품 기준으로는 RTX 5090(32GB·1,792 GB/s·FP4)이 상위이고, 가성비·24GB가 필요하면 중고 RTX 3090이 여전히 후보입니다. 16GB 영역에서는 5070 Ti, 저예산은 5060 Ti 16GB가 논의됩니다.
- RTX 6000 Pro Blackwell과 RTX 5090의 차이는?
RTX PRO 6000 Blackwell은 96GB GDDR7 ECC, 워크스테이션급 전력·MIG·ECC를 제공해 70B FP16·대형 MoE·전문 파인튜닝에 맞습니다. RTX 5090은 32GB·소비자 가격대로 로컬 최상위에 가깝지만 ECC·96GB 용량은 없습니다. 용도가 워크스테이션이면 6000 Pro, 데스크탑 소비자 최대면 5090입니다.
- AI 추론에서 TFLOPS보다 메모리 대역폭이 중요한 이유는?
디코딩(토큰 생성) 단계에서는 매 스텝마다 모델 가중치를 메모리에서 읽어야 해서 연산 유닛보다 메모리 버스 속도에 막히는 경우가 많습니다. 같은 VRAM이라도 5070 Ti(896 GB/s)가 4060 Ti(288 GB/s)보다 체감이 빠른 이유가 여기에 있습니다.
- 12GB GPU로 돌릴 수 있는 LLM 크기는?
대략 7~8B FP16, 13B 전후 Q4KM 양자화가 현실적인 구간으로 알려집니다. 컨텍스트 길이·KV 캐시·도구 오버헤드로 여유가 줄어듭니다. 32B·70B급은 24GB 이상 또는 듀얼 GPU·강한 양자화가 필요합니다.
- AMD RX 9070 XT 16GB는 AI에 쓸 만한가요?
영상·게이밍·AV1에는 강점이 있으나, PyTorch·Stable Diffusion·LLM 주류 스택은 NVIDIA CUDA가 호환·튜토리얼·속도 면에서 유리합니다. ROCm 환경 구축과 모델 호환 확인 비용이 따릅니다. AI를 본격적으로 할 계획이면 NVIDIA를 우선 검토하는 편이 안전합니다.
- 듀얼 RTX 3090은 어떤 경우에 의미가 있나요?
NVLink로 48GB에 가깝게 묶어 70B급 Q4 추론·큰 배치를 노릴 때 커뮤니티에서 쓰입니다. 전력·발열·소음·슬롯·전원·소프트웨어 분할 설정 부담이 큽니다. 단일 5090 32GB나 6000급 워크스테이션 카드와 예산·전력을 비교해야 합니다.
- RTX 5090 파트너 카드는 케이스 GPU 길이 330mm에 들어가나요?
모델마다 다릅니다. 5090 FE는 304mm이지만 MSI Gaming Trio OC는 359mm, PNY 트리플팬은 약 329mm입니다. 케이스 스펙이 330mm면 359mm 카드는 물리적으로 불가능하므로, 구매 전 AIB 제조사 페이지의 Card Dimension을 확인해야 합니다.
- 로컬 AI용 파워 서플라이는 600W·800W·1000W 중 어떻게 고르나요?
GPU TGP와 CPU 피크를 합산한 뒤 지속 부하가 PSU 정격의 50~80%가 되게 잡습니다. RTX 5070 Ti 단일은 750~850W, RTX 4090 단일은 1000W, RTX 5090 단일은 최소 1000W·권장 1200W, 듀얼 3090은 1200W 최소·1600W 권장입니다. AI는 게이밍보다 피크가 길어 여유 와트가 중요합니다.
- 12V-2x6 케이블을 꺾어도 되나요?
커넥터 직후 35~40mm는 직선으로 두는 것이 안전합니다. 그 안에서 급꺾임하면 핀 접촉 불량·국부 발열 위험이 있습니다. 측면 패널이 케이블을 누르면 90° 일체형 어댑터나 수직 장착, PSU 위치 변경을 검토합니다.
- AI 워크스테이션 케이스는 게이밍 케이스와 뭐가 다른가요?
24/7 GPU 부하를 가정해 전면 메쉬·긴 GPU 클리어런스(360mm+), 듀얼 GPU 슬롯 간격, 하드드라이브 케이지 제거, 먼지 필터 점검, 소음보다 냉각 우선이 중요합니다. 유리 패널 위주의 밀폐형 케이스는 지속 부하에서 GPU 온도가 더 높게 나올 수 있습니다.
- 듀얼 GPU 빌드 시 마더보드에서 꼭 볼 것은?
두 PCIe x16 슬롯 사이 물리 간격 3슬롯 이상, 3슬롯 두께 GPU 2장이 실제로 들어가는지, 듀얼 장착 시 2번 슬롯이 x8 이상인지( x4 보드는 피함)입니다. 추론에서는 x8/x8이 x16/x16과 체감 차이가 작다고 알려져 물리 간격이 더 중요합니다.
- 로컬 LLM에 시스템 RAM 32GB vs 64GB 차이는?
모델이 GPU VRAM에 완전히 들어가면 32GB도 동작합니다. 다만 70B 오프로드·영상 편집·브라우저 병행·여러 모델 상주에는 64GB가 안정적입니다. RAM을 늘려도 PCIe 오프로딩 속도 자체는 크게 오르지 않습니다.
- AI용 SSD는 NVMe가 필수인가요?
강력히 권장됩니다. 70B Q4 모델(40GB+)을 HDD에서 읽으면 수 분, SATA SSD는 1분 내외, Gen4 NVMe는 10~20초대로 줄어듭니다. 모델을 자주 바꾸면 체감이 큽니다. 1TB 최소, 여러 모델 보관 시 2~4TB를 봅니다.
- 수직 GPU 장착이 AI 냉각에 도움이 되나요?
케이스마다 다릅니다. 측면 패널과 GPU 팬 사이 50~60mm 이상이면 유리 패널 쪽으로 열이 빠져 도움이 될 수 있고, 간격이 좁으면 오히려 막힙니다. 리저 케이블 품질과 12V-2x6 직선 구간도 함께 확인해야 합니다.
- 오픈 프레임 케이스는 AI에 유리한가요?
다중 GPU·24/7 추론에서는 공기 접촉이 최고로, 온도는 타워보다 낮게 나오는 경우가 많습니다. 대신 소음·먼지·책상 미관이 불리합니다. 단일 GPU·생활 공간이면 메쉬 타워+양호한 팬 곡선으로도 충분한 경우가 많습니다.
- ffmpeg와 LLM을 같은 PC에서 쓸 때 주의점은?
둘 다 GPU를 쓰므로 동시 실행 시 VRAM이 경합합니다. 밤에 ffmpeg NVENC 배치 인코딩, 낮에 LLM 추론처럼 순차 분리가 안전합니다. 영상만 보면 VRAM 12~16GB로 충분하지만 다빈치 AI 효과까지 쓰면 24GB가 편합니다.
- 5090 빌드 시 측면 패널이 안 닫히면?
카드 높이(mm)+35mm 이상의 내부 여유가 필요합니다. AIB 5090은 149~150mm 높이가 흔해 총 184~185mm 클리어런스가 필요합니다. 부족하면 90° 12V-2x6 어댑터, 수직 장착, 더 넓은 케이스, FE(304×137mm) 모델을 검토합니다.
- 당근마켓에서 RTX 3060 12GB와 RTX 3070 중 AI용으로 뭐가 나은가요?
2026년 6월 15일 기준 당근에서는 3060 12GB가 28~29만원, 3070이 29만원대로 비슷하게 보였습니다. VRAM은 3060이 12GB, 3070이 8GB라 LLM·이미지 생성에는 3060 12GB가 보통 유리합니다. 3070은 대역폭은 높지만 8GB 한계가 먼저 옵니다.
- 당근에서 RTX 5070이 80만원과 105만원으로 차이 나는 이유는?
같은 5070 12GB라도 당근 호가는 지역·급처·박스·미개봉·신품 대비 심리 가격으로 편차가 큽니다. 본문 0번 규칙 기준 70만원 내외 급처가 나오면 우선 검토하고, 85~95만원이면 5070 Ti 16GB(110만 내외)와 가격·용도를 비교하는 편이 낫습니다. 100만원 이상은 흔한 상단 구간이라 급하지 않으면 기다려도 됩니다.
- 당근 중고 RTX 3090 적정 가격은 얼마인가요?
6월 15일 스캔에는 3090 매물이 없었지만, 당근 직거래 기준 24GB RTX 3090은 75~100만원 구간에 자주 올라옵니다. AI에서 24GB VRAM이 필요하면 이 구간이 가성비 축입니다. 75만원 미만은 급처·이력·상태를, 100만원 넘으면 3090 Ti·5070 Ti(110만 내외)와 비교하세요. AV1·FP4·신품 보증이 더 중요하면 50시리즈와 만원 단위로 비교합니다. RTX 4090은 230~320만원, 4080 Super는 100~140만원대입니다.
- RTX 3080 10GB가 40만원대인데 AI에 쓸 만한가요?
게이밍 잔존가치로는 매력적이지만 VRAM 10GB라 12GB 3060(28~29만)보다 AI 유연성은 떨어집니다. 7~8B급·일부 13B Q4 정도가 한계에 가깝고, 24GB가 필요하면 3090 쪽이 낫습니다. 영상 트랜스코딩만이면 VRAM 부담은 적습니다.