 바이브 코딩
큐레이터 단비가 KIE의 여러 AI 모델을 코딩 작업에 쓰려다 부딪힌 문제를 처음부터 끝까지 따라갔다. OpenCode에서 화면이 1~3분씩 멈추고 DeepSeek가 두 번째 대화에서 실패하던 증상에서 출발해, 모델별 호환성 실측, 원인 분석, Grok Build 시도, 대중적인 코딩 작업장 비교를 거쳐 Cline CLI·LiteLLM·로컬 보정 게이트웨이 구성에 도착하기까지의 과정을 담았다.
KIE는 모델 회사마다 원래 쓰던 API 형식을 그대로 열어 둔다. Claude는 Anthropic Messages, GPT와 DeepSeek는 OpenAI Responses, Gemini는 모델별 chat/completions 주소를 쓴다. 그래서 한 가지 형식만 아는 코딩 도구는 일부 모델과만 맞고, 같은 모델이라도 도구가 요청을 만드는 방식에 따라 결과가 갈린다. 표의 PASS·FAIL과 오류 문구는 2026년 10월 17일 실측 결과다.
최종 구성은 Cline CLI가 127.0.0.1:4000/v1 주소 하나만 바라보고, LiteLLM이 모델별 KIE 경로로 나눠 보내며, 작은 파이썬 게이트웨이가 키를 넣고 KIE 응답의 빈틈을 메우는 방식이다. 실제 KIE 키는 .env 파일 한 곳에만 두고 다른 설정 파일에는 로컬 전용 더미 키만 들어간다. 설치 파일 구성, 설정 원문, 날마다 쓰는 kc 명령까지 순서대로 따라 하면 된다.
OpenCode 자체를 설치하고 KIE에 연결하는 과정은 KIE + OpenCode 연결 글에 따로 있다. 여기서는 그 다음 단계인 여러 모델을 안정적으로 돌릴 작업장을 고르고 꾸리는 과정을 다룬다.
핵심 포인트: KIE에는 모든 모델을 받는 통합 chat/completions 주소가 없다. LiteLLM으로 주소 하나를 만들고, KIE 응답 형식의 빈틈은 로컬 게이트웨이가 메운다. Luna·DeepSeek·Haiku는 이 구성에서 1턴·2턴·파일 생성을 모두 통과했다.
1. OpenCode에서 겪은 끊김과 모델 문제
출발점은 OpenCode 1.19.3에 KIE 모델을 여러 개 등록해 쓰던 환경이다. 겉으로 보이는 증상은 세 가지였다. 대화 중 화면이 오래 멈추고, 특정 모델은 두 번째 질문부터 실패하며, 목록에 있는 모델을 골랐는데 바로 오류가 났다.
| 증상 | 실측 내용 | 해당 모델 |
|---|---|---|
| 두 번째 대화 실패 | 2턴 400 input.type, 6회 재시도로 약 89초 멈춤 | DeepSeek V4.1 Flash |
| 첫 응답이 매우 느림 | 1턴 78.7초 (KIE 429, 502, 점검 응답 후 재시도로 성공) | GPT-6 Luna |
| 고르자마자 실패 | 호출 시 404 | gpt-5.5 |
| 도구 요청에 엉뚱한 답 | HTTP 200 안에 code 500 또는 도구 무시 | Gemini 3.8 Flash, GPT 5.2 |
| 계속 503 | 세 번 모두 Resources are tight, 각 약 200초 | Claude Code 2.1.302 + Haiku |
- OpenCode는 실패한 요청을 5→8→12→19→40초 간격으로 조용히 다시 보낸다. 오류 문구가 바로 뜨지 않아 화면이 멈춘 것처럼 보인다.
- 같은 OpenCode에서 Grok 4.7과 GPT-6 Luna는 2턴까지 통과했다. 도구가 아니라 모델과 요청 형식의 조합이 문제라는 신호다.
- Claude Code도 KIE가 503을 내는 동안에는 같은 방식으로 오래 멈췄다. KIE가 정상일 때의 Claude Code 결과는 미실측이다.
- 그래서 문제를 KIE 경로 구조, 모델별 API 동작, 도구별 요청 방식으로 나눠 실측했다.
2. KIE 엔드포인트 구조: 모델마다 주소가 다르다
KIE 문서(docs.kie.ai)의 경로를 정리하면 아래와 같다. 같은 키를 쓰지만 모델 계열마다 주소와 형식이 다르고, 서로 섞어 쓸 수 없다.
| 경로 | 형식 | 모델 | 문서상 용도 |
|---|---|---|---|
/anthropic/v1/messages | Anthropic Messages | Claude 13종 | 공식 지원 (Claude Code) |
/openai/v1/responses | OpenAI Responses | GPT-5.4~6.1 9종, DeepSeek·Kimi(목록 밖) | GPT는 Codex CLI 지원, DeepSeek·Kimi는 Chat only |
/xai/v1/responses | Responses | Grok 4.3/4.5/4.6/4.7 | 공식 지원 (Grok Build) |
/<모델>/v1/chat/completions | OpenAI Chat Completions | Gemini(openai판), GPT 5.2 | 전부 Chat only |
/gemini/v1/models/<모델>:streamGenerateContent | Gemini 네이티브 | Gemini 3.5~4 Argon | 전부 Chat only |
/openai/v1/chat/completions | 공통 chat/completions | 없음 | HTTP 200인데 본문은 code 422 The model is not supported |
- Anthropic 경로로 GPT를 부르면 Responses 형식으로 응답이 오고, 도구 요청은 400이 난다. 반대 방향도 400이다.
gpt-5.5는/openai/v1/models목록에 남아 있지만 호출하면 404다. 오류 문구는 "2026-10-14 retired, GPT-6.1 Sol 또는 GPT-6 Luna를 쓰라"이다. KIE의 Codex 설정 예시도 아직 gpt-5.5라서 그대로 따라 하면 실패한다.- KIE 표준 단가는 1크레딧 $0.005이고, 응답마다
credits_consumed가 붙는다. - 대중적인 코딩 도구는 대부분 OpenAI 호환 chat/completions 주소 하나를 기본으로 쓴다. KIE에는 그 공통 주소가 없다는 점이 이후 모든 선택의 출발점이다.
3. 모델별 호환성 실측 매트릭스
API를 직접 호출한 결과다. 1턴은 질문 하나, 2턴은 앞 대화를 이어 붙인 두 번째 질문, 도구는 도구 호출 뒤 결과를 넣어 다음 답을 받는 왕복, 스트림은 스트리밍 응답이다.
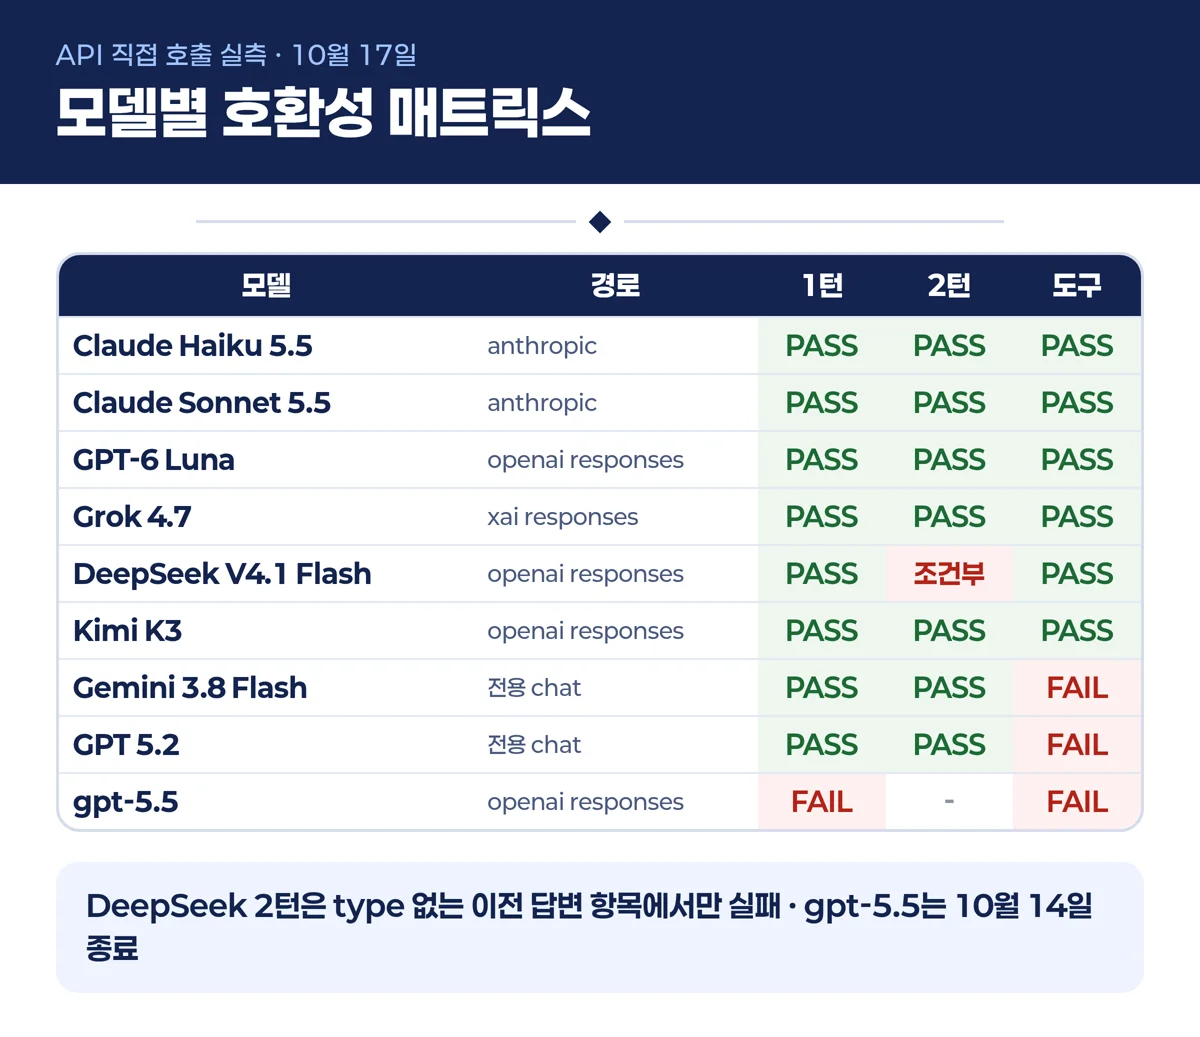 그림 1. KIE 모델별 API 직접 호출 결과. DeepSeek 2턴은 이전 답변 항목 형식에 따라 갈린다.
| 모델 | 경로 | 1턴 | 2턴 | 도구 | 스트림 | 비고 |
|---|---|---|---|---|---|---|
| claude-haiku-5-5 | anthropic messages | PASS | PASS | PASS | PASS | 15:40 이후 429/503 |
| claude-sonnet-5-5 | anthropic messages | PASS | PASS | PASS | - | 15:40 이후 429 |
| gpt-6-luna | openai responses | PASS | PASS | PASS | PASS | |
| gpt-5.5 | openai responses | FAIL | - | FAIL | FAIL | 404, 퇴역 모델이 목록에 남아 있음 |
| grok-4-7 | xai responses | PASS | PASS | PASS | PASS | |
| deepseek-v4-1-flash | openai responses | PASS | PASS / FAIL | PASS | PASS | type 없는 assistant 항목일 때만 FAIL |
| kimi-k3 | openai responses | PASS | PASS | PASS | - | Chat only 표기 |
| gemini-3-8-flash | 전용 chat/completions | PASS | PASS | FAIL | PASS | 도구 요청 시 HTTP 200 + code 500 |
| gpt-5-2 | 전용 chat/completions | PASS | PASS | FAIL | - | 도구를 무시하고 임의 날씨로 답함 |
같은 모델을 실제 코딩 작업장에 붙인 결과는 아래와 같다.
| 작업장 | 모델 | 1턴 | 2턴 | 파일 쓰기 | 비고 |
|---|---|---|---|---|---|
| OpenCode 1.19.3 | deepseek-v4-1-flash | PASS | FAIL | - | 2턴 400 input.type, 6회 재시도로 약 89초 멈춤 |
| OpenCode + type 보정 중계 | deepseek-v4-1-flash | PASS | PASS | - | 이전 답변 항목에 type:"message"만 추가 |
| OpenCode 1.19.3 | grok-4-7 | PASS | PASS | - | |
| OpenCode 1.19.3 | gpt-6-luna | PASS | PASS | - | 1턴 78.7초 |
| Grok Build 1.0.62 | grok-4-7 | PASS | PASS | PASS | 20초 / 12초 / 24초 |
| Grok Build 1.0.62 | gpt-6-luna | FAIL | FAIL | - | 스트림 이벤트 해석 실패 |
| Grok Build 1.0.62 | deepseek | FAIL | FAIL | - | 400 Upstream service error |
| Claude Code 2.1.302 | claude-haiku-5-5 | FAIL | FAIL | FAIL | 세 번 모두 KIE 503 Resources are tight |
- API 자체로는 Claude, GPT-6 Luna, Grok, Kimi가 도구 왕복까지 모두 통과했다. DeepSeek도 형식만 맞추면 통과한다.
- Gemini 3.8 Flash와 GPT 5.2는 KIE 문서의 Chat only 표기대로 도구 왕복에서 실패했다. 코딩 작업처럼 파일을 읽고 쓰는 용도에는 맞지 않는다.
- 작업장 결과가 API 결과보다 나쁜 이유는 대부분 도구가 요청을 만드는 방식과 KIE 응답 형식의 작은 차이에서 나왔다. 다음 절에서 하나씩 짚는다.
4. 원인 분석: DeepSeek 형식 결함과 KIE 서버 오류
끊김의 원인은 근거가 있는 것만 다섯 가지로 좁혀졌다. 그중 DeepSeek는 도구마다 다른 결함이 드러나 네 가지 보정이 필요했다.
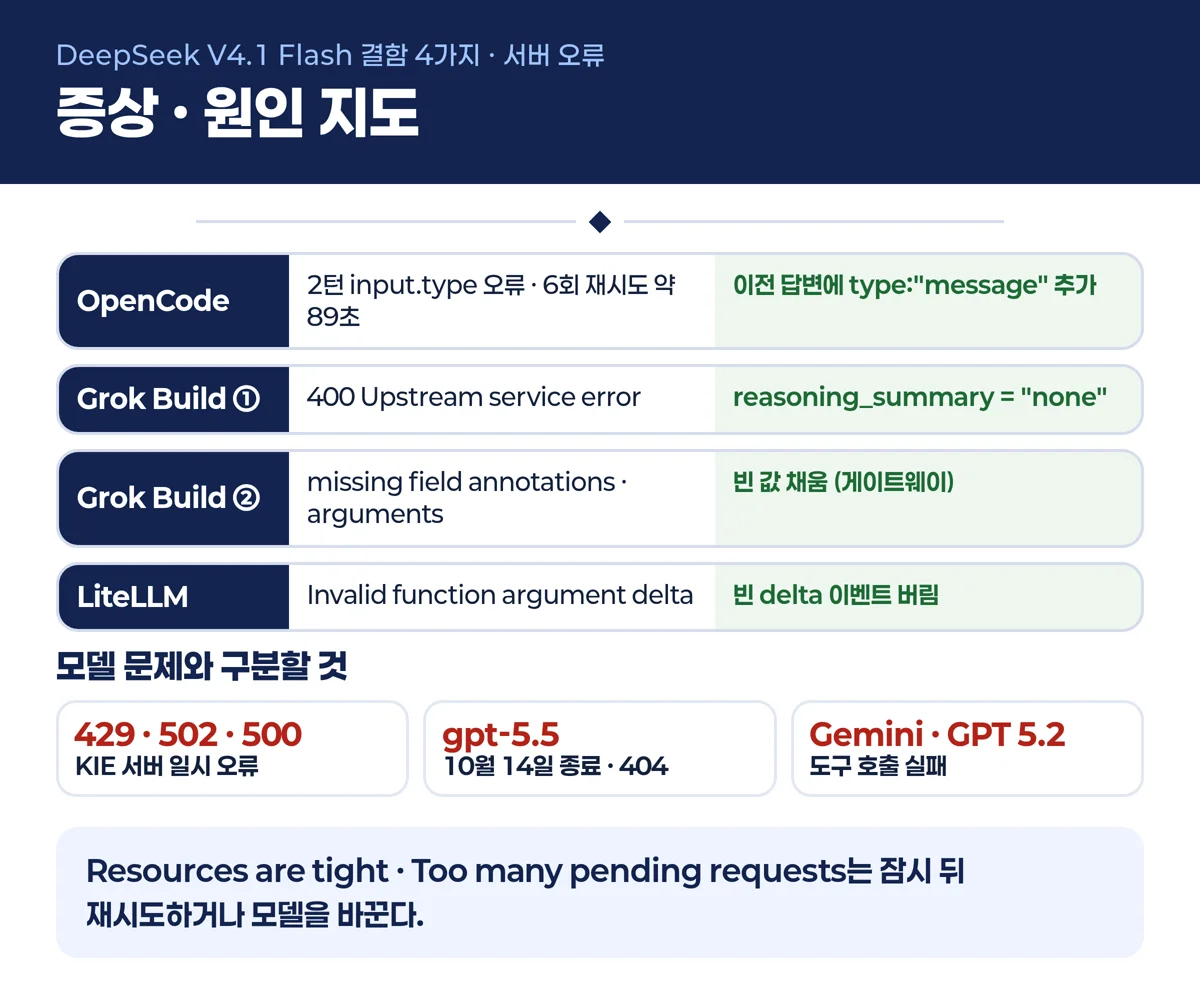 그림 2. 도구별로 드러난 DeepSeek V4.1 Flash 결함 네 가지와, 모델 문제와 구분해야 할 KIE 서버 오류.
| 증상 | 원인 | 해결 |
|---|---|---|
OpenCode 2턴 Missing required parameter: input.type | 이전 답변을 {"role":"assistant","content":[{"type":"output_text",...}]}로 보내는데 "type":"message"가 없음 | 게이트웨이가 role만 있고 type이 없는 입력 항목에 type:"message" 추가 |
Grok Build API error (status 400 Bad Request): Upstream service error | Grok이 보내는 reasoning.summary: "concise" | Grok 설정에 reasoning_summary = "none" |
Grok Build serialization error: missing field 'annotations' | KIE 응답의 output_text에 annotations 필드 없음 | 게이트웨이가 annotations: [] 채움 |
Grok Build serialization error: missing field 'arguments' | 도구 호출 항목에 arguments 없음 | 게이트웨이가 arguments: "" 채움 |
LiteLLM Invalid function argument delta | 스트림에 response.functioncallarguments.delta가 delta:""(빈 값)로 옴 | 게이트웨이가 빈 delta 이벤트를 버림 |
Grok Build + Luna serialization error: unknown variant 'response.metadata' | KIE가 보내는 response.metadata 이벤트를 도구가 모름 | 게이트웨이가 해당 이벤트를 버림 |
| 화면 1~3분 멈춤 | KIE 429 Too many pending requests, 502(Cloudflare), HTTP 200 안의 response.failed(점검 중 문구), 503 Resources are tight | 잠시 뒤 재시도하거나 다른 회사 모델로 전환 |
| 고르자마자 404 | gpt-5.5 퇴역(2026-10-14) | GPT-6 Luna 또는 GPT-6.1 Sol로 교체 |
| 도구 요청에 빈 답이나 엉뚱한 답 | Chat only 모델(Gemini, GPT 5.2) | 코딩 작업 목록에서 제외 |
- DeepSeek 2턴 오류는 KIE 문서와 실제 동작이 다른 사례다. 문서에는 type을 생략해도 된다고 되어 있지만, 같은 요청에
"type":"message"한 줄만 붙이면 통과했다. Kimi, GPT-6 Luna, Grok 4.7은 type 없는 형태도 그대로 받았다. - 15:40~15:55 KST 사이에는 Claude 경로가 계속 429/503이었다. 이런 서버 오류는 모델 설정 문제와 구분해서 봐야 한다.
- DeepSeek와 GPT는 첫 응답이 70~80초 걸린 적이 있다. 기본 추론 설정과 서버 재시도 때문으로 보이지만 원인은 확정되지 않았다.
- 결론적으로 코딩 도구 쪽 설정만으로는 DeepSeek를 고칠 수 없고, 요청과 응답 사이에서 형식을 고쳐 주는 중계가 필요하다.
5. Grok Build 시도 결과
KIE 공식 문서에 Grok Build 연결법이 있어 다음 후보로 Grok Build 1.0.62를 시험했다. Grok 4.7 하나만 놓고 보면 가장 깔끔했지만, 다른 회사 모델로 넓히자 조건이 붙기 시작했다.
| 모델 | Grok 설정 | 1턴 | 2턴 기억 | 파일 생성 | 결과 / 오류 원문 |
|---|---|---|---|---|---|
| Grok 4.7 | responses, /xai/v1, 직접 | PASS | PASS | PASS | 20초 / 12초 / 24초 |
| Kimi K3 | responses, /openai/v1, 직접 | PASS | PASS | PASS | 수정 불필요 |
| GPT-6 Luna | responses, /openai/v1 | PASS* | PASS* | FAIL(KIE) | *게이트웨이 필요. 직접 연결은 serialization error: unknown variant 'response.metadata'. 파일 테스트는 2회 모두 KIE 429 Too many pending requests |
| DeepSeek V4.1 Flash | responses + reasoning_summary="none" | PASS* | PASS* | PASS* | *게이트웨이 필요 |
| Claude Haiku 5.5 | messages, /anthropic/v1, 직접 | 응답 옴 | FAIL(KIE) | PASS | 2턴은 KIE api_error: Internal error(429) |
| Claude Sonnet 5.5 | messages, /anthropic/v1, 직접 | FAIL(KIE) | PASS | 미실측 | 1턴은 KIE Internal error |
| Gemini 3.8 Flash | chat_completions, 전용 경로 | FAIL | - | - | 매번 HTTP 200 + code 500 Internal Error, 200초 시간 초과 |
- Grok Build의 Responses 백엔드는 입력 항목에
type:"message"를 붙여 보내므로 OpenCode식 input.type 오류는 나지 않는다. Messages 백엔드는 env_key 값을Authorization: Bearer로 보내 KIE가 그대로 받는다. - 제목과 요약은 별도 호출로 내장 이름
grok-4.6을 사용자 정의 주소에 보낸다. KIE는 404나 500으로 거절해 33회 헛호출이 생겼다(과금 없음). 문서상[models] session_summary = "kie-grok"설정으로 막을 수 있으나 이 설정의 효과는 미실측이다. - Kimi K3는 Grok Build의 긴 프롬프트에서 9회에 27.7크레딧이 들었다. 다른 모델은 회당 0.01~0.2크레딧이었다.
- Grok·Kimi·Claude는 바로 연결되고 Luna·DeepSeek는 게이트웨이가 필요해, 모델마다 설정 블록과 연결 방식이 달라진다. 더 널리 쓰이는 도구에서 주소 하나로 묶는 방법을 찾게 된 이유다.
Grok Build에서 DeepSeek를 쓰던 설정 블록은 아래와 같다. 게이트웨이가 키를 넣기 때문에 envkey에는 아무 값이나 든 변수 이름(예: KIEDUMMY_KEY)을 적는다.
[model.kie-deepseek]
# 직접 연결 시: 400 Upstream service error(reasoning.summary) -> reasoning_summary="none"
# 그다음 missing field `annotations` / `arguments` -> 게이트웨이가 빈 값을 채움
model = "deepseek-v4-1-flash"
base_url = "http://127.0.0.1:8787/openai/v1"
api_backend = "responses"
reasoning_summary = "none"
env_key = "KIE_DUMMY_KEY"
name = "KIE DeepSeek V4.1 Flash (gw)"
위 블록의 8787 포트는 Grok Build 시험 때의 값이다. 아래 최종 구성에서는 Cline hub 대시보드가 8787을 쓰기 때문에 게이트웨이를 8788로 옮겼다.
6. 대중적인 코딩 작업장 비교
주소 하나로 여러 모델을 고르는 방식이 가장 잘 되는 도구를 찾기 위해 인기 지표와 지원 형식을 비교했다. 인기 수치는 2026년 10월 17일 16시대 GitHub 별 수와 VS Code 설치 수다.
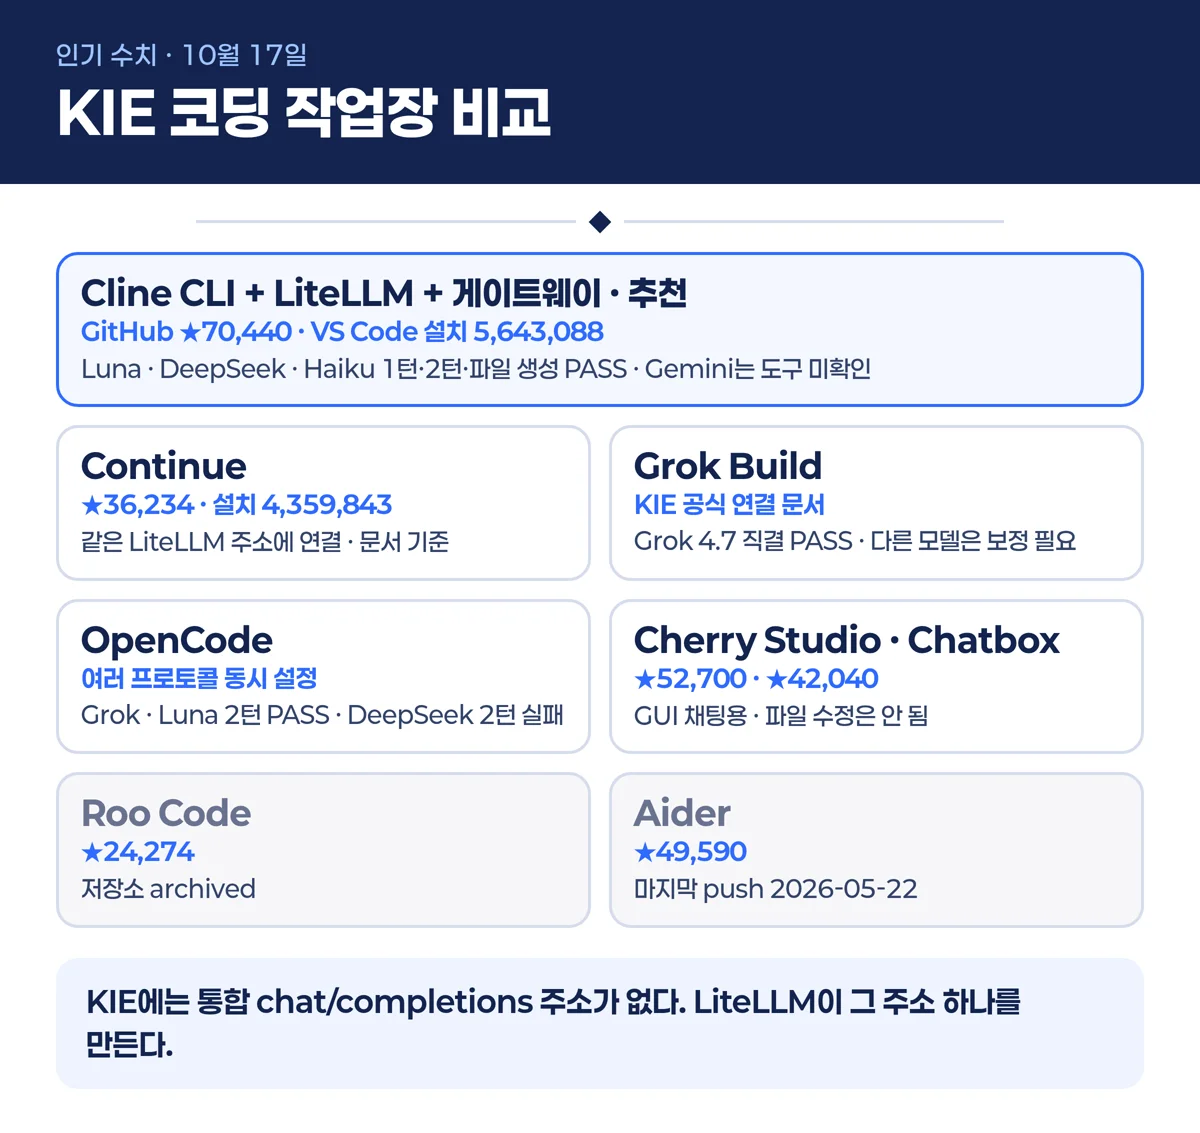 그림 3. 인기 지표와 KIE 연결 결과로 본 코딩 작업장 비교.
| 도구 | GitHub 별 | VS Code 설치 | 상태 | KIE 연결 결과 |
|---|---|---|---|---|
| Cline (CLI + VS Code 확장) | 70,440 | 5,643,088 | 활발 | LiteLLM 경유 Luna·DeepSeek·Haiku 1턴·2턴·파일 생성 PASS |
| Continue (VS Code 확장 / cn CLI) | 36,234 | 4,359,843 | 활발 | 같은 LiteLLM 주소를 provider: openai로 연결 (문서 기준) |
| Cherry Studio | 52,700 | - | GUI 채팅 | OpenAI 호환 공급자에 LiteLLM 주소 (문서 기준) |
| Chatbox | 42,040 | - | GUI 채팅 | OpenAI 호환 공급자에 LiteLLM 주소 (문서 기준) |
| Aider | 49,590 | - | 마지막 push 2026-05-22 | 제외 |
| Kilo Code | 27,627 | 1,636,707 | Cline 계열 | 설정이 Cline과 같음 (미실행) |
| Roo Code | 24,274 | - | 저장소 ARCHIVED, 마지막 push 2026-05-15 | 제외 |
| LiteLLM | 61,411 | - | 활발 | 여러 공급자를 OpenAI 호환 주소 하나로 묶는 프록시 |
도구별로 어떤 형식을 지원하는지도 갈린다. ✅는 문서와 실측으로 확인된 것, △는 문서상 존재하지만 KIE 경로로는 미확인인 것이다.
| 도구 | Anthropic + 사용자 Base URL | OpenAI Responses + 사용자 URL | OpenAI 호환 chat/completions | Gemini 네이티브 | LiteLLM 경유 |
|---|---|---|---|---|---|
| Cline | ✅ | △ | ✅ | △ | 4모델 (실측 3모델 통과) |
| Continue | ✅ | 미확인 | ✅ | 미확인 | 4모델 (문서 기준) |
| Kilo Code | Cline과 동일 계열 | 미확인 | ✅ | 미확인 | 4모델 (문서 기준) |
| Cherry Studio | ✅ | △ | ✅ | ✅ (문서 기준) | 4모델 |
| Chatbox | ✅ | 미확인 | ✅ | △ | 4모델 |
| OpenCode | ✅ | ✅ | ✅ | - | - |
- 대부분의 도구는 OpenAI 호환 chat/completions가 가장 확실하게 된다. KIE의 네 모델은 Responses, Messages, 모델별 chat/completions로 형식이 제각각이라 LiteLLM이 그 사이를 잇는다.
- Cline은 별 수와 설치 수 모두 가장 높고, CLI 설정을 VS Code 확장과 공유한다(README 기준). 터미널과 편집기에서 같은 모델 목록을 쓸 수 있다.
- Roo Code는 저장소가 archived 상태이고 Aider는 5월 이후 push가 없어 새로 들이기에는 부담이 크다.
- Cherry Studio와 Chatbox는 채팅 전용이라 파일 수정이나 명령 실행은 안 된다. 대화만 할 때 고르는 선택지다.
7. 최종 구성: Cline CLI + LiteLLM + 로컬 보정 게이트웨이
선택한 구성은 Cline CLI 3.0.73 → LiteLLM 1.105.1(127.0.0.1:4000/v1) → kie_gateway(127.0.0.1:8788) → api.kie.ai다. Cline은 모델 ID만 바꾸고, LiteLLM이 모델별 KIE 경로와 형식으로 바꿔 보내며, 게이트웨이가 키 주입과 응답 보정을 맡는다.
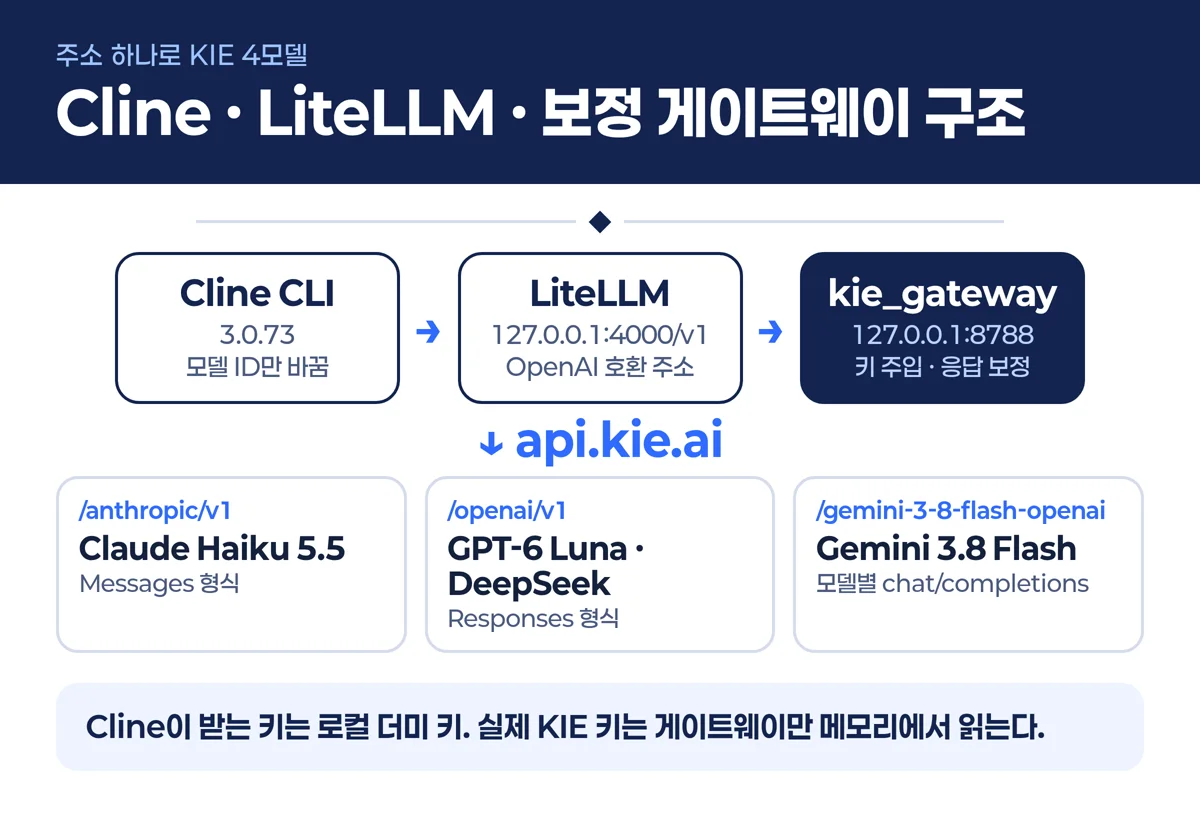 그림 4. Cline이 주소 하나로 KIE 네 모델을 쓰는 구조. 실제 키는 게이트웨이만 메모리에서 읽는다.
| 모델 ID | 1턴 | 2턴 기억 | 파일 생성(도구 호출) | 비고 |
|---|---|---|---|---|
| kie-luna (GPT-6 Luna) | ✅ 37s | ✅ 3.6s (LiteLLM 직접) | ✅ hello.txt 13B, 64s | KIE 429·502가 자주 나서 1회 재시도로 통과 |
| kie-deepseek (DeepSeek V4.1 Flash) | ✅ 5s | ✅ 3.6s (LiteLLM 직접) | ✅ 13s | 빈 delta 보정 추가 후 통과 |
| kie-haiku (Claude Haiku 5.5) | ✅ 9s | ✅ 5.9s (LiteLLM 직접) | ✅ 61s | 가장 안정적 |
| kie-gemini (Gemini 3.8 Flash) | ❌ | ❌ 180s 타임아웃 | 미시도 | 당일 KIE가 Gemini 요청을 전부 code 500으로 반환, 도구 지원 여부 미판정 |
- Cline CLI는 헤드리스로 세션을 이어갈 수 없다.
--id <세션>을 주면 TTY가 필요한 대화형 모드로만 열린다. 그래서 2턴 기억은 Cline이 쓰는 경로와 같은 LiteLLM :4000에 대화 이력을 넣어 측정했다. - Cline의 작업 루프는 작업마다 이력을 포함해 여러 번 요청한다. 파일 생성에서 Haiku는 4회, DeepSeek는 2회, Luna는 4회 이상 요청했다. TUI(
cline -i)나 VS Code 확장에서는 대화가 자연스럽게 이어진다. - Gemini는 네이티브 경로 4회도
{"code":500,"msg":"Server exception"}(33s, 45s)과{"code":500,"msg":"Internal Error"}였다. 오전에는 도구 없는 chat/completions가 통과했으므로 당일 KIE 측 장애로 보이며, 도구 호출 지원 여부는 서버 정상 시 다시 판정해야 한다. - LiteLLM 버그 #19137(
openai/responses/접두사 문제)은 1.105.1에서 재현되지 않았다.
전체 설치는 다섯 단계다. 예시 폴더는 C:\kie-cline 이며, 다른 위치를 쓰면 이후 경로를 같은 값으로 바꾼다.
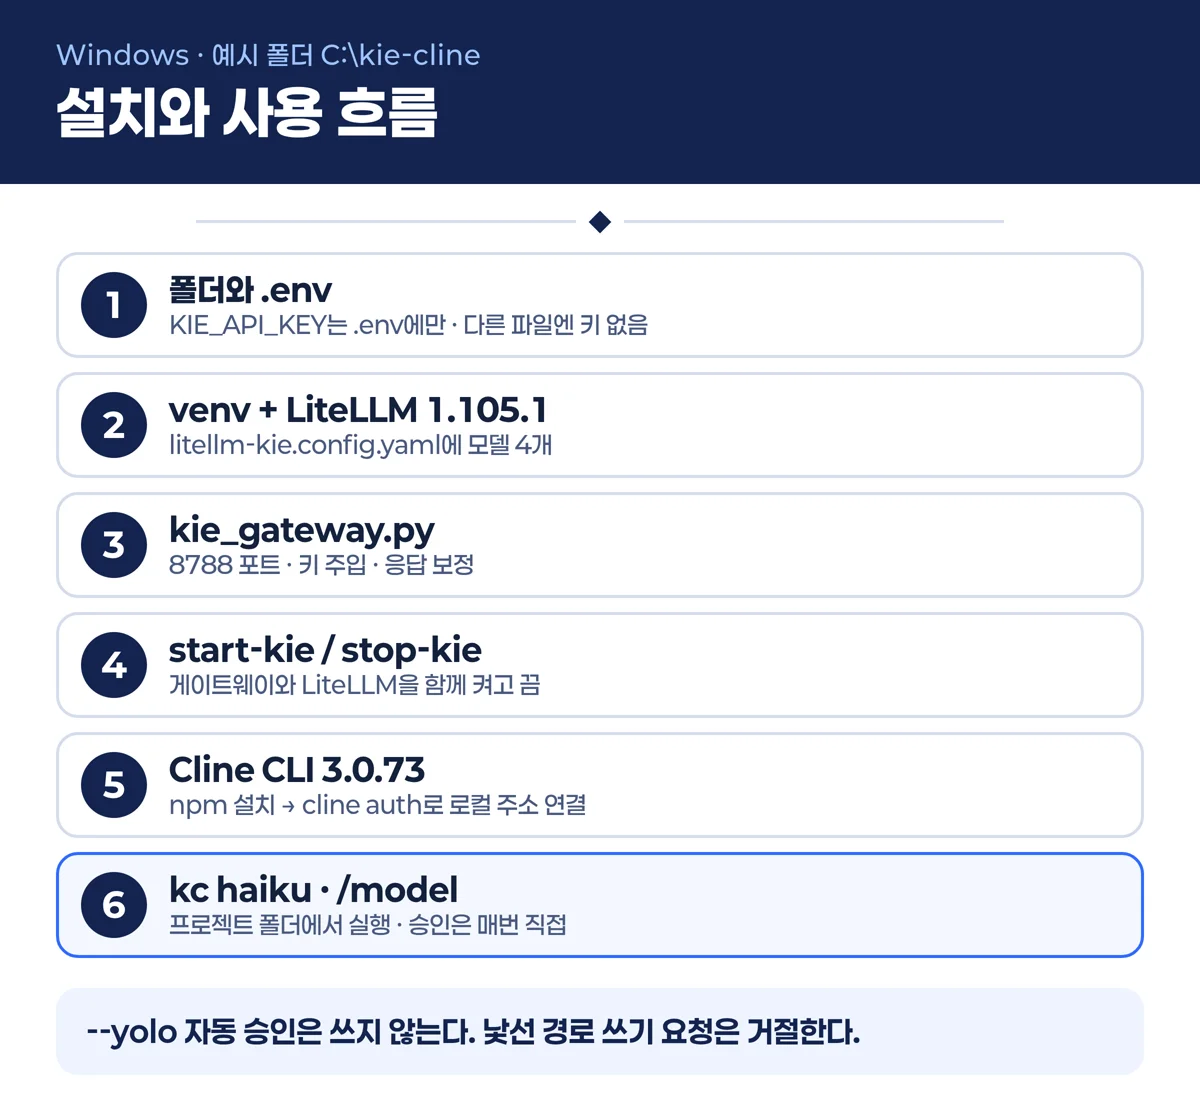 그림 5. 폴더 준비부터 kc 실행까지 설치와 사용 흐름.
| 단계 | 할 일 | 결과물 | 완료 기준 |
|---|---|---|---|
| 1 | 폴더 만들고 .env에 KIE 키 저장 | C:\kie-cline\.env | 키는 이 파일에만 있음 |
| 2 | venv에 LiteLLM 설치, 설정 파일 작성 | venv\, litellm-kie.config.yaml | litellm 실행 파일 존재 |
| 3 | 보정 게이트웨이 저장 | gateway\kie_gateway.py | 8788 포트 대기 |
| 4 | 시작·종료 스크립트 저장 | kie-ctl.ps1, start-kie.cmd, stop-kie.cmd | ready 문구 출력 |
| 5 | Cline CLI 설치와 연결, kc 런처 저장 | cline, kc.cmd, kc.ps1 | say hi에 답이 옴 |
8. 설치 1: 폴더 구성과 키 파일
먼저 작업 폴더와 파일 배치를 정한다. 키가 들어가는 파일은 .env 하나뿐이고, 나머지 파일에는 실제 키가 없다.
| 경로 (예시) | 역할 | 키 포함 |
|---|---|---|
| C:\kie-cline\.env | KIEAPIKEY 한 줄 | 있음 (이 파일만) |
| C:\kie-cline\venv\ | LiteLLM이 설치된 파이썬 가상환경 | 없음 |
| C:\kie-cline\litellm-kie.config.yaml | 모델 4개 목록, 로컬 더미 키 | 없음 |
| C:\kie-cline\gateway\kie_gateway.py | 키 주입·응답 보정 게이트웨이 | 없음 (실행 시 .env에서 읽음) |
| C:\kie-cline\kie-ctl.ps1, start-kie.cmd, stop-kie.cmd | 서버 시작·종료·상태 | 없음 |
| C:\kie-cline\kc.cmd, kc.ps1 | Cline 실행 런처 | 없음 |
| C:\kie-cline\run\ | 실행 중 프로세스 번호(pid) | 없음 |
| C:\kie-cline\workspace\ | 런처를 이 폴더에서 실행할 때의 작업 폴더 | 없음 |
.env 파일은 아래 한 줄이다. 오른쪽에 KIE에서 발급받은 키를 넣는다. 게이트웨이는 KIEAPI 또는 KIEAPI_KEY 이름을 모두 읽는다.
KIE_API_KEY=여기에_KIE에서_발급받은_키- .env는 Git 저장소 안에 두지 않거나 .gitignore에 넣는다. 다른 위치의 파일을 쓰려면 환경변수
KIEENVFILE에 그 경로를 지정한다. - 키 값은 화면에 출력하지 않는다. 게이트웨이도 키를 찾지 못하면 값 없이 안내 문구만 띄우고 멈춘다.
- 설정 파일에 들어가는
sk-local-kie는 LiteLLM 로컬 전용 더미 키이고 KIE 키가 아니다. - 키가 채팅이나 문서에 노출된 적이 있다면 KIE에서 폐기하고 새로 발급받아 .env만 바꾼다.
9. 설치 2: LiteLLM 설치와 모델 설정
LiteLLM은 여러 AI 공급자를 OpenAI 호환 주소 하나로 묶는 오픈소스 프록시다. 여기서는 KIE의 서로 다른 세 가지 형식을 127.0.0.1:4000/v1 하나로 모으는 역할을 한다.
아래 영상은 LiteLLM을 여러 LLM 공급자를 하나의 API로 관리하는 오픈소스 게이트웨이로 소개하는 8분 남짓의 영어 영상이다. 프록시가 어떤 식으로 모델을 묶는지 먼저 감을 잡을 때 보면 된다.
PowerShell에서 가상환경을 만들고 LiteLLM proxy 1.105.1을 설치한다.
mkdir C:\kie-cline
cd C:\kie-cline
py -m venv venv
.\venv\Scripts\python.exe -m pip install "litellm[proxy]==1.105.1"
설정 파일 litellm-kie.config.yaml 원문이다. api_key 자리는 모두 dummy이고 실제 키는 게이트웨이가 넣는다.
# LiteLLM: KIE 4 models behind one OpenAI-compatible address http://127.0.0.1:4000/v1
# No real key here. gateway\kie_gateway.py (127.0.0.1:8788) adds the KIE key from .env.local in memory.
# Client key = master_key below (local dummy).
model_list:
  - model_name: kie-luna            # GPT-6 Luna  -> KIE /openai/v1/responses
    litellm_params:
      model: openai/responses/gpt-6-luna
      api_base: http://127.0.0.1:8788/openai/v1
      api_key: dummy
  - model_name: kie-deepseek        # DeepSeek V4.1 Flash -> KIE /openai/v1/responses
    litellm_params:
      model: openai/responses/deepseek-v4-1-flash
      api_base: http://127.0.0.1:8788/openai/v1
      api_key: dummy
  - model_name: kie-haiku           # Claude Haiku 5.5 -> KIE /anthropic/v1/messages
    litellm_params:
      model: anthropic/claude-haiku-5-5
      api_base: http://127.0.0.1:8788/anthropic
      api_key: dummy
  - model_name: kie-gemini          # Gemini 3.8 Flash -> KIE /gemini-3-8-flash-openai/v1/chat/completions
    litellm_params:
      model: openai/gemini-3-8-flash
      api_base: http://127.0.0.1:8788/gemini-3-8-flash-openai/v1
      api_key: dummy
litellm_settings:
  drop_params: true
  num_retries: 0                    # Cline retries on its own; avoid double retries (credits)
  request_timeout: 300
  telemetry: false
router_settings:
  num_retries: 0
general_settings:
master_key: sk-local-kie # local-only dummy, NOT the KIE key| 항목 | 값 | 의미 |
|---|---|---|
| model_name | kie-luna, kie-deepseek, kie-haiku, kie-gemini | Cline에서 고르는 모델 ID |
| model | openai/responses/…, anthropic/…, openai/… | LiteLLM이 쓸 형식과 KIE 모델 이름 |
| api_base | 127.0.0.1:8788 아래 KIE 경로 | 게이트웨이를 거쳐 KIE로 감 |
| num_retries | 0 | Cline이 스스로 재시도하므로 이중 재시도(크레딧 낭비) 방지 |
| request_timeout | 300 | KIE 응답이 느릴 때 끊기지 않게 함 |
| master_key | sk-local-kie | 로컬 전용 더미 키, KIE 키 아님 |
- 첫 줄 주석의 .env.local은 원본 환경의 파일 이름이다. 이 글의 예시 구성에서는 C:\kie-cline\.env가 같은 역할을 한다.
- 모델을 추가하거나 바꿀 때는
model_list만 고친 뒤 stop → start로 다시 켠다. - Responses 형식 모델은
openai/responses/접두사, Claude는anthropic/, 모델별 chat/completions 주소는openai/접두사를 쓴다. - KIE 경로를 섞으면 400이 나므로 api_base의 경로는 표의 엔드포인트와 정확히 맞춘다.
10. 설치 3: 로컬 보정 게이트웨이
게이트웨이는 파이썬 표준 라이브러리만 쓰는 약 120줄짜리 중계 서버다. 127.0.0.1:8788에서 요청을 받아 같은 경로로 api.kie.ai에 넘기고, 오가는 내용 중 KIE 형식의 빈틈만 고친다.
| 동작 | 대상 | 이유 |
|---|---|---|
클라이언트 인증 헤더 제거 후 Authorization: Bearer <KIE 키> 추가 | 모든 요청 | 도구에는 더미 키만 주고 실제 키는 메모리에만 둠 |
role만 있고 type 없는 입력 항목에 type:"message" 추가 | /responses 요청 | DeepSeek 2턴 input.type 오류 |
response.metadata 이벤트 버림 | 스트림 응답 | GPT-6 Luna, 도구가 모르는 이벤트 |
delta:""인 functioncallarguments.delta 이벤트 버림 | 스트림 응답 | LiteLLM Invalid function argument delta |
outputtext에 annotations: [], functioncall에 arguments: "" 채움 | 응답 | DeepSeek 필드 누락 |
| 요청·응답 기록 안 함, 포트가 사용 중이면 종료 | 실행 | 키·내용 유출 방지, 중복 실행 방지 |
C:\kie-cline\gateway\kie_gateway.py 전체 코드다. 기본 키 파일 경로는 예시 폴더 기준이다.
# -*- coding: utf-8 -*-
"""KIE local gateway for Cline/LiteLLM (127.0.0.1:8788 -> https://api.kie.ai).
- Reads KIE_API from C:\\kie-cline\\.env into memory only (never printed/logged/saved).
- Replaces any client auth (dummy key) with Authorization: Bearer <KIE key>.
- Response fixes: drop SSE 'response.metadata' (GPT Luna), drop empty function_call_arguments.delta (DeepSeek+LiteLLM),
  add annotations:[] / arguments:"" (DeepSeek), add type:"message" to Responses input items without type.
- No request/response logging. Exits if the port is already in use (no duplicate instance)."""
import json, os, sys, threading, urllib.request, urllib.error
from http.server import BaseHTTPRequestHandler, ThreadingHTTPServer

ENV_FILE = os.environ.get("KIE_ENV_FILE", r"C:\kie-cline\.env")
BASE = "https://api.kie.ai"
PORT = int(os.environ.get("KIE_GW_PORT", "8788"))
DROP = {"response.metadata"}

def _load_key():
    try:
        with open(ENV_FILE, encoding="utf-8-sig") as f:
            for line in f:
                line = line.strip()
                if not line or line.startswith("#") or "=" not in line: continue
                k, v = line.split("=", 1)
                if k.strip().replace("export ", "") in ("KIE_API", "KIE_API_KEY"):
                    v = v.strip().strip('"').strip("'")
                    if v: return v
    except OSError:
        pass
    return ""

_KEY = _load_key()

def _add_annot(o):
    if isinstance(o, dict):
        if o.get("type") == "output_text" and "annotations" not in o: o["annotations"] = []
        if o.get("type") == "function_call" and "arguments" not in o: o["arguments"] = ""
        for v in o.values(): _add_annot(v)
    elif isinstance(o, list):
        for v in o: _add_annot(v)

def _fix_body(path, body):
    if not body or not path.split("?")[0].endswith("/responses"): return body
    try:
        j = json.loads(body)
        for it in j.get("input") or []:
            if isinstance(it, dict) and "role" in it and "type" not in it: it["type"] = "message"
        return json.dumps(j, ensure_ascii=False).encode("utf-8")
    except Exception:
        return body

def _process_event(ev):
    """Return fixed event bytes, or None to drop it."""
    t = ""; out = []
    for ln in ev.split(b"\n"):
        if ln.startswith(b"event:"):
            t = ln[6:].strip().decode("utf-8", "replace")
        elif ln.startswith(b"data:"):
            try:
                j = json.loads(ln[5:].strip())
                jt = j.get("type", "") if isinstance(j, dict) else ""
                if not t: t = jt
                if jt == "response.function_call_arguments.delta" and j.get("delta") == "": return None
                _add_annot(j)
                ln = b"data: " + json.dumps(j, ensure_ascii=False).encode("utf-8")
            except Exception:
                pass
        out.append(ln)
    if t in DROP: return None
    return b"\n".join(out)

class H(BaseHTTPRequestHandler):
    protocol_version = "HTTP/1.0"
    def log_message(self, *a): pass
    def _fwd(self, method):
        n = int(self.headers.get("Content-Length") or 0)
        body = _fix_body(self.path, self.rfile.read(n) if n else None)
        req = urllib.request.Request(BASE + self.path, data=body, method=method)
        for k, v in self.headers.items():
            if k.lower() in ("host", "authorization", "x-api-key", "content-length", "connection", "accept-encoding", "cookie"): continue
            req.add_header(k, v)
        req.add_header("Authorization", "Bearer " + _KEY)
        try:
            r = urllib.request.urlopen(req, timeout=300); status = r.status
        except urllib.error.HTTPError as e:
            r = e; status = e.code
        except Exception as e:
            self.send_response(502); self.end_headers(); self.wfile.write(("gateway upstream error: " + type(e).__name__).encode()); return
        self.send_response(status)
        for k, v in r.headers.items():
            if k.lower() in ("transfer-encoding", "content-length", "connection", "content-encoding"): continue
            self.send_header(k, v)
        self.end_headers()
        sse = "text/event-stream" in (r.headers.get("Content-Type") or "")
        pending = b""
        try:
            while True:
                ch = r.read(1024)
                if not ch: break
                if not sse:
                    self.wfile.write(ch); continue
                pending += ch
                while b"\n\n" in pending:
                    ev, pending = pending.split(b"\n\n", 1)
                    ev = _process_event(ev)
                    if ev is not None: self.wfile.write(ev + b"\n\n"); self.wfile.flush()
            if pending: self.wfile.write(pending)
        except Exception:
            pass
    def do_POST(self): self._fwd("POST")
    def do_GET(self): self._fwd("GET")

if __name__ == "__main__":
    if not _KEY:
        print("KIE key not found in .env (value not shown). Gateway not started."); sys.exit(2)
    try:
        srv = ThreadingHTTPServer(("127.0.0.1", PORT), H)
    except OSError:
        print(f"port {PORT} already in use - gateway already running?"); sys.exit(1)
    print(f"KIE gateway on http://127.0.0.1:{PORT}  (close this window or run stop-kie.cmd to stop)", flush=True)
    try: srv.serve_forever()
except KeyboardInterrupt: pass- 스트림(SSE)은 빈 줄 두 개로 끝나는 이벤트 단위로 잘라 하나씩 고친 뒤 바로 내보낸다. 응답을 모아 두지 않으므로 글자가 나오는 속도는 그대로다.
- 127.0.0.1에만 열리므로 같은 PC 밖에서는 접속할 수 없다.
- 포트는 환경변수
KIEGWPORT로 바꿀 수 있다. 바꾸면 litellm-kie.config.yaml의 api_base 포트도 같이 바꾼다. - Cline hub 대시보드의 기본 포트가 8787이라 게이트웨이는 8788을 쓴다.
11. 설치 4: 시작·종료 스크립트
게이트웨이와 LiteLLM을 매번 따로 켜지 않도록 PowerShell 제어 스크립트 하나와 더블클릭용 cmd 두 개를 둔다. kie-ctl.ps1은 start, stop, status 세 가지 동작을 한다.
| 파일 | 동작 | 비고 |
|---|---|---|
| kie-ctl.ps1 start | 게이트웨이(:8788)와 LiteLLM(:4000)을 최소화 창으로 실행 | 이미 실행 중이면 다시 띄우지 않음, 최대 90초 대기 |
| kie-ctl.ps1 stop | 저장된 pid로 종료, 이 폴더에서 띄운 잔여 프로세스 정리 | 다른 프로그램이 쓰는 포트는 건드리지 않음 |
| kie-ctl.ps1 status | 두 서버의 running / ready / stopped 표시 | |
| start-kie.cmd / stop-kie.cmd | 더블클릭으로 start / stop 실행 |
C:\kie-cline\kie-ctl.ps1 전체 코드다. 잔여 프로세스를 고르는 조건은 폴더 이름 kie-cline이 들어간 명령줄이므로, 다른 폴더 이름을 쓰면 이 부분도 바꾼다.
# KIE gateway (:8788) + LiteLLM (:4000) control. Usage: kie-ctl.ps1 start|stop|status [-Quiet]
param([Parameter(Position=0)][string]$Action = "status", [switch]$Quiet)
$ErrorActionPreference = "SilentlyContinue"
$R = $PSScriptRoot
$Run = Join-Path $R "run"; New-Item -ItemType Directory -Force $Run | Out-Null
$Py = Join-Path $R "venv\Scripts\python.exe"
$Lite = Join-Path $R "venv\Scripts\litellm.exe"
function Say($m) { if (-not $Quiet) { Write-Host $m } }
function Listening($port) { [bool](Get-NetTCPConnection -LocalAddress 127.0.0.1 -LocalPort $port -State Listen -ErrorAction SilentlyContinue) }
function LiteReady { try { (Invoke-WebRequest -UseBasicParsing -TimeoutSec 3 "http://127.0.0.1:4000/health/liveliness").StatusCode -eq 200 } catch { $false } }

switch ($Action) {
  "start" {
    if (Listening 8788) { Say "gateway :8788 already running" }
    else {
      $p = Start-Process -FilePath $Py -ArgumentList "`"$R\gateway\kie_gateway.py`"" -WorkingDirectory $R -WindowStyle Minimized -PassThru
      $p.Id | Set-Content (Join-Path $Run "gateway.pid"); Say "gateway started (pid $($p.Id))"
    }
    if (Listening 4000) { Say "litellm :4000 already running" }
    else {
      $env:LITELLM_LOCAL_MODEL_COST_MAP = "True"; $env:LITELLM_TELEMETRY = "False"; $env:PYTHONIOENCODING = "utf-8"
      $p = Start-Process -FilePath $Lite -ArgumentList "--config `"$R\litellm-kie.config.yaml`" --host 127.0.0.1 --port 4000" -WorkingDirectory $R -WindowStyle Minimized -PassThru
      $p.Id | Set-Content (Join-Path $Run "litellm.pid"); Say "litellm starting (pid $($p.Id))"
    }
    for ($i = 0; $i -lt 90; $i++) { if ((Listening 8788) -and (LiteReady)) { Say "ready: http://127.0.0.1:4000/v1"; exit 0 }; Start-Sleep 1 }
    Write-Host "KIE servers did not become ready in 90s (check the minimized windows)"; exit 1
  }
  "stop" {
    foreach ($n in "litellm", "gateway") {
      $f = Join-Path $Run "$n.pid"
      if (Test-Path $f) { $id = Get-Content $f; & taskkill.exe /PID $id /T /F *> $null; Remove-Item $f; Say "$n stopped (pid $id)" }
    }
    # leftovers started by this folder only (checked by command line)
    foreach ($port in 4000, 8788) {
      Get-NetTCPConnection -LocalAddress 127.0.0.1 -LocalPort $port -State Listen | ForEach-Object {
        $proc = Get-CimInstance Win32_Process -Filter "ProcessId=$($_.OwningProcess)"
        $par = Get-CimInstance Win32_Process -Filter "ProcessId=$($proc.ParentProcessId)"
        if ("$($proc.CommandLine) $($par.CommandLine) $($proc.ExecutablePath)" -like "*kie-cline*") { & taskkill.exe /PID $proc.ProcessId /T /F *> $null; Say "stopped leftover on :$port" }
        else { Say ":$port is used by another program (not stopped): $($proc.Name)" }
      }
    }
  }
  default {
    Say ("gateway :8788 " + $(if (Listening 8788) { "running" } else { "stopped" }))
    Say ("litellm :4000 " + $(if (LiteReady) { "ready" } elseif (Listening 4000) { "starting" } else { "stopped" }))
  }
}
start-kie.cmd와 stop-kie.cmd는 각각 두 줄이다.
@echo off
powershell.exe -NoProfile -ExecutionPolicy Bypass -File "%~dp0kie-ctl.ps1" start
@echo off
powershell.exe -NoProfile -ExecutionPolicy Bypass -File "%~dp0kie-ctl.ps1" stop- start를 실행하면 최소화된 창 두 개(gateway, litellm)가 뜨고, 준비가 끝나면 `ready: http://127.0.0.1:4000/v1`이 나온다.
- 90초 안에 준비되지 않으면 최소화된 창을 열어 오류 문구를 본다. 키 파일을 못 찾으면 게이트웨이 창에 안내 문구가 남는다.
- LiteLLM은 비용표 원격 조회와 원격 측정을 끄고(
LITELLMLOCALMODELCOSTMAP=True,LITELLM_TELEMETRY=False) 실행한다. - 자동 시작 등록은 하지 않는다. 다음 절의 kc 런처가 서버가 꺼져 있으면 알아서 켠다.
12. 설치 5: Cline CLI 설치와 연결
Cline은 VS Code 확장으로 출발해 터미널용 CLI까지 갖춘 오픈소스 코딩 도구다. CLI에서 정한 공급자 설정은 VS Code 확장과 공유된다(README 기준).
아래 영상은 Cline CLI 2.0을 소개하며 터미널 중심으로 코딩 도구를 쓰는 흐름을 9분가량 보여 주는 영어 영상이다. 버전은 이 글의 3.0.73보다 앞서지만 CLI의 기본 사용 감각을 익히는 데 참고가 된다.
먼저 start-kie.cmd로 서버를 켠 뒤 Cline을 설치하고 기본 공급자를 로컬 LiteLLM 주소로 연결한다.
npm i -g cline
cline auth -p openai -k sk-local-kie -m kie-deepseek -b http://127.0.0.1:4000/v1
연결이 되었는지는 짧은 요청 하나로 본다.
cline -P openai-compatible -m kie-haiku "say hi"| 항목 | 값 | 설명 |
|---|---|---|
| 설치 | npm i -g cline | 10월 17일 npm 최신 3.0.73 |
| 공급자 | -p openai (auth), -P openai-compatible (실행) | OpenAI 호환 공급자 |
| 키 | sk-local-kie | LiteLLM master_key, 로컬 더미 |
| 기본 모델 | -m kie-deepseek | 기본값을 Haiku로 하려면 -m kie-haiku |
| Base URL | `-b http://127.0.0.1:4000/v1` | LiteLLM 주소 |
- VS Code 확장(Cline)에서는 API Provider를 OpenAI Compatible로 고르고 Base URL에 127.0.0.1:4000/v1(앞에 http:// 포함), API Key에 sk-local-kie를 넣은 뒤 Model ID 칸만 kie-luna 같은 값으로 바꾸면 된다. 확장 화면에서의 동작은 미실측이다.
- 2026년 2월 Cline CLI 2.3.0 공급망 공격으로 OpenClaw가 설치된 사례가 보도됐다. 설치 후
cline --version으로 버전을 보고, 출처가 분명한 최신 버전을 쓴다. - Cline은 작업 하나에 시스템 프롬프트를 약 7.4k 토큰 쓰고, 파일 작업이면 2~4회 요청한다.
- 서버를 켜지 않고 실행하면 연결 오류가 난다. 다음 절의 kc 런처는 이 단계를 자동으로 처리한다.
13. kc 런처로 날마다 쓰기
kc는 서버 시작, 모델 고르기, 승인 모드, 작업 폴더 지정을 한 번에 처리하는 짧은 런처다. C:\kie-cline을 PATH에 넣으면 어느 폴더에서나 kc만 입력하면 된다.
kc.cmd는 kc.ps1을 부르는 한 줄짜리 파일이다.
@echo off
powershell.exe -NoProfile -ExecutionPolicy Bypass -File "%~dp0kc.ps1" %*
kc.ps1 원문이다.
# kc: start KIE servers if needed, then run Cline CLI with a KIE model.
# kc [luna|deepseek|haiku|gemini] [cline options] ["prompt"]
$R = $PSScriptRoot
$map = @{ "luna"="kie-luna"; "gpt"="kie-luna"; "deepseek"="kie-deepseek"; "ds"="kie-deepseek"; "haiku"="kie-haiku"; "claude"="kie-haiku"; "gemini"="kie-gemini" }
$model = "kie-deepseek"; $rest = @($args)
if ($rest.Count -gt 0 -and $map.ContainsKey("$($rest[0])".ToLower())) { $model = $map["$($rest[0])".ToLower()]; $rest = @($rest | Select-Object -Skip 1) }
& powershell.exe -NoProfile -ExecutionPolicy Bypass -File (Join-Path $R "kie-ctl.ps1") start -Quiet
if ($LASTEXITCODE -ne 0) { exit 1 }
$extra = @()
if (-not ($rest -contains "--auto-approve") -and -not ($rest -contains "-y") -and -not ($rest -contains "--yolo")) { $extra += @("--auto-approve", "false") }
if (-not ($rest -contains "-c") -and -not ($rest -contains "--cwd")) {
  $cwd = (Get-Location).Path
  if ($cwd.TrimEnd('\') -ieq $R.TrimEnd('\')) { $cwd = Join-Path $R "workspace" }
  $extra += @("-c", $cwd)
}
$cl = Join-Path $env:APPDATA "npm\cline.cmd"; if (-not (Test-Path $cl)) { $cl = "cline" }
& $cl -P openai-compatible -m $model @extra @rest
exit $LASTEXITCODE
사용 예는 아래와 같다.
C:\kie-cline\kc.cmd                 기본 모델(DeepSeek)로 대화형 실행
C:\kie-cline\kc.cmd haiku           Haiku로 대화형 실행
C:\kie-cline\kc.cmd luna "질문"     한 번만 실행하고 종료
kc haiku -c D:\projects\my-app 작업 폴더 직접 지정| 모델 인자 | 모델 ID | 모델 |
|---|---|---|
| luna, gpt | kie-luna | GPT-6 Luna |
| deepseek, ds (기본값) | kie-deepseek | DeepSeek V4.1 Flash |
| haiku, claude | kie-haiku | Claude Haiku 5.5 |
| gemini | kie-gemini | Gemini 3.8 Flash |
- kc는 현재 폴더에서 작업한다. 프로젝트 폴더로 cd 한 뒤 실행하면 되고, C:\kie-cline 자체에서 실행하면 workspace\에서 작업한다.
- 따로 지정하지 않으면
--auto-approve false를 붙인다. 파일 수정과 명령 실행은 매번 승인해야 진행된다. - 대화 중에는
/model을 입력하고 kie-luna, kie-deepseek, kie-haiku, kie-gemini 중 하나를 고른다. - 서버가 꺼져 있으면 kc가 kie-ctl.ps1 start를 먼저 실행하고, 준비에 실패하면 Cline을 띄우지 않고 끝난다.
14. 명령 요약
자주 쓰는 명령을 한곳에 모았다. 경로는 예시 폴더 기준이다.
| 하고 싶은 일 | 명령 |
|---|---|
| 서버 시작 | C:\kie-cline\start-kie.cmd |
| 서버 종료 | C:\kie-cline\stop-kie.cmd |
| 서버 상태 | powershell -File C:\kie-cline\kie-ctl.ps1 status |
| Cline 설치 | npm i -g cline |
| 기본 공급자·모델 설정 | `cline auth -p openai -k sk-local-kie -m kie-deepseek -b http://127.0.0.1:4000/v1` |
| 연결 확인 | cline -P openai-compatible -m kie-haiku "say hi" |
| 모델 지정 한 번 실행 | cline -P openai-compatible -m kie-luna "작업" |
| 대화형(TUI) | cline -i, 안에서 /model |
| 런처 기본 실행 | kc (DeepSeek) |
| 런처 모델 지정 | kc haiku, kc luna "질문" |
| 작업 폴더 지정 | kc haiku -c <폴더> |
| 모델 추가·변경 | litellm-kie.config.yaml의 model_list 수정 → stop → start |
--yolo는 모든 도구를 자동 승인하므로 쓰지 않는 편이 안전하다. 꼭 써야 한다면 격리된 폴더에서만 쓴다.- 기본 모델을 바꾸려면 cline auth를
-m kie-haiku처럼 다시 실행한다. - 서버 창을 직접 닫아도 되지만 stop-kie.cmd가 pid 파일까지 정리한다.
- Cline VS Code 확장에서도 같은 LiteLLM 주소와 더미 키를 쓴다.
15. 증상별 해결
이 구성을 쓰면서 마주칠 수 있는 증상과 원인, 해결을 한 표로 묶었다. 오류 문구는 실측 원문이다.
| 증상 | 원인 | 해결 |
|---|---|---|
KIE key not found in .env (value not shown) | .env가 없거나 변수 이름이 다름 | KIEAPIKEY= 줄 확인, 다른 경로면 KIEENVFILE 지정 |
port 8788 already in use | 게이트웨이가 이미 실행 중 | 그대로 쓰거나 stop-kie.cmd 후 다시 start |
KIE servers did not become ready in 90s | 키 누락, venv 미설치, 설정 오류 | 최소화된 창의 오류 문구 확인 |
Invalid function argument delta | KIE DeepSeek의 빈 delta 이벤트 | 게이트웨이를 거치는지(api_base가 :8788인지) 확인 |
Missing required parameter: input.type | 이전 답변 항목에 type 없음 | 게이트웨이 경유 시 자동 보정 |
429 Too many pending requests, 502 | KIE 서버 일시 오류 | 잠시 뒤 재시도하거나 다른 모델로 전환 |
503 Resources are tight | KIE Claude 경로 혼잡 | Luna나 DeepSeek로 전환 |
Gemini {"code":500,"msg":"Internal Error"} | KIE Gemini 측 오류, 도구 지원 미판정 | 코딩 작업에는 다른 모델 사용 |
| 404 (gpt-5.5) | 2026-10-14 퇴역 | gpt-6-luna로 교체 |
| Cline Hub와 포트 충돌 | Cline hub 대시보드가 8787 사용 | 게이트웨이는 8788 유지 |
- 모델 하나가 막히면
/model로 다른 회사 모델로 바로 바꾸는 것이 가장 빠르다. 예를 들어 Claude가 429면 DeepSeek나 Luna로 간다. - LiteLLM은 재시도를 0으로 두었으므로 오류가 Cline 화면에 바로 보인다. 같은 요청이 LiteLLM과 Cline에서 이중으로 재시도되며 크레딧이 새는 일을 막는다.
- 오류 본문이 HTTP 200 안에 담겨 오는 경우가 있어 상태 코드만으로는 성공 여부를 판단할 수 없다.
- 서버 쪽 오류인지 볼 때는 같은 요청을 다른 모델로 보내 보는 것이 가장 간단하다.
16. 승인 모드를 유지해야 하는 이유
KIE의 Claude 경로에서는 설명되지 않는 동작이 한 번 관찰됐다. Grok Build에서 Claude Haiku 5.5에 짧은 인사말만 보냈는데, 모델이 두 번 모두 PC에 없는 리눅스 경로의 메모 파일에 쓰기를 시도했다.
| 항목 | 관찰 내용 |
|---|---|
| 도구 | Grok Build 1.0.62 (headless) |
| 모델 | Claude Haiku 5.5 (KIE /anthropic/v1) |
| 시도한 경로 | /root/kie-worker/…/.claude/projects/…/memory/user_name.md 형태 |
| 결과 | 승인 없이 실행하지 않는 모드라 실제로 써지지 않음 |
| 원인 | 미확인 |
| 권장 | 승인 모드 유지, 낯선 경로 쓰기·읽기 요청은 거절 |
- 관찰된 현상이고 원인은 확인되지 않았다. 도구나 PC 쪽에서 만든 경로가 아니라는 점만 분명하다.
- 이런 요청이 자동 승인 모드에서 들어오면 의도하지 않은 파일 작업이 일어날 수 있다. Grok Build의
--always-approve, Cline의--yolo는 권하지 않는다. - kc 런처가 기본으로
--auto-approve false를 붙이는 이유도 여기에 있다. /root/kie-worker/...나~/.claude/...같은 메모 경로가 보이면 작업과 무관한 요청으로 보고 거절한다.
17. 호출 수와 크레딧
실측 단계별 호출 수와 소모 크레딧이다. 표준 단가는 1크레딧 $0.005다.
| 단계 | 모델 호출(POST) | 소모 크레딧 | 달러 환산 | 메모 |
|---|---|---|---|---|
| API·OpenCode 호환성 실측 | 74회 | 8.63 | 약 $0.04 | 크레딧이 기록된 호출의 합 |
| Grok Build 전체 모델 | 83회 (실제 모델 호출 50회) | 34.2 | 약 $0.17 | 대부분 Kimi K3(27.7) |
| Cline·LiteLLM 구성 | 약 40~41회 | 2.23 | 약 $0.011 | 대상 4모델 |
| 모델·조합 | 호출 | 크레딧 |
|---|---|---|
| OpenCode + Grok 4.7 | 2회 | 2.71 |
| Kimi K3 (API 직접) | 5회 | 2.03 |
| Grok 4.7 | 6회 | 1.65 |
| Sonnet 5.5 | 5회 | 0.87 |
| Haiku 5.5 | 9회 | 0.48 |
| OpenCode + DeepSeek | 11회 | 0.47 |
| GPT 5.2 | 3회 | 0.28 |
| DeepSeek | 10회 | 0.07 |
- OpenCode + Grok 4.7은 시스템 프롬프트가 2만 자가 넘어 같은 모델을 직접 호출할 때보다 비쌌다.
- GPT-6 Luna 직접 호출은 응답에 크레딧이 찍히지 않았고, 실제 과금은 미확인이다.
- Grok Build의 제목·요약 헛호출 33회는 404/500으로 거절돼 과금되지 않았다.
- Cline도 작업마다 긴 시스템 프롬프트와 여러 번의 요청을 쓰므로 실제 사용 시 호출 수는 OpenCode와 비슷한 수준으로 보면 된다.
18. 아직 판정되지 않은 것
이 구성은 바로 쓸 수 있지만 몇 가지는 판정이 남아 있다. 쓰기 전에 아래 항목을 알고 있으면 엉뚱한 곳에서 시간을 쓰지 않는다.
| 항목 | 상태 | 이유 |
|---|---|---|
| Gemini 3.8 Flash 도구 호출 | 미판정 | 당일 KIE 서버가 Gemini 요청에 code 500 |
| Cline openai-native·anthropic 공급자로 KIE 직결 | 미실측 | LiteLLM 없이 되는지 미시험 |
| Cline VS Code 확장 화면 | 미실측 | CLI와 같은 엔진·설정이라는 README 내용만 근거 |
| Continue, Kilo Code, Cherry Studio, Chatbox | 문서 기준 | 실행하지 않음 |
| KIE 정상 시 Claude Code 2턴 | 미확인 | 테스트 시간 내내 503/429 |
Grok Build session_summary 효과 | 미실측 | 문서 기준 설정 |
| GPT-6 Luna 일부 응답의 실제 과금 | 미확인 | 크레딧 표기 없음 |
- Gemini는 KIE 서버가 정상일 때 도구 호출을 다시 보면 판정할 수 있다. 그전까지는 코딩 작업 목록에서 빼 두는 편이 안전하다.
- Continue는 LiteLLM 주소에 4모델을 등록해 채팅창 드롭다운으로 고르는 방식이다. Cline과 같은 주소·더미 키를 그대로 쓸 수 있다.
- 새 모델을 추가할 때는 API 직접 호출로 1턴·2턴·도구를 먼저 보고 model_list에 넣는다.
- KIE 문서와 실제 동작이 다른 사례(DeepSeek input.type)는 KIE 지원팀([email protected])에 보고할 수 있다.
19. 출처
수치와 설정의 바탕이 되는 공식 문서와 저장소, 관련 보도다.
| 자료 | 내용 | 링크 |
|---|---|---|
| KIE 문서 | 엔드포인트, Chat only 표기, Grok Build·Codex 연결 | docs.kie.ai |
| Cline 저장소 | CLI·VS Code 확장, 공급자 설정 | github.com/cline/cline |
| Cline CLI 소개 | 터미널용 Cline | cline.bot 블로그 |
| LiteLLM 저장소 | 프록시 설정, model_list | github.com/BerriAI/litellm |
| LiteLLM 문서 | Proxy 설정 파일 | docs.litellm.ai |
| Cline CLI 2.3.0 공급망 공격 보도 | 2026년 2월 사건 | The Hacker News |
| 이전 글 | OpenCode 설치와 KIE 연결 | KIE + OpenCode 연결 |
- 인기 수치(별 수, 설치 수)는 10월 17일 16시대 값이며 시간이 지나면 바뀐다.
- 오류 문구와 PASS·FAIL은 같은 날 실측 원문이다. KIE 서버 상태에 따라 결과가 달라질 수 있다.
- 버전은 Cline CLI 3.0.73, LiteLLM 1.105.1, OpenCode 1.19.3, Grok Build 1.0.62, Claude Code 2.1.302다.
- 키 관리와 OpenCode 설정의 기본은 이전 글을 함께 보면 된다.
20. 마무리
KIE의 여러 모델을 코딩 작업에 쓰려면 모델을 고르기 전에 경로와 형식부터 맞춰야 한다. 핵심만 다시 짚는다.
- KIE에는 통합 chat/completions 주소가 없고, 모델 계열마다 Messages·Responses·모델별 chat 경로가 따로 있다.
- OpenCode의 멈춤은 DeepSeek 2턴
input.type오류와 조용한 재시도, KIE 서버의 429·502·503이 겹친 결과였다. - DeepSeek는 도구마다 다른 결함 네 가지가 드러났고, 작은 로컬 게이트웨이로 모두 메울 수 있었다.
- Grok Build는 Grok 4.7에는 가장 깔끔했지만 다른 회사 모델은 모델마다 연결 방식이 달라졌다.
- Cline CLI + LiteLLM + 게이트웨이 구성에서 Luna·DeepSeek·Haiku가 1턴·2턴·파일 생성을 모두 통과했다.
- 실제 키는 .env 한 곳에만 두고, 도구에는 로컬 더미 키만 준다.
- 승인 모드를 유지하고 낯선 경로 쓰기 요청은 거절한다.
「주소는 하나로, 키는 한 곳에, 승인은 매번 직접」
자주 묻는 질문
- KIE에서 여러 모델을 코딩 도구 하나로 쓰기 어려운 이유는 무엇인가요?
KIE는 모델 회사마다 원래 API 형식을 그대로 열어 둡니다. Claude는 /anthropic/v1/messages, GPT·DeepSeek·Kimi는 /openai/v1/responses, Gemini와 GPT 5.2는 모델별 chat/completions 주소를 씁니다. 공통 /openai/v1/chat/completions는 HTTP 200 안에 code 422를 돌려주므로 주소 하나만 아는 도구는 일부 모델과만 맞습니다.
- OpenCode에서 DeepSeek가 두 번째 질문부터 실패하는 원인은 무엇인가요?
OpenCode는 이전 답변을 role과 content만 담은 항목으로 다시 보내는데 KIE DeepSeek는 type:"message"가 없으면 Missing required parameter: input.type으로 거절합니다. KIE 문서상으로는 생략 가능하지만 실제로는 이 한 필드를 붙여야 통과하며, 로컬 게이트웨이가 자동으로 붙여 줍니다.
- OpenCode나 Claude Code 화면이 1~3분씩 멈추는 건 왜 그런가요?
KIE가 429 Too many pending requests, 502, 503 Resources are tight, HTTP 200 안의 response.failed 같은 일시 오류를 낼 때 도구가 오류를 띄우지 않고 조용히 재시도하기 때문입니다. OpenCode는 5→8→12→19→40초 간격으로 다시 보내 DeepSeek 2턴 오류에서 약 89초 멈췄습니다.
- Gemini 3.8 Flash를 코딩 작업에 쓸 수 있나요?
API 직접 호출에서 1턴과 2턴은 통과했지만 도구 요청에는 HTTP 200 안에 code 500이 돌아왔습니다. Cline 구성 실측 당일에는 KIE가 Gemini 요청 전부에 code 500을 반환해 도구 지원 여부를 판정하지 못했습니다. KIE 문서도 Chat only로 표기하므로 지금은 코딩 작업 목록에서 빼 두는 편이 안전합니다.
- gpt-5.5를 골랐더니 404가 납니다.
gpt-5.5는 2026년 10월 14일 퇴역해 호출하면 404가 나고, 오류 문구는 GPT-6.1 Sol 또는 GPT-6 Luna를 쓰라고 안내합니다. /openai/v1/models 목록과 KIE의 Codex 설정 예시에는 아직 남아 있으니 모델 ID를 gpt-6-luna로 바꾸면 됩니다.
- Grok Build 대신 Cline을 고른 이유는 무엇인가요?
Grok Build는 Grok 4.7에서 1턴·2턴·파일 생성이 모두 통과했지만 Luna와 DeepSeek는 게이트웨이, Claude는 다른 백엔드가 필요해 모델마다 설정이 달라졌습니다. 제목 생성 헛호출 33회도 생겼습니다. Cline은 GitHub 별 70,440, VS Code 설치 5,643,088로 가장 널리 쓰이고 LiteLLM 주소 하나로 모델 ID만 바꿔 쓸 수 있습니다.
- LiteLLM만 쓰면 되지 왜 보정 게이트웨이가 또 필요한가요?
LiteLLM은 형식 변환과 주소 통합을 맡지만 KIE 응답의 빈틈까지 메우지는 않습니다. DeepSeek는 빈 functioncallarguments.delta 이벤트 때문에 LiteLLM에서 Invalid function argument delta로 실패했고, Luna는 response.metadata 이벤트를 보냅니다. 게이트웨이가 이 이벤트를 버리고 빠진 필드를 채우며 실제 키를 넣습니다.
- sk-local-kie는 KIE API 키인가요?
아닙니다. sk-local-kie는 LiteLLM 설정의 master_key로 쓰는 로컬 전용 더미 키입니다. Cline은 이 값만 받고, 실제 KIE 키는 게이트웨이가 C:\kie-cline\.env에서 메모리로만 읽어 Authorization 헤더에 넣습니다. 그래서 설정 파일이나 Cline 설정이 노출되어도 KIE 키는 드러나지 않습니다.
- 게이트웨이 포트를 8787이 아니라 8788로 쓰는 이유는 무엇인가요?
Cline hub 대시보드의 기본 포트가 8787이라 같은 포트를 쓰면 충돌합니다. 그래서 게이트웨이는 8788에서 대기합니다. 다른 포트를 쓰려면 환경변수 KIEGWPORT를 바꾸고 litellm-kie.config.yaml의 api_base 포트도 같은 값으로 맞춘 뒤 stop과 start로 다시 켭니다.
- Cline CLI에서 모델을 바꾸려면 어떻게 하나요?
한 번만 바꿀 때는 cline -P openai-compatible -m kie-luna "작업"처럼 -m 값만 바꾸고, kc 런처에서는 kc luna나 kc haiku처럼 첫 인자로 고릅니다. 대화형 화면에서는 /model을 입력해 kie-luna, kie-deepseek, kie-haiku, kie-gemini 중 하나를 고르고, 기본값은 cline auth를 다시 실행해 바꿉니다.
- --yolo나 자동 승인 모드를 쓰면 안 되나요?
권하지 않습니다. KIE Claude 경로에서 모델이 PC에 없는 /root/kie-worker/… 아래 메모 파일에 쓰기를 시도하는 현상이 관찰됐고 원인은 미확인입니다. 승인 모드였기 때문에 실제로 써지지 않았습니다. kc 런처는 기본으로 --auto-approve false를 붙여 파일 수정과 명령 실행을 매번 승인하게 합니다.
- 새 KIE 모델을 이 구성에 추가하려면 어떻게 하나요?
litellm-kie.config.yaml의 modellist에 modelname과 litellm_params를 추가합니다. Responses 모델은 openai/responses/ 접두사와 :8788/openai/v1, Claude는 anthropic/ 접두사와 :8788/anthropic을 씁니다. 저장 후 stop-kie.cmd와 start-kie.cmd로 다시 켜고, 먼저 1턴·2턴·도구 호출이 되는지 짧게 시험한 뒤 작업에 씁니다.