 테크·IT
젠스파크(Genspark)는 크레딧제로 굴러가는 통합 AI 플랫폼이다. 한 달에 일정 크레딧을 받고, 글·이미지·영상·전화·에이전트 작업에 맞춰 크레딧이 깎인다. 여기서 사용자가 가장 먼저 부딪히는 게 모델 선택창에 찍힌 배수(1x, 2x, 5x, 30x…)다. 같은 질문을 던져도 모델에 따라 크레딧 소모가 수십 배 갈린다. 그 배수가 어디서 나온 값인지, 왜 지피티와 클로드가 가장 비싼지, 그리고 왜 요즘 김이 2.6·GLM-5.2·딥시크 V4 플래시 같은 중국 모델로 갈아타는 사람이 늘었는지를 공식 API 단가와 벤치마크 수치로 풀어본다.
핵심 포인트: 젠스파크의 배수는 자의적 기준이 아니라 각 모델사의 출력 토큰 단가를 거의 선형으로 옮긴 원가 기반 지표다. 비싼 모델은 실제로 비싸게 만들어졌고, 싼 모델은 실제로 싸게 만들어졌다. 따라서 배수를 보면 그 모델의 진짜 API 원가 구조를 읽을 수 있다.
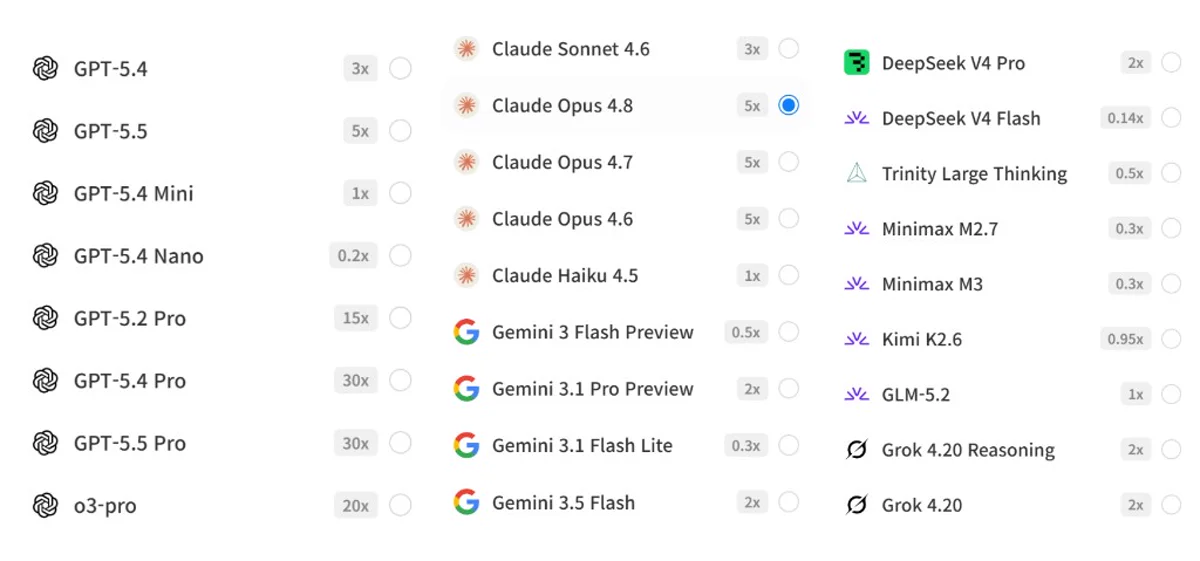
그림 1. 젠스파크 모델 선택창에 찍힌 모델별 크레딧 배수. 같은 질문도 모델에 따라 크레딧 소모가 수십 배 갈린다.
한 가지 먼저 짚고 가면, 젠스파크 공식 도움말은 "모델 선택 — 고급 모델일수록 사용 1회당 크레딧을 더 소모한다"고만 밝히고 있고 모델별 정식 단가표는 공개하지 않는다. 아래 배수는 젠스파크 화면에 표시된 값을 사용자가 정리한 것이고, 본문은 그 값을 공식 API·OpenRouter 단가와 대조해 검증한 결과다. 단가는 2026년 6월 기준 공식 문서 확인값이다.
1. 젠스파크 가격 가중치가 의미하는 것
젠스파크에서 1x는 기준 단위 크레딧 1회 소모를 뜻한다. 5x면 그 5배, 0.14x면 7분의 1 수준이다. 이 배수는 모델의 실제 API 원가, 특히 출력 토큰 가격과 강한 상관을 보인다. 크레딧은 입력 길이·대화 깊이·생성 미디어 해상도·영상 길이·모델 선택 등 여러 변수로 계산되지만, 모델 선택이 가장 큰 폭으로 소모를 좌우한다.
공식 도움말의 설명도 같은 방향이다. 더 복잡한 작업일수록 크레딧이 더 들고, 고급 모델은 1회 사용당 크레딧을 더 잡아먹는다. 즉 배수는 젠스파크가 임의로 매긴 프리미엄이 아니라 자기네가 모델사에 내는 토큰 원가를 사용자 크레딧으로 환산한 값에 가깝다. 그래서 배수를 역으로 읽으면 각 모델의 시장 단가 위상이 보인다.
2. 모델별 공식 API 가격 대조표
아래 표는 화면의 배수와 공식 API 단가(입력 / 출력, 1M 토큰당 USD)를 나란히 놓은 것이다. 단가 출처는 각 모델사 공식 문서이고, 일부는 OpenRouter로 보완했다.
| 모델 | 젠스파크 배수 | 입력 $/1M | 출력 $/1M | 개발사 |
|---|---|---|---|---|
| GPT-5.5 Pro / 5.4 Pro | 30x | 고가 reasoning | 매우 높음 | OpenAI |
| GPT-5.2 Pro | 15x | 고가 | 고가 | OpenAI |
| o3-pro | 20x | 고가 | 고가 | OpenAI |
| GPT-5.5 | 5x | 5.00 | 30.00 | OpenAI |
| GPT-5.4 | 3x | 2.50 | 15.00 | OpenAI |
| GPT-5.4 Mini | 1x | 저가 | 저가 | OpenAI |
| GPT-5.4 Nano | 0.2x | 매우 저가 | 매우 저가 | OpenAI |
| Claude Opus 4.8 | 5x | 5.00 | 25.00 | Anthropic |
| Claude Opus 4.7 | 5x | 5.00 | 25.00 | Anthropic |
| Claude Sonnet 4.6 | 3x | 3.00 | 15.00 | Anthropic |
| Claude Haiku 4.5 | 1x | 1.00 | 5.00 | Anthropic |
| Gemini 3.1 Pro Preview | 2x | 2.00 | 12.00 | |
| Gemini 3.5 Flash | 2x | 1.50 | 9.00 | |
| Gemini 3 Flash | 0.5x | 0.50 | 3.00 | |
| Gemini 3.1 Flash Lite | 0.3x | 0.30 | 2.50 | |
| DeepSeek V4 Pro | 2x | 1.74 (프로모 0.435) | 3.48 (프로모 0.87) | DeepSeek |
| DeepSeek V4 Flash | 0.14x | 0.14 | 0.28 | DeepSeek |
| Kimi K2.6 | 0.95x | 0.95 | 4.00 | Moonshot AI |
| GLM-5.2 | 1x | 1.40 | 4.40 | Z.ai |
| Grok 4.20 | 2x | 1.25 | 2.50 | xAI |
| Minimax M3 | 0.3x | 0.30 | 1.20 | MiniMax |
배수와 출력 단가를 겹쳐 보면 패턴이 선명하다. GPT-5.5와 Claude Opus가 출력 $25~30 부근에서 5x를 받고, DeepSeek V4 Flash가 출력 $0.28에서 0.14x를 받는 식이다. 출력 단가가 크레딧 소모의 가장 큰 변수라는 뜻이다. 입력 단가도 반영되지만 출력만큼은 아니다.
3. GPT와 Claude가 가장 비싼 이유
지피티와 클로드가 비싼 건 단순하다. 출력 토큰 단가가 시장에서 가장 높기 때문이다. GPT-5.5는 출력 1M 토큰에 30달러, Claude Opus 4.8은 25달러다. 이 두 값은 2026년 6월 현재 프런티어급 모델 중 최고가 축에 속한다. 사용자가 "지피티·클로드가 가장 비싸다"고 느낀 체감은 단가표 그대로다.
다만 진짜 끝판왕은 Pro와 o3-pro 계열이다. GPT-5.5 Pro·5.4 Pro가 30x, GPT-5.2 Pro가 15x, o3-pro가 20x다. 이들은 추론할 때 내부적으로 토큰을 폭발적으로 소모하는 reasoning 모델이라 1회 호출당 원가가 일반 모델의 여러 배로 잡힌다. 어려운 문제 한두 개에만 쓰도록 가격으로 제어하는 셈이다.
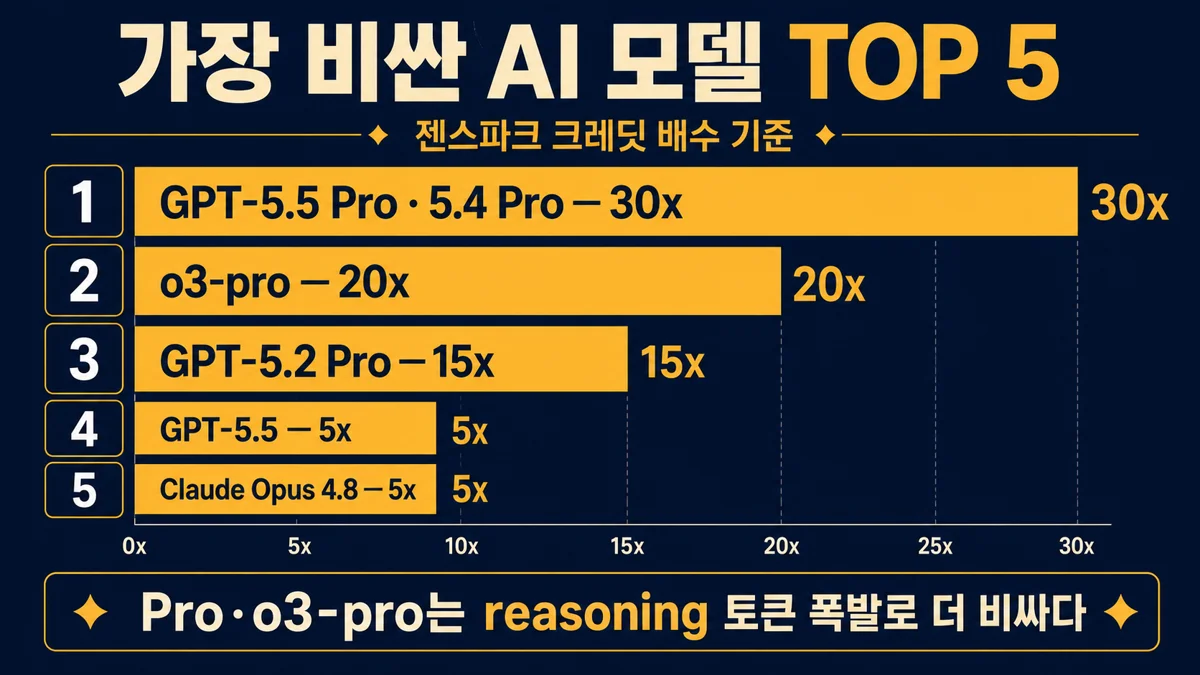
그림 2. 배수가 높은 모델 TOP 5 — GPT-5.5 Pro·5.4 Pro가 30x, o3-pro 20x, GPT-5.2 Pro 15x. Pro·o3-pro 계열은 reasoning 토큰 폭발로 일반 모델의 여러 배 원가가 잡힌다.
Claude 쪽에서 주목할 건 Opus 4.8이 4.7·4.6과 똑같이 5x라는 점이다. Anthropic 공식 문서에 따르면 Opus 4.8은 2026년 5월 28일에 출시됐고 단가는 입력 5달러 / 출력 25달러로 4.7과 동일하다. 신모델이라고 더 비싸게 매긴 게 아니라 원가를 그대로 반영한 합리적 책정이다. 다만 4.8에는 2.5배 빠른 Fast Mode가 있어 입력 10달러 / 출력 50달러로, 속도가 중요한 워크로드에서는 체감 비용이 달라진다.
4. 중국 모델 3종이 가성비로 떠오른 이유
사용자가 추천한 딥시크 V4 플래시·Kimi K2.6·GLM-5.2가 왜 매력적인지 원가가 명확히 보여준다.
딥시크 V4 플래시가 압권이다. 공식 단가가 입력 0.14달러 / 출력 0.28달러다. 캐시 히트가 나면 입력이 0.0028달러까지 떨어져 사실상 거의 공짜에 가깝다. GPT-5.5 출력(30달러) 대비 약 107배 저렴하고 Claude Sonnet(15달러) 대비 53배 저렴하다. 젠스파크 배수 0.14x는 이 극단적 저가를 그대로 옮긴 값이다. 1M 컨텍스트와 384K 출력을 지원하면서도 이 단가라 대량 처리에 유리하다. 단, V4 Pro는 현재 75% 런칭 프로모션이 걸려 있어 표준 1.74/3.48달러에서 0.435/0.87달러로 내려가 있고, 프로모션 종료 후에는 정상가로 돌아간다는 점을 장기 계획에 넣어야 한다.
Kimi K2.6은 공식 단가가 입력 0.95달러 / 출력 4.00달러(캐시 히트 0.19달러)다. 젠스파크 배수 0.95x가 입력 단가와 거의 일치한다. 256K 컨텍스트를 지원하고 장기 코딩·에이전트 오케스트레이션에 특화된 오픈소스 모델이라, 커서 같은 코딩 환경에서 쓸 때 "속도 빠르고 코딩을 잘한다"는 체감은 가격 대비 성능 측면에서 타당하다.
GLM-5.2는 입력 1.40달러 / 출력 4.40달러(캐시 0.26달러)로, GPT-5.4와 비슷한 체감 품질을 1x 가격에 준다. 더 큰 강점은 라이선스다. Z.ai가 2026년 6월에 MIT 라이선스로 744B 매개변수 MoE 가중치를 공개했기 때문에, 기업이 자체 GPU에 무료로 호스팅·상업 이용·파인튜닝할 수 있다. API 요금을 아예 0으로 만들 수 있는 유일한 구조다.
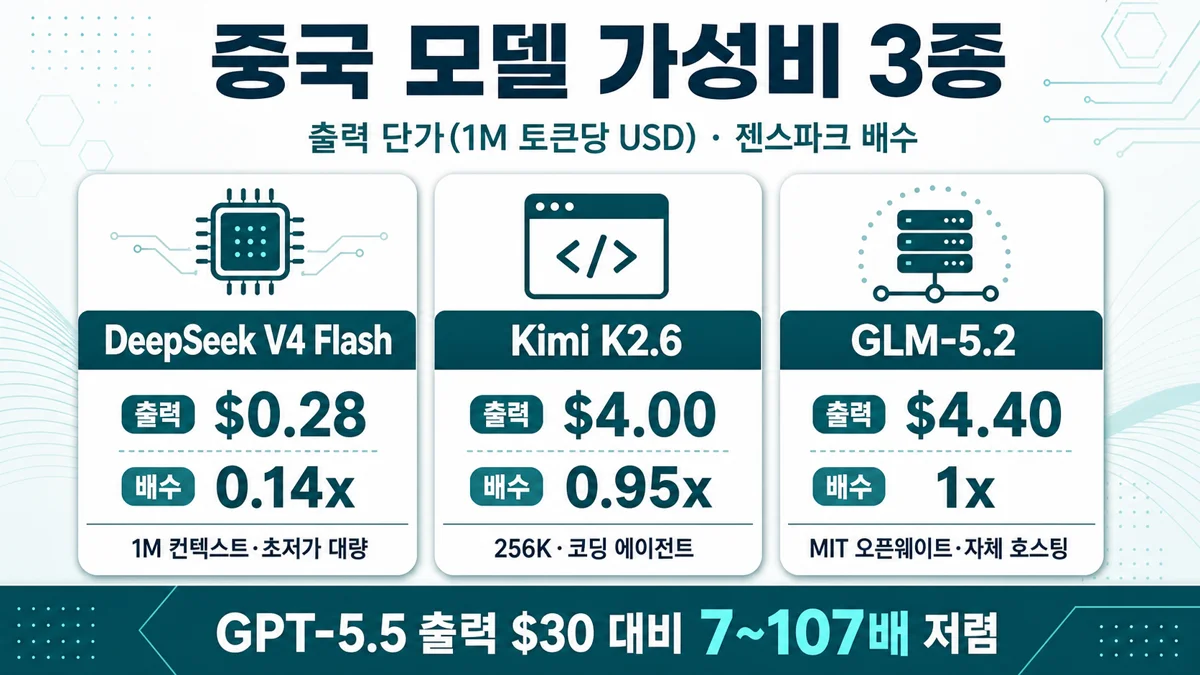
그림 3. DeepSeek V4 Flash(출력 $0.28·0.14x)·Kimi K2.6($4.00·0.95x)·GLM-5.2($4.40·1x, MIT 오픈웨이트) — GPT-5.5 출력 $30 대비 7~107배 저렴.
5. 모델을 만든 회사와 진영 구도
각 모델을 누가 만들었는지, 어떤 배경인지 정리하면 가격 차이의 맥락이 보인다.
OpenAI는 ChatGPT를 만든 미국 회사로 젠스파크 라인업에서 가장 많은 자리를 차지한다. GPT-5.5는 현재 플래그십이자 역대 최강 에이전틱 코딩 모델을 표방한다. Anthropic은 클로드를 만든 미국 회사로 코딩·에이전트·안전성에서 업계 선두로 평가받는다. Claude Opus 4.8은 양산 모델 중 코딩 최강권이다. Google DeepMind는 검색·멀티모달에 강점을 둔 미국 진영으로 Gemini 3 Pro가 LMArena에서 처음으로 1500 Elo를 넘긴 적이 있다.
중국 진영은 다르게 움직인다. 딥시크는 헤지펀드 하이플라이어(환방)의 창업자 량원펑이 만든 AI 랩으로, 정량 트레이딩 회사가 모회사라는 독특한 배경을 갖는다. 적은 학습 비용으로 프런티어급 성능을 내는 것으로 유명하다. 문샷 AI(월지암면)는 베이징 스타트업으로 Kimi K2.6을 오픈소스 네이티브 멀티모달 에이전트 모델로 내놓았다. Z.ai(옛 지푸 AI)는 칭화대 계열에서 출발해 GLM-5.2를 MIT 오픈웨이트로 풀었다. MiniMax 역시 중국 사로 1M 컨텍스트를 지원하는 M3를 저가에 내놓았다.
xAI는 일론 머스크의 회사로 X(트위터) 실시간 데이터 접근과 빠른 속도가 특징이다. Grok 4.20은 Reasoning과 Non-Reasoning 두 모드로 제공된다. 미국 진영이 최상위 품질을 쥐고 있되 출력 단가가 압도적으로 비싸고, 중국 진영은 오픈웨이트 전략으로 프런티어급에 근접하면서 단가는 5분의 1에서 100분의 1 수준인 구도다.
6. 벤치마크로 본 성능 차이
가격만 싸다고 갈아탈 수는 없다. 성능도 따져야 한다. 코딩 능력의 표준 지표인 SWE-bench 시리즈로 보면 진영 간 격차가 좁혀지고 있다.
| 벤치마크 | GLM-5.2 | GPT-5.5 | Claude Opus 4.8 |
|---|---|---|---|
| Terminal-Bench 2.1 | 81.0 | 84.0 | 85.0 |
| SWE-bench Pro | 62.1 | 58.6 | 69.2 |
| FrontierSWE | 74.4 | 72.6 | 75.1 |
| MCP-Atlas | 76.8 | 75.3 | 77.8 |
| NL2Repo | 48.9 | 50.7 | 69.7 |
| SWE-Marathon | 13.0 | 12.0 | 26.0 |
읽는 법은 명확하다. 최상위 코딩은 여전히 Claude Opus 4.8이 잡고 있다. SWE-bench Pro 69.2, FrontierSWE 75.1, MCP-Atlas 77.8로 대부분 지표에서 1위다. GPT-5.5는 Terminal-Bench와 수학 쪽에서 강하고 DeepSWE·ProgramBench·Tool-Decathlon 같은 일부 벤치에서 GLM-5.2를 앞선다. 반면 GLM-5.2는 SWE-bench Pro 62.1로 GPT-5.5(58.6)를 제쳤고 FrontierSWE·MCP-Atlas에서도 GPT-5.5를 앞선다. 출력 단가가 GPT-5.5의 약 7분의 1임을 감안하면 상징적인 결과다.
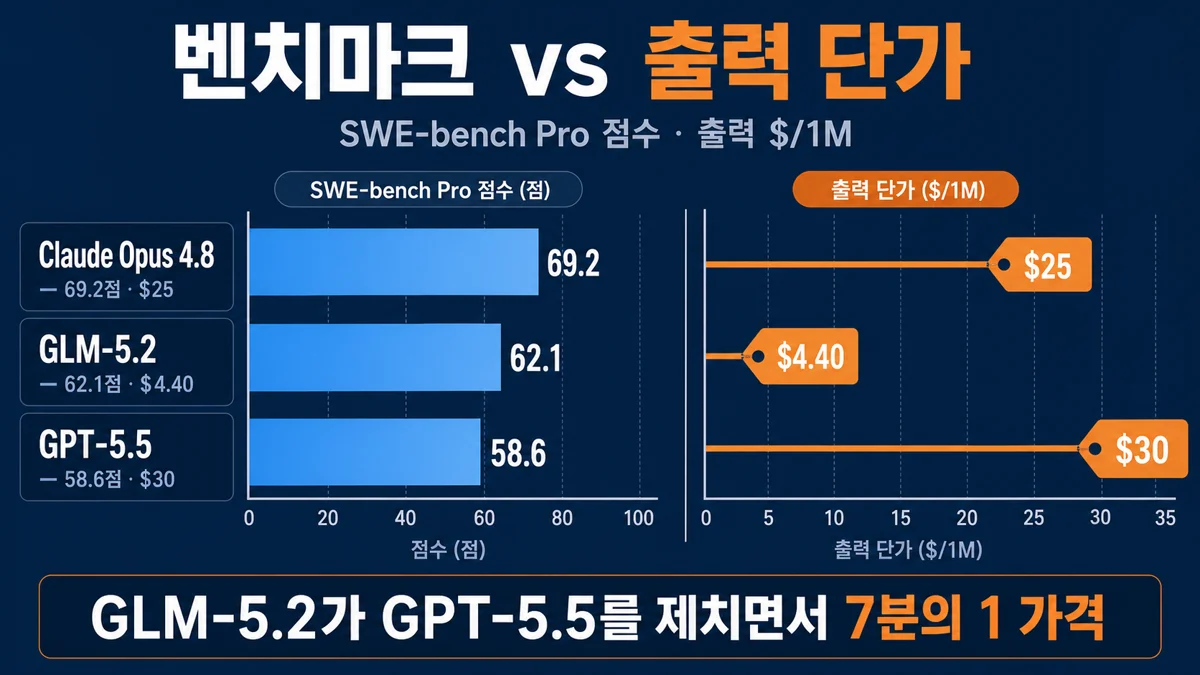
그림 4. SWE-bench Pro 점수와 출력 단가 — Claude Opus 4.8이 69.2점으로 최상위, GLM-5.2가 62.1점으로 GPT-5.5(58.6)를 제치면서 출력 단가는 7분의 1.
주의할 점이 있다. GLM-5.2가 GPT-5.5를 이겼다는 벤치마크 상당수가 Z.ai 자체 발표 수치다. 제3자 검증 리더보드에서는 여전히 Claude·GPT 계열이 상위인 경우가 많아, 마케팅 수치와 독립 측정치를 구분해 봐야 한다. 인공지능 분석 지표(Intelligence Index)에서는 GLM-5.2가 오픈웨이트 1위지만 Claude Opus 4.8·GPT-5.5 뒤에 서는 식이다. 즉 싼 만큼 거의 다가간 것이지 완전히 앞선 것은 아니다.
7. Gemini와 Grok, 가격과 실사용 평가
제미나이는 가격만 보면 의외로 저렴하다. Gemini 3 Flash가 0.5x, Flash Lite가 0.3x로 단가가 0.30~0.50달러대다. Flash 계열은 가성비 구간이 맞다. 다만 사용자가 "제미나이는 구해서 안 쓴다"고 한 것은 가격이 아니라 실사용 체감에 대한 의견이다. 벤치마크 수치는 상위권이지만 지시 따르기·코딩 에이전트 안정성에서 체감이 떨어진다는 보고가 잦다. 출력 단가도 Flash 외에는 3.5 Flash 9달러, 3.1 Pro 12달러로 마냥 싸지 않다. 가격에 민감하다면 Flash Lite·Flash까지만 쓰고 무거운 작업은 다른 모델로 넘기는 것이 현실적이다.
그록은 가격 자체는 나쁘지 않다. Grok 4.20이 입력 1.25달러 / 출력 2.50달러로 2x다. 속도·비용 대비는 준수한 편이다. 다만 커뮤니티에서는 "4.20은 사실상 이전 에이전트 4개를 묶은 것"이라는 회의론과 잦은 출시 지연·인력 이탈이 거론된다. 사용자가 "맛이 갔다"고 한 평가는 지능보다 안정성·체감 쪽에 가깝고, 단가표만 보면 버리기엔 아깝지만 품질 신뢰도에서 다른 선택을 하는 흐름이 있다.
8. 작업 유형별 모델 선택 기준
단가와 성능을 동시에 보면 작업 유형별 최적이 달라진다. 아래 표는 비용 민감도와 난이도를 축으로 정리한 가이드다.
| 작업 유형 | 1순위 모델 | 이유 |
|---|---|---|
| 최고 난도 코딩·에이전트 | Claude Opus 4.8 | SWE-bench Pro·FrontierSWE 1위, 완수율 최고 |
| 수학·터미널·정밀 추론 | GPT-5.5 | Terminal-Bench·USAMO 강세, 다만 출력 30달러 |
| 가성비 코딩·에이전트 | GLM-5.2 | GPT-5.5를 일부 코딩 벤치에서 앞서면서 7분의 1 가격 |
| 코딩 에이전트(오픈소스) | Kimi K2.6 | 256K 컨텍스트, 빠르고 코딩 안정적, 0.95x |
| 초저가 대량 처리 | DeepSeek V4 Flash | 출력 0.28달러, 1M 컨텍스트, 사실상 최저가 |
| 멀티모달·검색 | Gemini 3 Flash | 저단가·빠름, 무거운 작업은 비추천 |
| 실시간 데이터·속도 | Grok 4.20 | X 데이터 접근, 2x, 지능은 평범 |
전략을 한 줄로 줄이면, 비용에 민감하면 딥시크 V4 플래시(초저가) → Kimi K2.6(코딩·에이저트) → GLM-5.2(범용) 순으로 쓰되, 최고 난도 추론이나 정밀 작업에서는 Claude Opus 4.8·GPT-5.5의 품질 우위를 살리는 것이다. 작업 난이도에 따라 모델을 갈아 끼우는 게 단가와 품질을 동시에 잡는 가장 합리적인 운영법이다.
9. 마무리
여기까지 젠스파크 모델 가격 가중치를 공식 API 단가와 벤치마크로 검증한 내용을 짧게 정리한다.
- 젠스파크 배수는 자의적 기준이 아니라 각 모델사의 출력 토큰 단가를 거의 선형으로 반영한 원가 기반 지표다.
- GPT·Claude가 비싼 건 출력 25~30달러라는 높은 단가 때문이고, Pro·o3-pro 계열은 reasoning 토큰 폭발로 더 비싸다.
- 딥시크 V4 플래시(출력 0.28달러)·Kimi K2.6(0.95x)·GLM-5.2(1x, MIT 오픈웨이트)은 프런티어급에 근접하면서 단가는 5분의 1~100분의 1이다.
- Claude Opus 4.8이 코딩 최상위(SWE-bench Pro 69.2)를 유지하고, GLM-5.2가 SWE-bench Pro 62.1로 GPT-5.5를 제치는 등 중국 모델이 빠르게 추격 중이다.
- 단가만 보면 제미나이 Flash도 가성비 구간이지만 실사용 체감은 별개고, 그록은 단가는 괜찮아도 안정성 논란이 있다.
- 비용 민감형은 딥시크 V4 플래시 → Kimi K2.6 → GLM-5.2 순, 최고 난도는 Claude Opus 4.8·GPT-5.5를 작업 난이도에 맞춰 섞어 쓰는 것이 최적이다.
「배수를 읽으면 그 모델의 진짜 원가 구조가 보이고, 원가와 벤치마크를 같이 보면 가성비 교체 타이밍이 보인다」 — 중국 모델로 갈아탈지 고민이라면, 딥시크 V4 플래시의 프로모션 종료 시점과 GLM-5.2 자체 발표 벤치마크의 한계를 함께 챙기면서 소량 먼저 시험해 보길 권한다. 수치·프로모션은 시점에 따라 변하므로 중요 의사결정 전에는 공식 가격 페이지를 한 번 더 확인하라.
자주 묻는 질문
- 젠스파크 배수 1x와 5x는 정확히 무슨 차이인가요?
1x는 기준 단위 크레딧 1회 소모이고 5x는 그 5배를 소모한다는 뜻이다. 젠스파크 공식 도움말은 고급 모델일수록 사용 1회당 크레딧을 더 쓴다고만 밝히고 정식 단가표는 공개하지 않으므로, 화면의 배수는 사용자가 관찰한 값이다. 다만 이 배수는 각 모델사의 출력 토큰 단가와 강한 상관을 보여, 배수만 봐도 해당 모델의 실제 API 원가 위상을 짐작할 수 있다.
- GPT-5.5와 Claude Opus 4.8 중 어느 쪽이 더 비싸나요?
출력 토큰 기준으로 GPT-5.5가 더 비싸다. GPT-5.5는 입력 5달러 / 출력 30달러, Claude Opus 4.8은 입력 5달러 / 출력 25달러다. 둘 다 젠스파크에서 5x로 묶여 있지만 실제 단가는 GPT-5.5가 약 20% 더 높다. 다만 Claude Opus 4.8에는 2.5배 빠른 Fast Mode가 있어 입력 10달러 / 출력 50달러로 속도가 중요한 워크로드에서는 체감 비용이 달라진다.
- Claude Opus 4.8이 4.7보다 비싸진 이유가 뭔가요?
비싸지지 않았다. Anthropic 공식 발표에 따르면 Opus 4.8은 2026년 5월 28일 출시됐고 단가가 입력 5달러 / 출력 25달러로 4.7과 동일하다. 젠스파크 배수도 둘 다 5x로 같다. 신모델이라 더 비싸게 매긴 것이 아니라 원가를 그대로 반영한 합리적 책정이다. 1M 컨텍스트가 기본으로 켜지고 Claude Code Workflows가 추가되는 등 기능은 올랐지만 단가는 그대로다.
- 딥시크 V4 플래시가 정말 거의 공짜인가요?
캐시 히트가 나면 입력이 1M 토큰당 0.0028달러까지 떨어져 사실상 공짜에 가깝다. 캐시 미스여도 입력 0.14달러 / 출력 0.28달러로 GPT-5.5 출력(30달러) 대비 약 107배 저렴하다. 1M 컨텍스트와 384K 출력을 지원하므로 대량 에이전트 트래픽에 가장 유리한 구간이다. 다만 V4 Pro의 75% 프로모션은 시한부라 종료 후 정상가 1.74/3.48달러로 돌아가므로 장기 계획에는 정상가도 함께 넣어야 한다.
- GLM-5.2가 GPT-5.5를 이겼다는 벤치마크를 믿어도 되나요?
SWE-bench Pro 62.1 대 58.6, FrontierSWE 74.4 대 72.6, MCP-Atlas 76.8 대 75.3 등 여러 장기 코딩 벤치에서 GLM-5.2가 GPT-5.5를 앞선 수치는 사실이다. 다만 이 수치 상당수가 Z.ai 자체 발표라는 점에 주의해야 한다. 제3자 검증 리더보드에서는 여전히 Claude·GPT 계열이 상위인 경우가 많아, 마케팅 수치와 독립 측정치를 구분해 보는 것이 안전하다. 출력 단가가 7분의 1임을 감안하면 가성비로는 충분히 매력적이다.
- Kimi K2.6은 커서 같은 코딩 환경에서 실제로 쓸 만한가요?
256K 컨텍스트와 장기 코딩·에이전트 오케스트레이션에 특화된 오픈소스 모델이라 코딩 환경에서 쓸 만하다. 공식 단가가 입력 0.95달러 / 출력 4.00달러(캐시 히트 0.19달러)로 Claude Opus 출력의 6분의 1 수준이며, 커서에서 속도가 빠르고 코딩이 안정적이라는 실사용 보고가 잦다. 젠스파크 배수 0.95x가 입력 단가와 거의 일치하는 것도 원가 반영이 정확함을 보여준다.
- 제미나이는 가격이 싼데 왜 안 쓴다는 평이 많나요?
가격만 보면 Gemini 3 Flash(0.5x)·Flash Lite(0.3x)는 가성비 구간이 맞다. 벤치마크 수치도 상위권이다. 다만 실사용에서 지시 따르기와 코딩 에이전트 안정성 체감이 떨어진다는 보고가 잦아, 가격이 아닌 품질·사용성 측정에서 불호 평이 나온다. 또한 Flash 외에는 출력 단가가 3.5 Flash 9달러, 3.1 Pro 12달러로 마냥 싸지도 않다. 가벼운 작업은 Flash 계열, 무거운 작업은 다른 모델로 넘기는 운영이 현실적이다.
- 그록 4.20은 왜 버리라는 평이 나오나요?
단가 자체는 입력 1.25달러 / 출력 2.50달러(2x)로 나쁘지 않고 속도·비용 대비는 준수하다. 다만 커뮤니티에서 4.20이 사실상 이전 에이전트 4개를 묶은 것이라는 회의론과 잦은 출시 지연·인력 이탈이 거론되어 지능보다 안정성·체감 신뢰도에서 밀린다는 평이 많다. 단가표만 보면 버리기 아깝지만, 품질 일관성이 중요한 워크로드라면 같은 2x 안정권에서 다른 선택을 하는 흐름이 있다.
- 비용에 가장 민감한 1인 개발자는 어떤 조합이 좋나요?
초저가 대량 처리는 딥시크 V4 플래시, 코딩·에이전트는 Kimi K2.6, 범용은 GLM-5.2 순으로 기본을 잡는 것이 데이터상 가장 합리적이다. 세 모델 모두 프런티어급에 근접하면서 단가는 5분의 1에서 100분의 1 수준이다. 다만 최고 난도 추론이나 정밀 작업이 섞여 있으면 그 구간만 Claude Opus 4.8이나 GPT-5.5로 교체하는 식으로 작업 난이도별로 모델을 갈아 끼우는 것이 단가와 품질을 동시에 잡는 운영법이다.
- 오픈라우터와 공식 API 중 어디서 가격을 확인해야 하나요?
기준은 각 모델사 공식 문서가 정본이다. Anthropic·OpenAI·DeepSeek·Z.ai는 공식 가격 페이지를 운영하므로 거기를 우선 확인한다. OpenRouter는 여러 모델을 한 번에 비교하기 편하지만 마진이나 경로에 따라 공식가와 약간 차이가 날 수 있어 참고용으로 쓴다. 프로모션·캐시 히트 단가는 시점에 따라 자주 바뀌므로 장기 워크로드 설계 시에는 공식가와 프로모션 종료 후 정상가를 같이 챙기는 것이 안전하다.