 테크·IT
에이전트를 로컬에서 돌리다 보면 이상한 장면이 반복된다. CPU 사용률은 들쭉날쭉한데 메모리 사용률만 계속 높다. 16GB 노트북은 로컬 모델을 안 깔아도 Cursor·브라우저·Docker가 겹치면 멈춘다. 같은 시기 뉴스에는 SK하이닉스·삼성전자 주가와 HBM 이야기가 쏟아진다. 둘은 다른 이야기처럼 보이지만, 뿌리는 같다.
CPU·GPU는 계산하는 엔진이고, 메모리는 지금 계산에 필요한 재료와 중간 상태를 펼쳐 두는 작업 공간이다. AI 시대에 이 작업 공간이 유난히 중요해진 이유는 셋이다.
- AI 모델 자체가 거대한 숫자 배열이라, 계산 전에 가중치를 메모리에 올려야 한다.
- AI는 한 번 계산하고 끝내지 않고, 이전 토큰·대화·중간 결과를 붙잡은 채 다음 계산에 재사용한다.
- 계산기(코어)가 너무 빨라져, 이제는 데이터를 공급하는 용량·대역폭이 병목이 되는 경우가 많다.
그래서 AI 성능은 대략 이렇게 읽힌다. 용량이 "무엇을 실행할 수 있는가"를, 대역폭이 "얼마나 빨리"를, 지연시간이 "얼마나 즉각 반응하는가"를 결정한다. 이 글은 RAM·VRAM·HBM·SSD 사이에서 메모리가 실제로 하는 일부터, 16GB가 멈추는 이유, LLM·에이전트의 메모리 로직, 하드웨어 "기억"과 ChatGPT식 "You have memory"의 차이, 그리고 삼성·하이닉스가 AI 인프라에서 부각되는 구조적 이유까지 한 번에 정리한다. 주가 설명은 산업 구조 설명이지 매매 권유가 아니다.
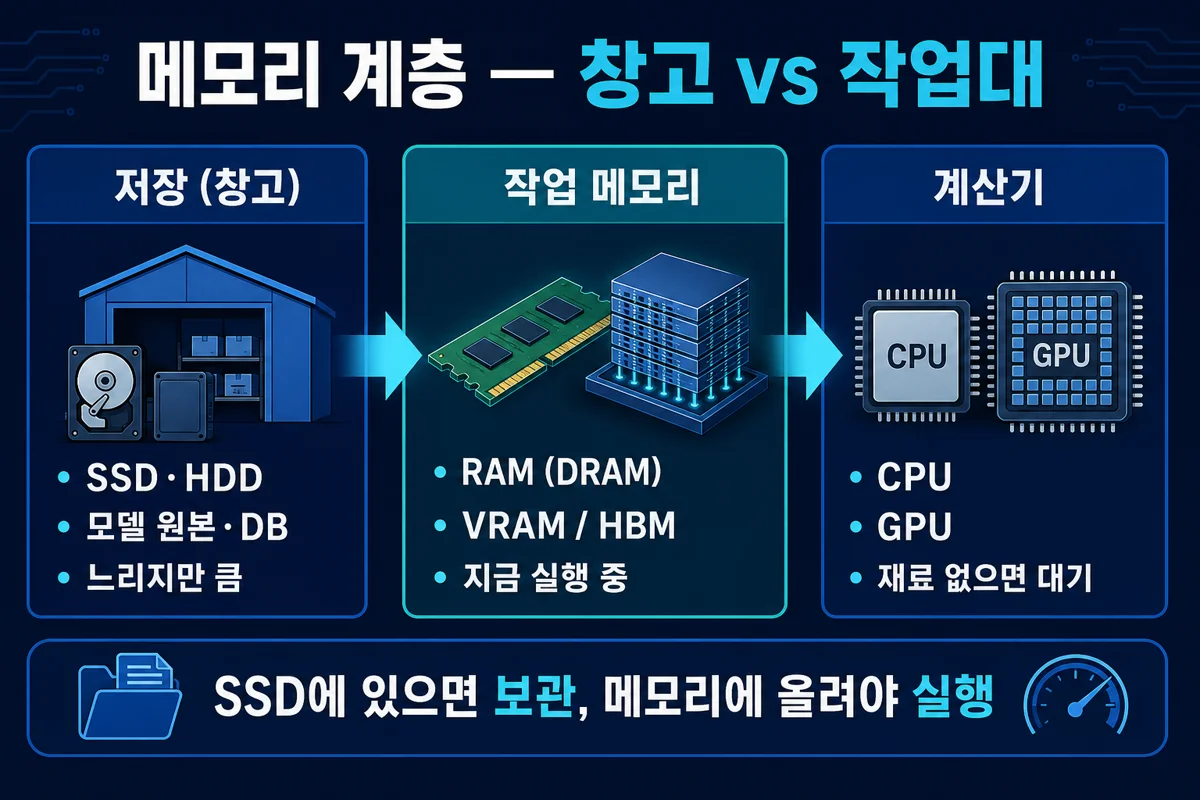 그림 1. SSD는 창고, RAM·HBM은 작업대, CPU·GPU는 작업자 — 올려야 실행된다
1. 메모리의 역할은 정확히 무엇인가
컴퓨터는 데이터를 여러 층에 나눠 둔다. 계층마다 속도·용량·가격·전원이 꺼졌을 때 유지 여부가 다르다.
| 계층 | 역할 | 특징 |
|---|---|---|
| CPU 레지스터 | 지금 당장 계산하는 값 | 극도로 빠르지만 극소량 |
| CPU/GPU 캐시 | 곧 다시 쓸 값 | 빠르지만 작음 |
| RAM/DRAM | 실행 중인 프로그램과 데이터 | 빠르고 비교적 큼, 전원 끄면 사라짐 |
| VRAM/HBM | GPU가 계산할 모델·텐서·KV 캐시 | 매우 높은 대역폭, 비쌈 |
| SSD/NVMe | 파일·DB·모델 원본의 장기 보관 | 크지만 RAM보다 훨씬 느림 |
| HDD·원격 스토리지 | 대규모 보관·백업 | 더 느리지만 저렴함 |
핵심 원리는 한 줄이다. 저장장치에는 데이터를 보관하고, 메모리에는 지금 실행하는 데이터를 올린다.
예를 들어 10GB짜리 AI 모델 파일이 SSD에 있다고 하자. SSD에 있는 상태는 "보관"이다. 실제로 계산하려면 가중치를 RAM 또는 VRAM으로 읽어 와야 하고, GPU는 VRAM에서 가중치를 가져와 행렬 연산을 한다. 대화가 길어지면 이전 토큰 상태인 KV 캐시도 VRAM에 쌓인다. 결과가 끝나면 일부는 버리고, 보존할 것만 DB나 SSD에 남긴다.
SSD가 창고라면 RAM은 작업대이고, CPU·GPU는 작업자다. 작업자가 빨라도 작업대가 작으면 재료를 창고에 넣었다 꺼내기를 반복한다. 그게 바로 느려짐·끊김의 본체다.
2. SSD를 메모리처럼 쓰면 왜 느려지는가
"SSD도 빠른데 RAM 대신 쓰면 되지 않나"는 자연스러운 질문이지만, 두 장치는 목적이 다르다.
| 항목 | RAM | SSD |
|---|---|---|
| 적합한 작업 | 작은 위치를 빈번히 읽고 쓰기 | 파일·큰 블록 영구 저장 |
| 지연시간 | 낮음 | RAM보다 훨씬 큼 |
| 랜덤 작은 I/O | 강함 | 반복되면 성능 급락 |
| 전원 | 끄면 내용 소실 | 유지 |
| 쓰기 내구성 | 상대적으로 제약이 작음 | 쓰기 증폭·내구성 이슈 |
RAM이 부족하면 OS는 일부 페이지를 SSD의 스왑·페이지 파일로 내보낸다. Microsoft 문서도 Windows 페이지 파일이 "자주 안 쓰는 페이지를 밀어내고 커밋 한도를 확장"하는 역할을 한다고 설명한다. 하지만 커밋이 한계에 가까우면 멈춤·충돌이 나타날 수 있다. 즉 스왑은 RAM을 대체하는 장치가 아니라, 죽지 않게 버티게 하는 비상 공간이다.
RAM이 부족하면 보통 다음이 반복된다.
- 사용하지 않는 RAM 캐시를 비움
- 오래된 페이지를 SSD로 이동
- 필요한 페이지를 다시 SSD에서 읽음
- 다른 페이지를 다시 밀어냄
- 디스크 사용률이 치솟고 시스템이 끊김
- 더 심해지면 OOM·앱 강제 종료·전체 멈춤
이 반복이 스래싱(thrashing) 이다. "디스크가 100%인데 CPU는 한가하다"는 장면의 전형적 원인이다.
3. CPU 사용률은 낮은데 메모리는 왜 높은가
둘은 같은 종류의 지표가 아니다.
CPU 사용률은 일정 시간 동안 CPU가 얼마나 바쁘게 계산했는가의 지표다. 요청을 받으면 잠깐 80%, DB를 기다리는 동안 5%, 입력 대기 중 1%처럼 시간에 따른 활동량이다.
메모리 사용률은 한 번 할당하면 그 데이터가 필요 없어질 때까지 점유한다. 서버가 쉬어도 애플리케이션 코드, Python·Node 런타임, DB 연결 풀, 캐시, 세션, 대화 기록, 검색 인덱스, 로드된 모델, KV 캐시, 파일 시스템 페이지 캐시, 컨테이너·VM이 작업대 위에 남을 수 있다. 그래서 계산이 없는 순간에도 메모리 70~80%는 흔하다.
한 줄로 말하면, CPU는 "지금 일하고 있는가", 메모리는 "작업대 위에 무엇을 펼쳐 놨는가"다.
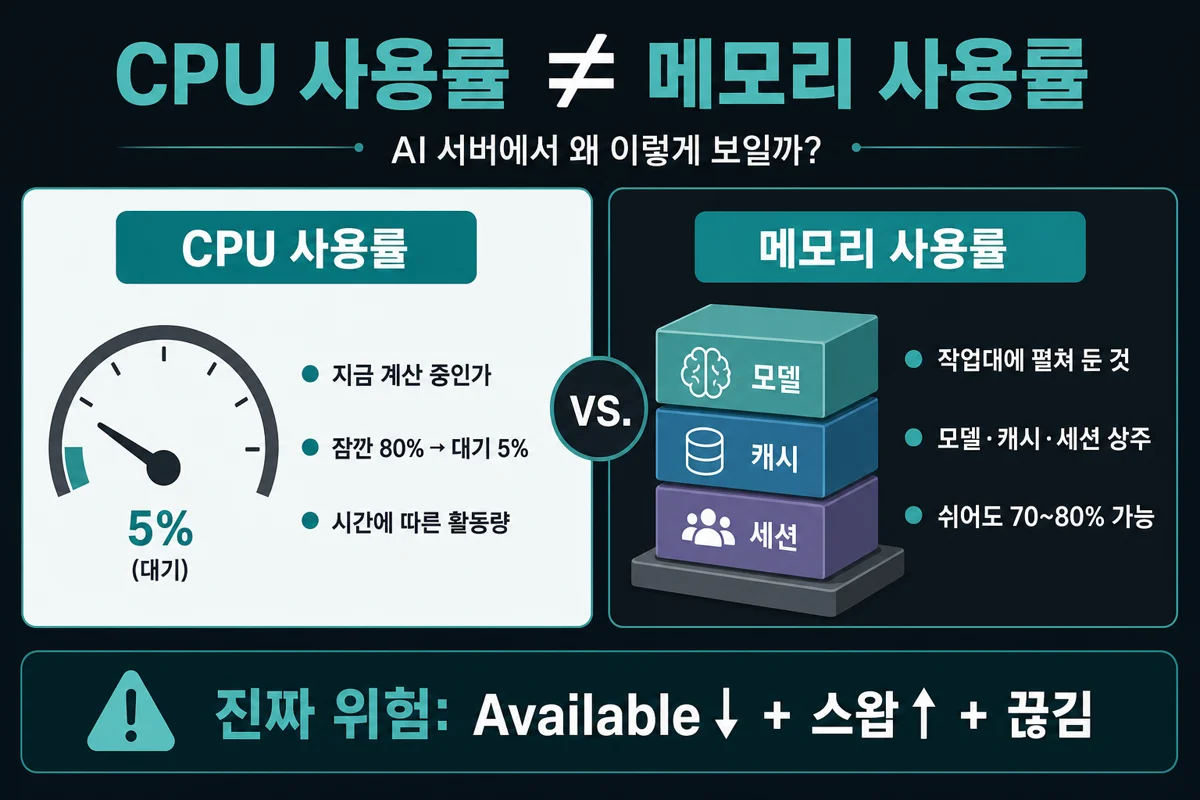 그림 2. CPU는 순간 활동량, 메모리는 상주 점유 — Available·스왑·끊김을 같이 보라
높은 메모리 사용률이 항상 문제는 아니다. Linux 계열은 남는 RAM을 파일 캐시로 적극 쓴다. 필요하면 애플리케이션에 돌려주기 때문에 used만 보고 판단하면 안 된다. Red Hat 문서도 디스크 I/O를 줄이려고 남는 메모리를 버퍼·페이지 캐시로 쓴다고 설명한다.
진짜로 볼 지표는 다음이다.
- Available Memory가 계속 매우 낮은가
- 스왑 사용량이 지속적으로 증가하는가
- 하드 페이지 폴트가 많은가
- 메모리 압력(macOS Memory Pressure 등)이 노랑·빨강인가
- 안 쓰는데도 특정 프로세스 RSS가 계속 증가하는가
- OOM·메모리 부족 로그가 있는가
- 디스크 사용률이 높으면서 끊기는가
RAM 80%와 RAM 80% + 스왑 폭증은 전혀 다른 상태다.
4. 16GB 노트북에서 AI 에이전트 개발이 멈추는 이유
로컬에 LLM을 설치하지 않았어도, 에이전트 개발 환경 자체가 메모리를 많이 쓴다.
4.1. 운영체제와 브라우저
Windows·macOS·Linux 자체와 백그라운드 서비스가 기본 점유를 만든다. Chrome·Edge는 탭·확장·GPU 프로세스·사이트별 프로세스를 분리한다. ChatGPT, Claude, 문서, GitHub, 로컬 앱을 동시에 띄우면 금방 커진다.
4.2. IDE와 언어 서버
Cursor·VS Code·Windsurf는 단순 텍스트 편집기가 아니다. Electron/Chromium 런타임, 확장 호스트, TypeScript·Python 언어 서버, 심볼 인덱스, Git 상태, 파일 감시, AI 코딩 대화, 코드베이스 인덱스가 한꺼번에 올라간다. 큰 저장소에서는 언어 서버가 타입·참조 관계를 메모리에 올린다.
4.3. 개발 서버와 Docker
프론트 개발 서버, 백엔드 API, 워커, 테스트 러너가 각각 별도 프로세스다. Docker Desktop은 Windows/macOS에서 내부 Linux VM을 쓸 수 있고, 문서상 VM 메모리 제한이 호스트의 약 50% 기본인 환경도 있다. PostgreSQL, Redis, 벡터 DB, API, 워커, 메시지 큐, 관찰성 도구가 겹치면 16GB는 빠르게 찬다.
4.4. 에이전트 런타임 데이터
시스템 프롬프트, 현재 대화, 도구 호출 입출력, 웹 검색 결과, PDF 원문, 파싱된 JSON, 실행 계획, 체크포인트, 임베딩용 텍스트, 코드 파일 내용, 로그·추적이 쌓인다. 특히 도구 결과가 크면 같은 데이터가 여러 표현으로 중복된다. PDF 하나가 원본·추출 텍스트·청크·메타데이터·임베딩 배치·벡터·DB 버퍼·LLM용 JSON·로그 복사본으로 동시에 존재할 수 있다.
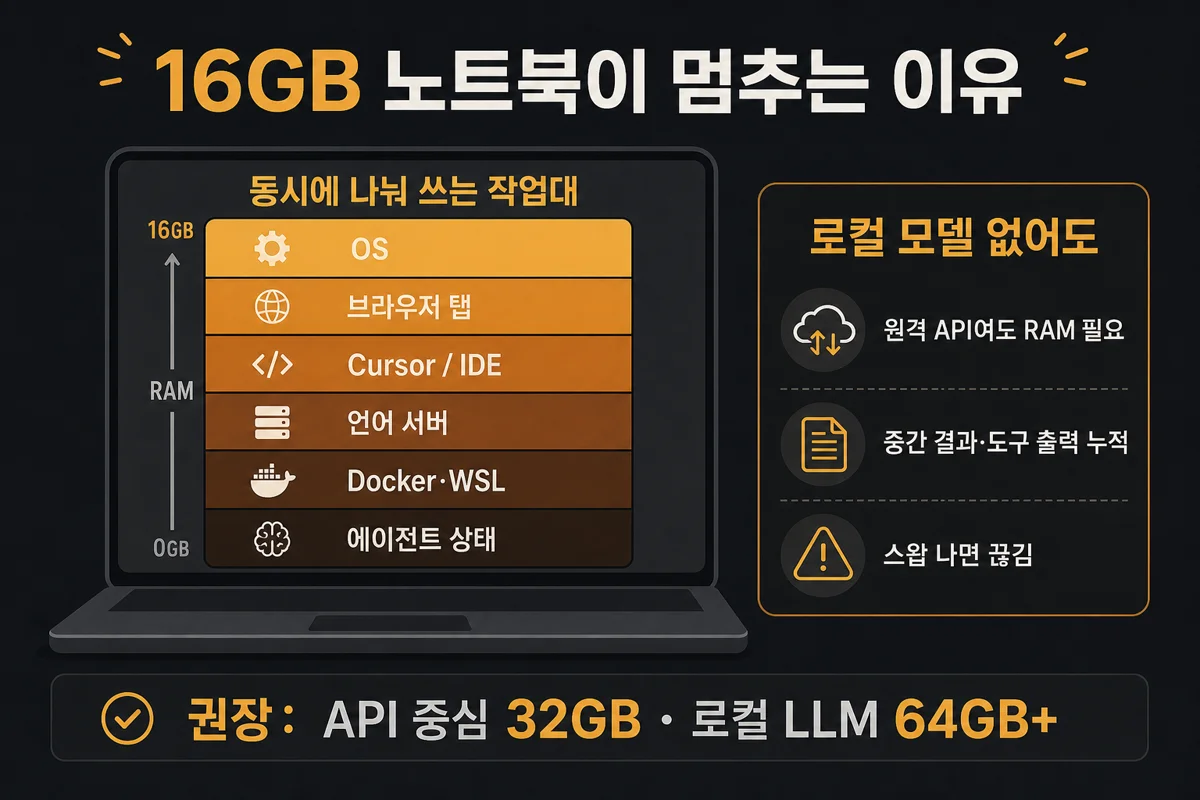 그림 3. OS·브라우저·IDE·Docker·에이전트 상태가 16GB 작업대를 동시에 나눠 쓴다
5. 원격 API만 써도 메모리가 필요한 이유
OpenAI·Anthropic·Google 같은 원격 API를 쓰면 모델 가중치·GPU HBM·서버 쪽 KV 캐시는 클라우드에 있다. 노트북에는 모델 실행용 VRAM이 필수는 아니다. 그래도 애플리케이션 개발용 RAM은 남는다.
| 위치 | 주로 쓰는 메모리 |
|---|---|
| 클라우드 추론 서버 | 모델 가중치, GPU HBM, KV 캐시, 배치·사용자 상태 |
| 내 노트북 | IDE, 브라우저, 에이전트 프레임워크, 메시지·도구 결과, 로컬 DB, Docker, 전처리·파싱·로그 |
에이전트는 일반 챗봇보다 로컬 상태를 더 붙잡는다. 챗봇은 "질문 → API 한 번 → 답"이지만, 에이전트는 계획·검색·파일 읽기·코드 실행·검증·재검색·상태 갱신을 한 요청 안에서 이어 간다. 중간 결과가 메모리(또는 세션 스토어)에 남는 구조다.
6. AI 모델이 메모리를 쓰는 정확한 로직
6.1. 모델 가중치
LLM은 수십억 파라미터, 즉 숫자로 된 거대한 행렬이다. 대략적인 가중치 메모리는 파라미터 수 × 파라미터당 바이트다.
| 정밀도 | 70억(7B) 파라미터 대략 |
|---|---|
| FP32 | 약 28GB |
| FP16/BF16 | 약 14GB |
| INT8 | 약 7GB |
| 4비트 | 이론상 약 3.5GB |
NVIDIA도 7B를 FP16으로 로드하면 가중치에 약 14GB가 필요하다고 설명한다. 실제 실행에는 양자화 메타데이터, 버퍼, 런타임 오버헤드, KV 캐시가 더해진다. 그래서 16GB 시스템 RAM이나 8GB VRAM에 "14GB 모델"을 올린다고 여유 있게 돌아가는 그림이 아니다. OS·런타임·KV 공간도 남아 있어야 한다.
6.2. KV 캐시
LLM은 토큰을 하나씩 생성한다. 매 토큰마다 이전 관계를 처음부터 다시 계산하면 너무 느리므로, 각 층에서 계산한 Key·Value를 메모리에 보관한다. 이게 KV 캐시다. 대략 사용자 수 × 대화 길이 × 층 수 × KV 헤드 크기 × 정밀도에 비례한다.
NVIDIA 예시에서는 Llama 2 7B, FP16, 4,096토큰, 배치 1의 KV가 약 2GB다. Llama 3 70B에서 단일 사용자 128K 컨텍스트 KV는 약 40GB가 될 수 있다고 설명한다. "모델은 VRAM에 들어갔는데 대화가 길어지자 OOM"인 경우의 흔한 원인이다.
6.3. 활성값과 학습 오버헤드
층을 통과할 때 activation(중간 텐서)이 생긴다. 추론에서는 비교적 빨리 버릴 수 있지만, 학습에서는 역전파를 위해 많이 보관한다. 배치·입력 길이·해상도·hidden dimension이 커질수록 증가한다.
학습은 보통 파라미터 P + gradient(대략 P) + Adam optimizer state(대략 2P) + activation + 임시 버퍼가 필요하다. PyTorch 문서의 Adam 구조도 이 골격을 따른다. "14GB짜리 모델이니 16GB GPU에서 학습"은 성립하지 않는 경우가 많다.
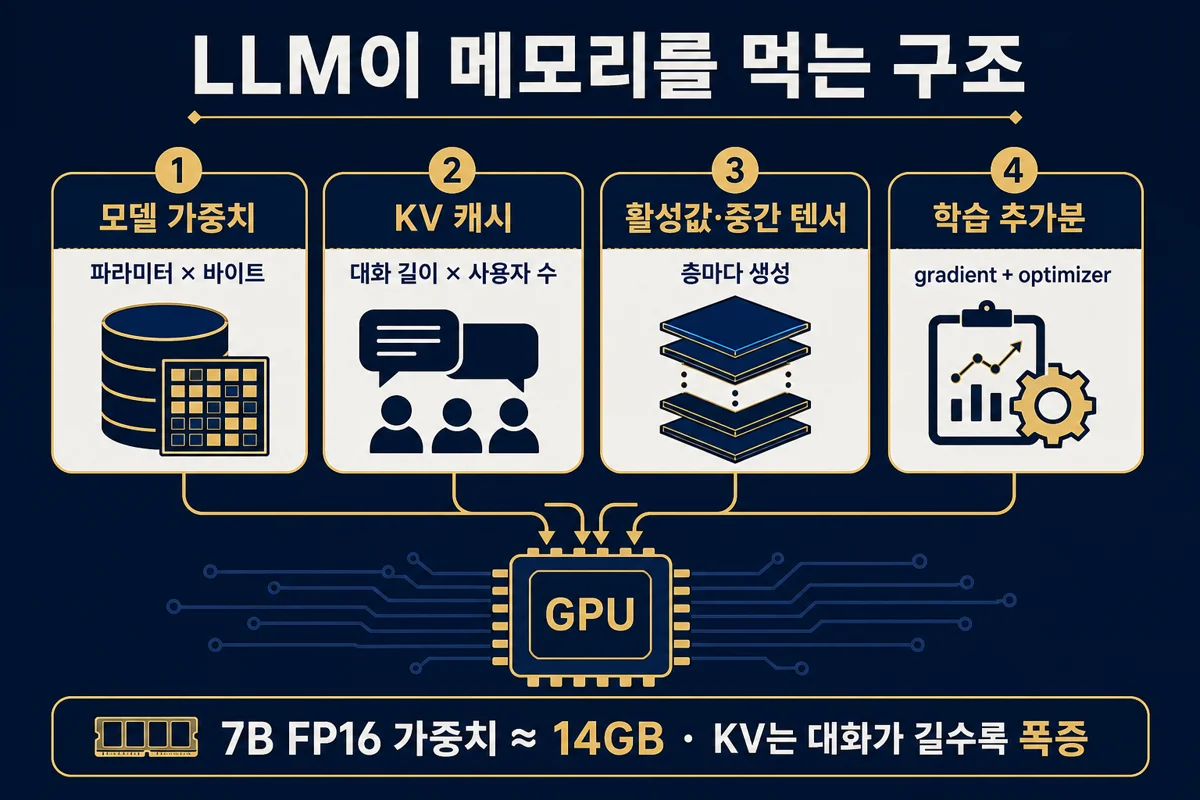 그림 4. 가중치·KV 캐시·활성값·학습용 gradient/optimizer가 GPU 메모리를 나눠 먹는다
7. 왜 LLM은 계산력보다 메모리 대역폭에 막히는가
GPU 코어가 많아도, 가중치와 데이터를 제때 공급하지 못하면 코어는 기다린다.
생성은 크게 두 단계다. Prefill은 입력 프롬프트를 한꺼번에 처리한다. 행렬 연산이 크고 병렬화가 잘 되어 상대적으로 compute-bound가 되기 쉽다. Decode는 토큰을 하나씩 만든다. 앞 토큰이 나와야 다음이 가능하고, 매 토큰마다 가중치·KV에 접근한다. 계산량 대비 읽어야 하는 데이터가 많아 memory-bound가 되기 쉽다.
NVIDIA는 디코드에서 가중치·Key·Value·activation을 메모리에서 가져오는 시간이 계산 시간보다 지연을 지배할 수 있다고 설명한다. GPU 성능 문서도 함수가 계산·메모리 대역폭·지연시간 중 하나에 제한되며, 계산량 대비 읽는 바이트가 적으면 memory-bound가 된다고 한다.
직관적 상한은 대략 이렇다. 이상적 토큰 처리량 ≈ 메모리 대역폭 ÷ 매 토큰 읽어야 하는 모델 데이터 크기. 14GB 모델을 토큰마다 거의 한 번 읽어야 하고 대역폭이 500GB/s라면 500÷14≈초당 35회 수준의 상한이 보인다. 실제는 캐시·양자화·배치·오버헤드로 달라지지만, 4비트 양자화가 용량뿐 아니라 생성 속도에도 영향을 줄 수 있는 이유를 보여 준다. 모델이 14GB에서 약 4GB로 줄면 같은 대역폭으로 더 많은 "한 바퀴"를 돌릴 수 있다.
8. HBM이 왜 AI 시대의 핵심인가
HBM(High Bandwidth Memory)은 단순히 "큰 RAM"이 아니다. 여러 DRAM 다이를 수직 적층하고 TSV로 연결한 뒤 GPU 가까이에 붙여, 매우 넓은 통로로 대량 데이터를 병렬 공급하는 구조다.
고성능 GPU는 계산 코어가 워낙 많아서, 메모리가 데이터를 못 따라가면 코어가 굶는다. 흔히 말하는 메모리 월(memory wall) 이다. Samsung의 HBM4 발표는 단일 스택 최대 대역폭을 3.3TB/s까지 높였고 HBM3E 대비 대역폭을 크게 확대했다고 설명한다.
HBM 경쟁은 DRAM 셀만의 경쟁이 아니다. 미세공정, 적층, TSV, 베이스 다이, 로직 공정, 고급 패키징, 발열·전력, 수율, GPU 업체 인증, 공급 안정성이 함께 작동해야 한다. 기술 난도가 높고 고부가가치이며, 생산능력을 단기간에 무한정 늘리기 어렵다. AI 가속기 수요가 폭증하면 HBM 공급사가 전략적으로 중요해지는 이유다.
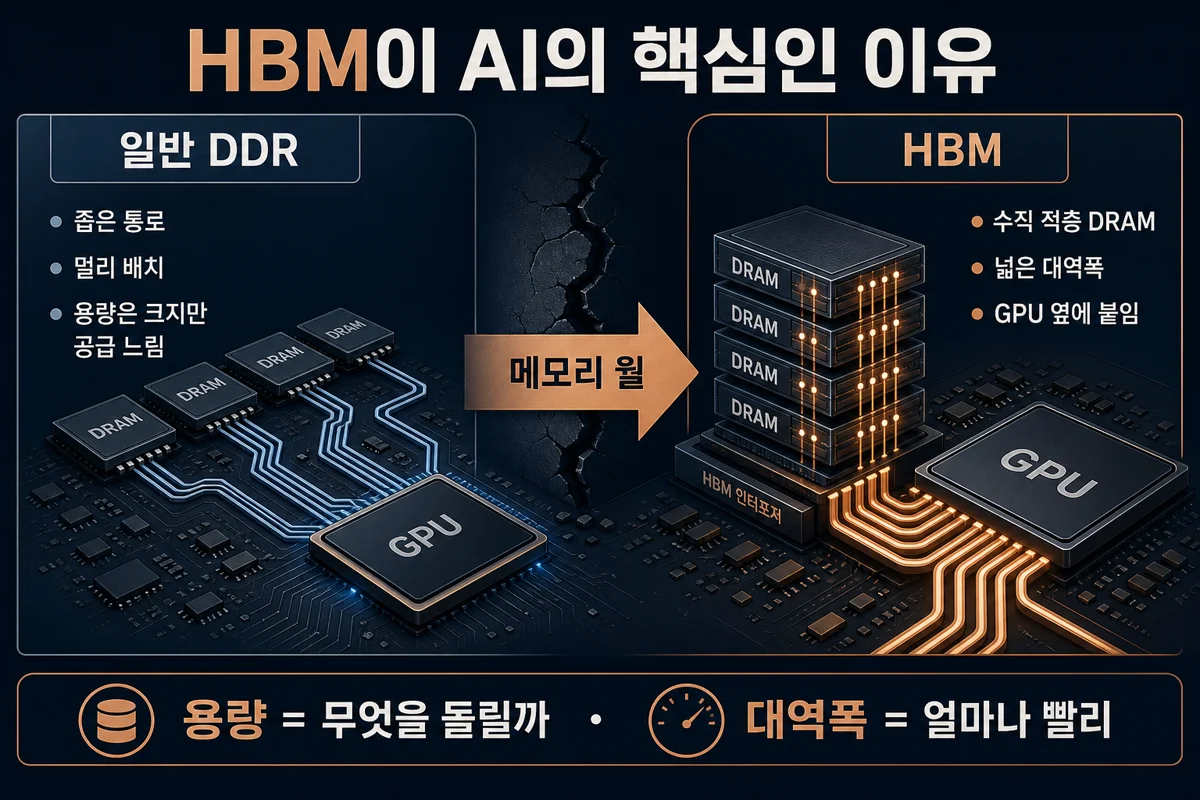 그림 5. 일반 DDR의 좁은 통로 vs HBM의 적층·광대역 — 용량과 대역폭이 역할을 나눈다
9. HBM만 중요한 것이 아니다
AI 서버는 HBM 하나로 끝나지 않는다.
| 계층 | 주로 담는 것 |
|---|---|
| GPU HBM | 모델 가중치, KV 캐시, activation, 연산용 텐서 |
| 서버 DRAM·DDR5 | OS, API, CPU 전처리, 데이터 로더, 벡터 검색, DB 캐시, 에이전트 상태, GPU 오프로드 |
| NAND·Enterprise SSD | 체크포인트, 학습 데이터, 벡터 DB, 사용자 데이터, 로그, 장기 기억, 데이터 레이크 |
AI 인프라가 커질수록 HBM → 서버 DRAM → Enterprise SSD → 대용량 스토리지 수요가 함께 커진다. 2026년 7월 TrendForce는 AI 추론·대형 데이터센터가 NAND 수요를 지지하고, 생산능력이 서버·AI용 메모리로 이동하면서 일반 DRAM 공급도 빡빡해진다고 분석했다.
10. 삼성전자와 SK하이닉스가 부각되는 구조적 이유
주가는 금리·환율·수급·실적 기대·밸류에이션 등 수많은 영향을 받는다. "AI 때문에만 올랐다"고 단정할 수는 없다. 다만 산업 구조상 메모리 업체의 중요도가 커진 이유는 분명하다.
10.1. AI 서버 한 대가 요구하는 메모리 가치가 크다
기존 서버보다 GPU당 HBM 탑재량이 크고, CPU용 서버 DRAM·Enterprise SSD 수요도 크다. 멀티모달·장기 컨텍스트로 데이터량도 증가한다.
10.2. 학습에서 상시 추론으로 수요가 확산된다
학습은 특정 시기에 대규모로 돌리지만, 추론은 서비스가 돌아가는 동안 계속 발생한다. 에이전트는 계획·검색·도구·검증·재시도를 반복하므로, 사용자 한 명당 추론량과 상태 데이터가 늘어날 수 있다.
10.3. HBM은 진입장벽이 높다
고객 인증, 수율, 적층 안정성, 발열·전력, 패키징, GPU와의 결합, 대량 공급 능력이 단순 생산량보다 중요해진다.
10.4. AI용 생산 확대가 일반 메모리에도 파급된다
수익성 높은 HBM·서버 DRAM에 생산능력을 우선 배정하면 PC·스마트폰·일반 DRAM 공급에도 영향이 간다. AI 수요가 메모리 산업 전체 가격에 파급되는 구조다.
SK하이닉스 2026년 1분기 발표도 AI 인프라 투자에 따라 HBM, 고용량 서버 DRAM, Enterprise SSD 판매가 확대됐고, 에이전틱 AI가 DRAM·NAND 수요 기반을 넓힌다고 설명했다. 다시 말하지만 이것은 산업 설명이지 특정 기업 투자 권유가 아니다. 메모리 산업은 공급 증설과 가격 변동에 민감한 사이클 산업이다.
11. AI의 기억과 컴퓨터 RAM은 같은 말이 아니다
용어가 가장 많이 섞이는 지점이다.
| 말 | 실제 의미 |
|---|---|
| 하드웨어 메모리 | RAM·VRAM·HBM처럼 전기적으로 보관하는 반도체 |
| 모델 가중치 | 학습으로 만든 수십억 숫자. "장기기억" 비유는 되지만 DB처럼 사실 조회 구조는 아님 |
| 컨텍스트 윈도 | 이번 요청에서 모델이 읽을 수 있는 토큰 범위(시스템·유저·도구·검색 문서 등) |
| KV 캐시 | 컨텍스트를 빠르게 재사용하려고 GPU 메모리에 두는 계산 상태 |
| 에이전트 장기 기억 | DB·문서·벡터 DB에 저장된 사용자·경험 정보 |
LangChain/LangGraph 문서도 에이전트 메모리를 단기(현재 스레드), 장기(세션 너머), 의미·일화·절차 기억으로 구분한다.
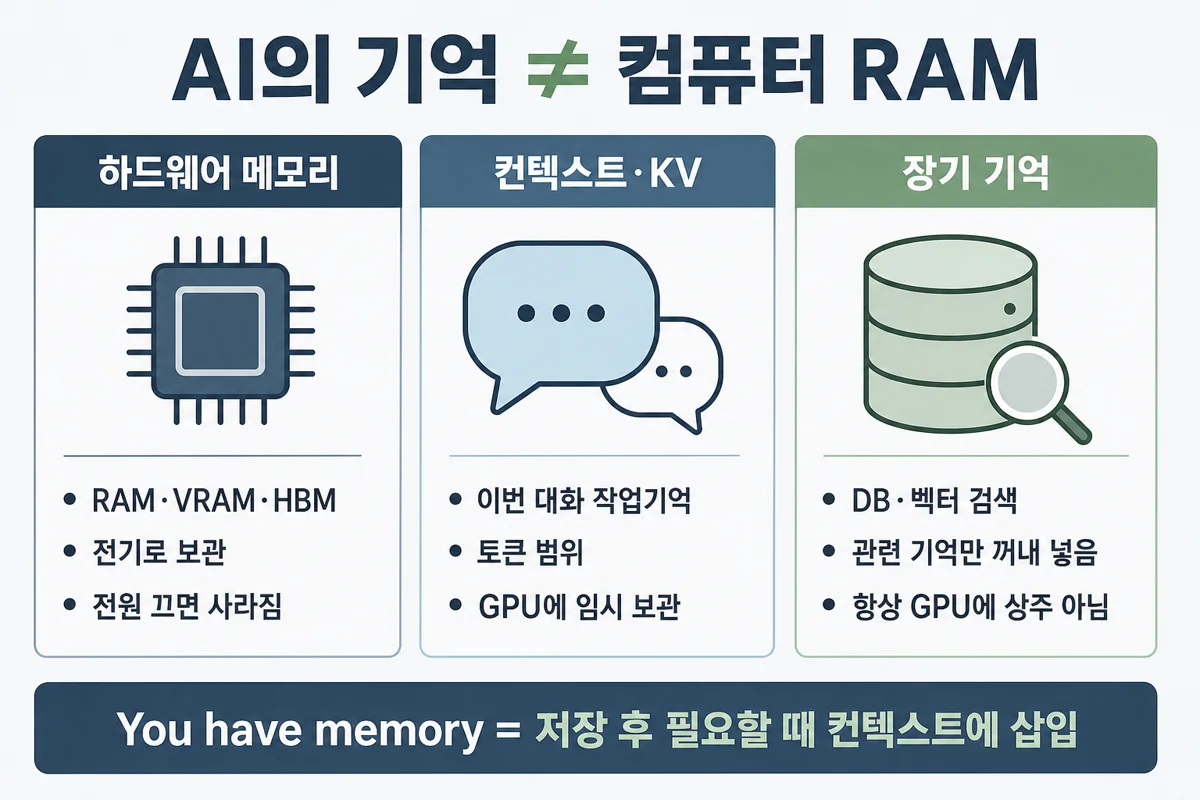 그림 6. 하드웨어 메모리 / 컨텍스트·KV / DB·벡터 장기 기억은 서로 다른 층이다
12. You have memory라는 말은 무엇을 의미하는가
ChatGPT 등에서 "메모리가 있다"는 보통 다음 흐름이다. 대화에서 유용한 정보를 식별 → 서버 저장 시스템에 보존 → 다음 대화에서 관련 정보를 검색 → 현재 컨텍스트에 삽입 → 모델이 참고해 답변. 사용자 정보가 항상 GPU RAM에 상주한다는 뜻이 아니다.
OpenAI Memory FAQ도 ChatGPT 메모리가 과거 대화·파일·연결 앱 등에서 유용한 맥락을 참조해 개인화에 쓰이며, 설정에서 관리·끌 수 있다고 설명한다.
에이전트 설계도 같은 원리가 안전하다. 모든 대화를 프롬프트에 계속 붙이지 말고, 중요 정보를 구조화해 저장하고, 최근만 단기 메모리로 유지하며, 오래된 것은 요약하고, 관련 기억만 컨텍스트에 넣는다. 기억을 많이 넣는다고 항상 좋은 것은 아니다. 무관한 기억이 많으면 비용·속도·신호 대 잡음·잘못된 기억·개인정보 위험이 커진다.
13. 에이전트 서버에서 메모리가 특히 많이 필요한 이유
에이전트 서버는 단순 웹 서버보다 살아 있는 상태가 많다. 사용자마다 대화·목표·계획·도구 이력·검색 결과·승인 대기·파일·생성 코드·브라우저 세션·로그·체크포인트·재시도 정보가 생길 수 있다. 대략 총 메모리 ≈ 기본 런타임 + 로드된 모델/인덱스 + 사용자당 상태 × 동시 사용자 수다.
메모리를 폭증시키는 실수 예시는 다음과 같다.
- 모든 대화를 프로세스 메모리에 계속 보관
- 도구의 큰 JSON을 그대로 누적
- PDF 원문 전체를 상태 객체에 저장
- 브라우저 에이전트 탭을 닫지 않음
- 비동기 작업을 무제한 동시 실행
- DB 결과를 한 번에 전부 읽음
- 요청·응답 전체를 로그에 여러 번 복사
- 웹소켓 세션을 정리하지 않음
- 임베딩 모델을 워커마다 중복 로드
- 캐시에 최대 크기·만료를 안 둠
CPU 작업은 요청이 끝나면 끝나지만, 세션·캐시·모델·인덱스는 다음 요청을 위해 남는 경우가 많다. 그래서 서버에서 CPU보다 메모리가 먼저 한계가 되는 장면을 자주 본다.
14. 메모리는 모든 산업의 씨앗인가
비유로는 꽤 맞다. 현대 산업은 현실 → 데이터화 → 메모리 적재 → 계산 → 판단 → 저장으로 흐른다. 자율주행의 센서·지도, 로봇의 환경 상태, 금융의 주문장·위험 모델, 바이오의 유전체·이미지, 제조의 센서·디지털 트윈, 통신의 라우팅·가입자 상태, 생성형 AI의 가중치·컨텍스트·KV가 모두 같은 패턴이다.
데이터가 있어도 계산할 장소(작업 메모리) 가 없으면 쓸 수 없다. 다만 메모리만으로 산업이 생기지는 않는다. CPU·GPU·NPU, 패키징, 네트워크, 스토리지, 전력·냉각, 소프트웨어, 데이터, 알고리즘이 함께 필요하다. 더 정확히 말하면, 메모리는 단독 씨앗이라기보다 계산·데이터·소프트웨어가 자랄 수 있게 하는 토양이다.
15. 16GB를 어떻게 판단하고 최적화할까
| 사용 패턴 | 현실적인 메모리 |
|---|---|
| API 중심, Docker 거의 없음, 작은 프로젝트, 탭 제한 | 16GB도 관리하며 가능 |
| Cursor + 브라우저 + 프론트/백 + Docker + DB·벡터 + 트레이싱 | 32GB가 체감 권장 |
| 로컬 LLM + 다중 컨테이너 + 대용량 문서·멀티 에이전트 | 64GB+ 의미가 큼 |
로컬 LLM(대략, 구조·컨텍스트에 따라 변동): 7B 4비트 약 5~8GB+, 14B 4비트 약 9~12GB+, 30B 4비트 약 20GB+, 70B 4비트 약 40GB+ — 여기에 KV·런타임·OS가 더해진다. Apple Silicon 통합 메모리는 로컬 AI에 유리할 수 있지만, OS·일반 앱이 같은 풀을 쓴다.
15.1. 당장 할 수 있는 최적화
개발 환경에서는 Docker 메모리 상한 확인, 안 쓰는 컨테이너 종료, 탭·확장 정리, 중복 개발 서버 종료, IDE 확장·MCP 자동 실행 축소, 워처·로그 보존량 제한, SSD 여유 확보가 효과적이다. 에이전트 설계에서는 대화 전체 RAM 보관 금지, 오래된 대화 요약 후 DB, 도구 결과는 필요 필드만, PDF는 청크 ID·경로만 상태 유지, 캐시 TTL·동시 실행 제한, 스트리밍·페이지네이션, 임베딩 중복 로드 방지가 핵심이다. 로컬 AI는 더 작은 모델·양자화·짧은 컨텍스트·작은 배치·일부 레이어만 오프로드하고, 로컬 추론과 무거운 Docker를 동시에 돌리지 않는 편이 낫다.
Windows는 작업 관리자에서 사용 가능 메모리·커밋·디스크·프로세스별 메모리·Hard Faults/sec·WSL(vmmem)을 본다. macOS는 Memory Pressure와 Swap Used가, Linux는 available·swap·major fault·OOM·컨테이너 RSS가 핵심이다.
16. 마무리
앞에서 다룬 AI 시대 메모리의 핵심만 짧게 정리한다.
- CPU·GPU는 계산기, 메모리는 지금 필요한 지식과 상태를 펼쳐 두는 작업대, 스토리지는 장기 기록실이다.
- SSD 스왑은 RAM 대체가 아니라 비상 공간이며, 스래싱이 끊김의 본체다.
- CPU 사용률은 "지금 일하는가", 메모리 사용률은 "무엇을 상주해 뒀는가"다. Available·스왑을 같이 보라.
- 16GB 멈춤은 로컬 모델 유무만이 아니라 IDE·브라우저·Docker·에이전트 상태의 동시 점유 문제인 경우가 많다.
- LLM은 가중치 + KV 캐시 + 활성값(+학습 시 optimizer)이 메모리를 먹고, 디코드는 대역폭 병목이 되기 쉽다.
- HBM은 용량만이 아니라 광대역 공급이고, AI 수요는 서버 DRAM·Enterprise SSD까지 끌어올린다. 삼성·하이닉스 부각은 그 구조의 결과다. 투자 권유는 아니다.
「계산기가 빨라도, 작업대가 좁으면 AI는 생각할 수 없다.」 — API만 쓰더라도 에이전트·개발 환경의 RAM을 설계하고, 로컬 모델·다중 컨테이너까지 가면 32~64GB를 현실적으로 검토하라. 수치·실적·주가 해석은 공식 자료와 최신 공시를 다시 확인하는 편이 안전하다.
자주 묻는 질문
- SSD가 빠른데 왜 RAM을 따로 써야 하나요?
SSD는 파일·큰 블록 영구 저장에 강하고, RAM은 작은 위치를 빈번히 읽고 쓰는 실행 작업에 강합니다. 지연시간과 랜덤 I/O 특성이 달라서, RAM 부족 시 SSD 스왑은 대체재가 아니라 비상 공간에 가깝습니다. 스왑이 늘면 디스크 thrashing으로 시스템이 끊깁니다.
- CPU 사용률은 낮은데 메모리만 높은 건 고장인가요?
항상 고장은 아닙니다. CPU는 순간 활동량이고 메모리는 모델·캐시·세션 같은 상주 점유라서, 쉬는 순간에도 70~80%가 나올 수 있습니다. Linux는 남는 RAM을 페이지 캐시로도 씁니다. Available이 바닥나고 스왑·끊김이 같이 오면 그때가 위험 신호입니다.
- 로컬 LLM을 안 깔았는데도 16GB가 멈추는 이유는?
원격 API를 써도 IDE, 브라우저, 언어 서버, Docker, DB, 에이전트 중간 상태·도구 결과가 노트북 RAM을 먹습니다. 에이전트는 한 요청 안에 여러 단계의 중간 결과를 유지하므로 일반 챗봇보다 로컬 점유가 큽니다. 스왑이 발생하면 체감 멈춤이 납니다.
- KV 캐시가 뭐고 왜 VRAM을 먹나요?
다음 토큰을 만들 때 이전 토큰과의 관계를 매번 처음부터 다시 계산하지 않도록, 각 층의 Key·Value 상태를 GPU 메모리에 보관하는 것이 KV 캐시입니다. 대화가 길고 동시 사용자·배치가 클수록 커집니다. 모델은 들어갔는데 긴 컨텍스트에서 OOM이 나는 흔한 원인입니다.
- HBM이 DDR보다 AI에 중요한 이유는?
HBM은 DRAM을 수직 적층해 GPU 옆에 붙이고 대역폭을 크게 키운 메모리입니다. AI 가속기는 코어가 많아 데이터 공급이 못 따라가면 코어가 기다립니다. 용량이 "무엇을 올릴까"라면 대역폭은 "얼마나 빨리 공급할까"를 결정합니다.
- ChatGPT의 You have memory는 RAM이 있다는 뜻인가요?
아닙니다. 보통은 유용한 정보를 서버 저장소에 두고, 다음 대화에서 관련 항목을 검색해 현재 컨텍스트에 넣는 구조입니다. 사용자 기억이 항상 GPU RAM에 상주한다는 의미가 아닙니다. 하드웨어 메모리와 에이전트 장기 기억은 다른 층입니다.
- 학습이 추론보다 메모리를 더 많이 쓰는 이유는?
추론은 주로 가중치와 KV·활성값이 중심이지만, 학습은 gradient와 optimizer state(예: Adam에서 대략 파라미터의 수 배)와 역전파용 activation을 더 보관합니다. 그래서 "가중치 14GB = 16GB GPU로 학습 가능"은 성립하지 않는 경우가 많습니다.
- 삼성·하이닉스 주가가 오른 건 AI 때문만인가요?
주가는 금리·환율·수급·실적 기대 등 여러 요인이 겹칩니다. 다만 AI 서버가 HBM·서버 DRAM·Enterprise SSD를 많이 쓰고, HBM은 진입장벽이 높으며, AI용 생산 배분이 일반 메모리 수급에도 영향을 주는 구조는 산업적으로 중요합니다. 이는 구조 설명이지 투자 권유가 아닙니다.
- 에이전트 개발에 메모리는 어느 정도가 적당한가요?
API 중심·가벼운 프로젝트는 16GB도 관리하며 가능하지만, Cursor·브라우저·Docker·DB·벡터·트레이싱을 같이 쓰면 32GB가 체감 권장선입니다. 로컬 LLM·다중 컨테이너·대용량 문서·멀티 에이전트까지면 64GB 이상이 안정적입니다. 모델 크기·컨텍스트·동시 프로세스에 따라 달라집니다.
- 디코드 단계가 메모리 대역폭에 막힌다는 말은?
Prefill은 큰 행렬을 한꺼번에 처리해 계산 장치 활용이 쉽지만, Decode는 토큰마다 가중치·KV를 반복 읽습니다. 계산량 대비 읽기 데이터가 많아 대역폭이 병목이 되기 쉽습니다. 그래서 양자화로 모델 크기를 줄이면 용량뿐 아니라 토큰 생성 속도에도 도움이 될 수 있습니다.