 크리에이터 팁
2026년 6월 19일, 약 2시간 14분 한국어 라이브 강의 MP3로 전사·자막을 뽑은 실험 기록이다.
한 줄 분기: SRT·전사 텍스트가 준비되면 유튜브 자막·숏폼 편집·위키·블로그·검색용 원고까지 같은 산출물로 이어진다. 도구 선택은 「무엇에 쓰느냐」가 아니라 「어떻게 뽑느냐」 — WhisperX(CPU/GPU·자동화) vs Vrew(GUI·장비·설정 부담↓). CPU 46분 실측, GPU ~3분(추정). 이 글은 STT 엔진 실측·비교다. 산출물은 하나: 타임코드 있는 SRT(또는 txt)만 확보되면 유튜브·숏폼·위키·블로그까지 같은 파일이 이어진다. 이후 FFmpeg·Remotion 컷은 영상 편집 자동화 | Vrew·Whisper·FFmpeg·Remotion 위키를 본다.
아래 선택표·결론을 먼저 보고, 근거·삽질기·로그는 뒤 장에서 펼친다.
1. 오늘 실험 타임라인
| 순서 | 방법 | 환경 | 결과 |
|---|---|---|---|
| 1 | Google Colab CLI + Whisper | Docker, T4 GPU, Colab 원격 | 업로드·실행까지 성공, 2시간+ 분량이라 속도·대기 부담으로 중단 |
| 2 | WhisperX 로컬 (1·2차) | Windows, CPU int8, medium, batch=4 | 1차 cp949 55% 크래시, 2차 PS stderr 7초 종료 |
| 3 | WhisperX 로컬 (3차) | 동일 + UTF-8·PS 수정 | 46분 완료 — SRT 614cue, 101KB (12:07:12) |
| 4 | Vrew | Windows GUI | 당일 실무 — GUI로 자막 마무리 (WhisperX SRT는 백업·비교용) |
대상 오디오:
| 파일 | 크기 | 길이 | 비고 |
|---|---|---|---|
| 원본 MP3 | 약 122MB | 2시간 14분 | 라이브 강의 전체 내보내기 (예: lecture.mp3) |
| 압축 MP3 | 약 31MB | 동일 | ffmpeg 16kHz mono 32k — Colab 업로드·WhisperX 공용 |
작업 폴더 정리 (권장):
PC마다 드라이브·루트는 다르다. 공개 글에는 절대 경로를 적지 않고, 아래처럼 역할별 폴더 이름만 맞추면 된다.
| 구분 | 권장 구조 (예시) |
|---|---|
| Colab CLI (Docker) | thirdparty/google-colab/ — Dockerfile, OAuth, 업로드 래퍼 |
| WhisperX (CPU venv) | thirdparty/whisper-x/ — venv, data/, output/, 실행 스크립트 |
| 입력 오디오 | data/lecture.mp3 (원본) · data/lecture_16k.mp3 (ffmpeg 압축본) |
| 전사 산출물 | output/lecture.{srt,txt,vtt,json} — 입력 basename과 동일 접두어 |
| 실행 로그 | output/transcribe-YYYYMMDD-HHmmss.log |
정리 원칙: 도구별 형제 폴더로 분리 · venv·입출력·로그는 한 프로젝트 루트 안에 모음 · 위키·블로그에 본인 PC 경로·실제 파일명 노출 금지.
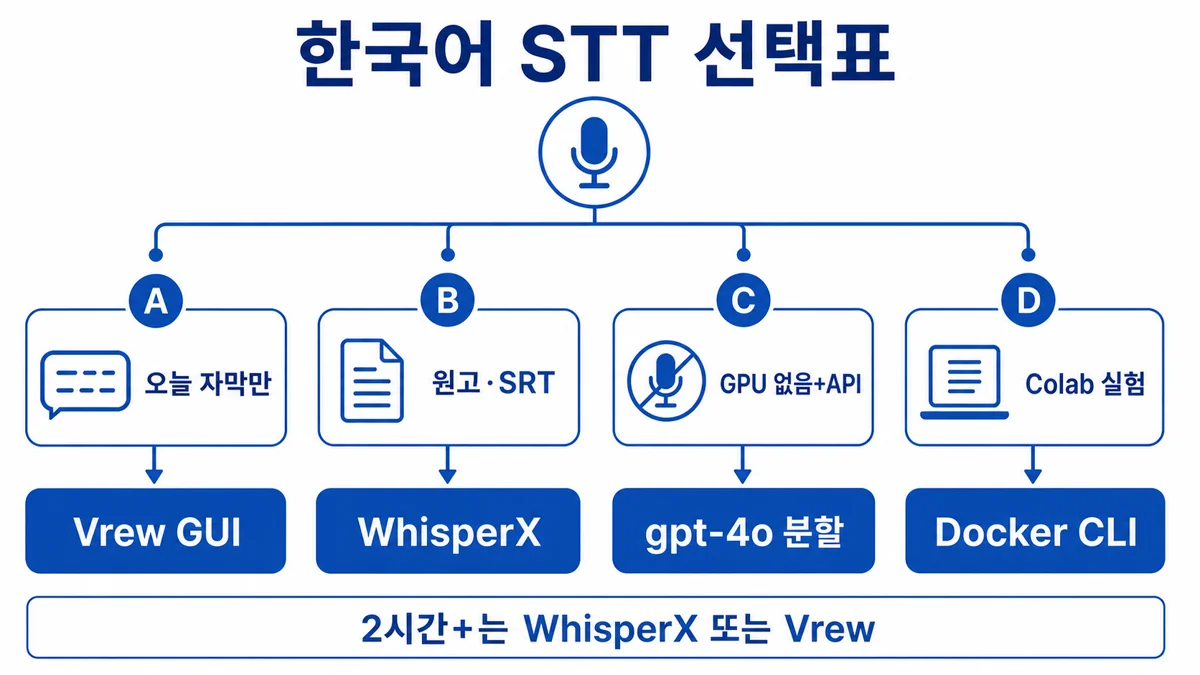 그림 1. SRT는 한 번 — 뽑는 도구만 WhisperX(자동화) vs Vrew(GUI)
2. 상황별 최종 선택표
검색으로 들어왔다면 여기부터. 아래 표로 도구를 고른 뒤, 뒤 장에서 실측·로그·품질 비교를 본다.
| 상황 | 추천 |
|---|---|
| GPU·CPU 여유 없음, venv·스크립트 싫음, 당일 GUI | Vrew (설치만 · GUI) |
| GPU 또는 CPU 배치 OK, 자동화·IT 용어 | WhisperX medium~large-v3, float16 / CPU int8 |
| 한국어, GPU 없음, 비용 1,000원 OK, 코딩 가능 | gpt-4o-transcribe + 분할·SRT 병합 스크립트 |
| 한국어 통화·잡음 많음, 상용 OK | 리턴제로 STT 검토 |
| 영어-only, 속도 최우선 | Parakeet / Canary (한국어 해당 없음) |
| Colab만 있음, Windows | Docker colab-cli (네이티브 CLI ❌) |
| CPU만, WhisperX 고집 | medium int8, alignment 시간 + UTF-8/PS 수정 필수 |
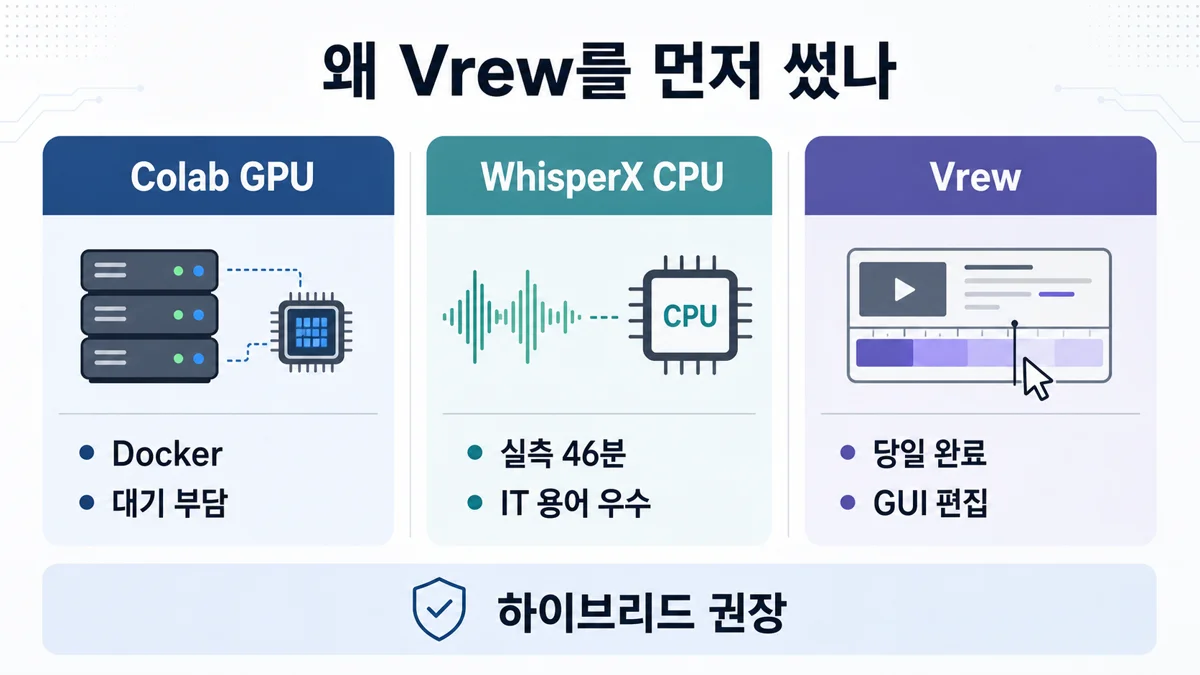 그림 2. 당일 GUI는 Vrew · 장비·품질·배치는 WhisperX
3. 결국 Vrew를 선택한 이유
| 기준 | Colab GPU | WhisperX CPU | Vrew |
|---|---|---|---|
| 설치 난이도 | Docker·OAuth·업로드 경로 | venv·ffmpeg·버그 2건 | 설치만 |
| 2시간 14분 | T4로 가능하나 대기·세션 관리 부담 | 실측 46분 (전사 26분 + alignment 19분) | GUI로 당일 완료 |
| 전사 텍스트 품질 | Whisper 계열과 동급 | IT·영문 혼용 강의에서 우수 (Next.js 11 vs 0) | 구어 OK · 고유명·코드 약함 (GUI 편집은 쉬움) |
| 자동화 | 스크립트화 가능 | PowerShell 전사 스크립트 | SRT 내보내기 후 FFmpeg 파이프라인 |
당일 GUI로 먼저 SRT를 만들려고 Vrew를 썼다. 같은 SRT·txt는 유튜브·숏폼·위키·블로그에 공통으로 쓸 수 있다. IT·영문 혼용 품질 grep·등급표는 「CPU WhisperX vs Vrew」 장에 모았고, 백업·재전사용으로 WhisperX CPU 46분도 돌렸다.
장기적으로는:
| 역할 | 도구 |
|---|---|
| PC·GPU 부담 없이 GUI만 | Vrew → SRT 공통 |
| CPU/GPU·스크립트·배치·IT 용어 | WhisperX (float16 / CPU int8) |
| GPU 없고 API OK | gpt-4o-transcribe 분할 스크립트 |
| Colab GPU | Docker colab-cli + colab run --gpu T4 (짧은 파일·실험용) |
4. 한국어 STT, 2025~2026년 판도
「Whisper가 최신·최선인가?」에 대한 답은 언어에 따라 갈린다.
4.1. 영어권에서는 왕좌가 흔들렸다
| 계열 | 특징 | 한국어 자막 |
|---|---|---|
| NVIDIA Parakeet / Canary | 영어 벤치마크에서 Whisper-large-v3를 앞서는 경우 많음, 속도도 빠름 | (2026-06 기준) Parakeet v3는 유럽어 중심 25개 언어. 한·중·일·아랍·힌디 미지원 — 업데이트 시 재확인 |
| Canary-Qwen-2.5b | 정확도·속도 우수 | 영어 전용 |
| Deepgram Nova-3, AssemblyAI | 상용 API, 실무 강세 | 한국어 지원은 하나 도메인별 편차 |
「Whisper를 이겼다」는 헤드라인 대부분이 CJK(한·중·일)를 빼고 영어·유럽어에 최적화된 모델이다.
4.2. 한국어 자막 목적이라면
| 우선순위 | 도구 | 이유 |
|---|---|---|
| 1 | WhisperX | faster-whisper 속도 + 단어 단위 alignment + (선택) 화자 분리. SRT 타이밍이 실무에 맞음 |
| 2 | faster-whisper / Faster-Whisper-XXL | 화자 분리 없이 빠른 전사만 필요할 때 |
| 3 | OpenAI gpt-4o-transcribe API | 정확도 좋음, GPU 불필요. 다만 25분·25MB 제한 → 분할·병합 직접 구현 |
| 4 | 리턴제로(RTZR) STT | 한국어 통화·회화체 특화 상용 API. Whisper보다 CER이 좋은 편이 보고됨 |
| 5 | Vrew | 코딩 제로, GUI로 SRT까지. 자동화 파이프라인은 약하지만 당일 끝내기에 강함 |
한 줄로: 한국어 2시간 강의 자막 = Whisper 계열(특히 WhisperX)이 여전히 오픈소스 1순위. 다만 GPU 없이 CPU만이면 2시간은 「돌아가긴 하는데 기다리기 힘든」 구간이다.
5. Whisper / faster-whisper / WhisperX 차이
| 이름 | 역할 |
|---|---|
| OpenAI Whisper | 원조. 정확하지만 느림 |
| faster-whisper | CTranslate2 기반. 같은 모델 대비 약 4배 빠르고 메모리 적게 씀. 사실상 CLI 표준 |
| WhisperX | faster-whisper + VAD + wav2vec2 forced alignment + (선택) pyannote 화자 분리. 자막용 |
WhisperX 공식 README 기준 GPU large-v2에서 약 70배 실시간 속도를 내세운다. 이 수치는 GPU + 배치 추론 기준이며 CPU int8 medium에서는 체감이 완전히 다르다.
WhisperX 파이프라인은 크게 세 단계다.
- Transcription — faster-whisper로 구간별 텍스트 생성. 콘솔에
Transcript: [시작 --> 끝] 문장형태로 출력 - Alignment — 한국어는 Hugging Face의
kresnik/wav2vec2-large-xlsr-korean등 phoneme 모델로 단어 단위 타임스탬프 재정렬 - 저장 — alignment가 끝나야
.srt/.txt/.vtt가output_dir에 기록됨
Transcript 줄이 멈췄다고 끝난 게 아니다. Performing alignment... 이후에도 CPU에서는 15~40분 더 걸릴 수 있고, 이 구간은 콘솔 출력이 거의 없어 멈춘 것처럼 보인다.
6. Google Colab CLI (요약)
공식 google-colab-cli는 Linux·macOS만 지원한다. Windows 네이티브는 termios 등으로 실패하고 Docker + PowerShell 래퍼가 필요하다.
| 항목 | 이번 실험 결과 |
|---|---|
| 환경 | Docker, T4 GPU, 압축 MP3(~31MB) 업로드 성공 |
| 중단 이유 | 2시간 14분 분량 — 전사 대기·세션 관리 부담 |
| Windows 함정 | stdin 파이프 래퍼, UTF-8 BOM, Colab 컨테이너 /work 경로, 90MB 업로드 한계 |
Colab CLI 설치·PowerShell 함정·명령표 전체는 별도 글로 분리 예정이다. 이 글은 STT 엔진 비교에 집중하고 Colab은 「짧은 파일·실험용, 장시간은 비현실적」만 남긴다.
7. 로컬 WhisperX (CPU) 설치·실행
| 스크립트 역할 | 내용 |
|---|---|
| 설치 스크립트 | uv venv + PyTorch CPU wheel + whisperx |
| 전사 스크립트 (PowerShell) | --device cpu --computetype int8 --model medium --language ko --batchsize 4 |
실행 예:
. ranscribe.ps1 -InputAudio "data\input_whisper.mp3"
7.1. 1차 실행 실패 — cp949 UnicodeEncodeError
약 18분 후, 오디오 ~55%(~74분) 지점에서 크래시.
| 항목 | 내용 |
|---|---|
| 원인 | whisperx가 print()로 한글·특수문자 출력 시 Windows 콘솔 cp949 인코딩 한계 |
| 증상 | UnicodeEncodeError: 'cp949' codec can't encode character |
| 결과 | output/에 SRT 없음 |
수정 (전사 PowerShell 스크립트):
| 설정 | 값 |
|---|---|
PYTHONUTF8 | 1 |
PYTHONIOENCODING | utf-8:replace |
[Console]::OutputEncoding | UTF8 |
| 로그 | Tee-Object → output/transcribe-YYYYMMDD-HHmmss.log |
7.2. 2차 실행 실패 — PowerShell stderr
pyannote UserWarning(torchcodec)이 stderr로 나오자 PowerShell이 NativeCommandError로 즉시 종료 ($ErrorActionPreference = Stop).
수정: whisperx 호출 구간만 $ErrorActionPreference = "Continue" + *>&1 | Tee-Object.
7.3. torchcodec / HuggingFace 경고 (치명 아님)
시작 시 아래 경고가 빨간 글씨로 보여도 대부분 멈춤 원인 아님.
| 경고 | 의미 |
|---|---|
| torchcodec DLL 로드 실패 | pyannote가 torchcodec으로 디코딩 시도 → Windows venv에서 native DLL 실패 |
| HuggingFace symlink | Windows Developer Mode 없으면 symlink 대신 복사 → 디스크 더 씀 |
| hf_xet 미설치 | HTTP 폴백. 속도만 약간 느림 |
WhisperX 본체는 ffmpeg CLI subprocess로 MP3를 읽는다 (whisperx/audio.py의 load_audio). PATH에 ffmpeg만 있으면 전사는 진행된다.
7.4. 3차 실행 — 성공 (전사 + alignment + SRT)
| 시각 | 이벤트 |
|---|---|
| 11:21:31 | 전사 스크립트 Start |
| 11:47:49 | 마지막 Transcript + Performing alignment... |
| 12:07:11 | lecture.srt 등 5종 파일 기록 |
| 12:07:12 | End · Done · exit 0 |
중간에 alignment 구간만 보면 멈춘 것처럼 보였으나, 19분 23초 후 SRT 생성 완료. 당시 터미널을 닫거나 프로세스를 끊으면 SRT 없이 끝난다.
alignment만 생략하려면 CLI에 --noalign (단어 단위 타임스탬프·highlightwords 불가).
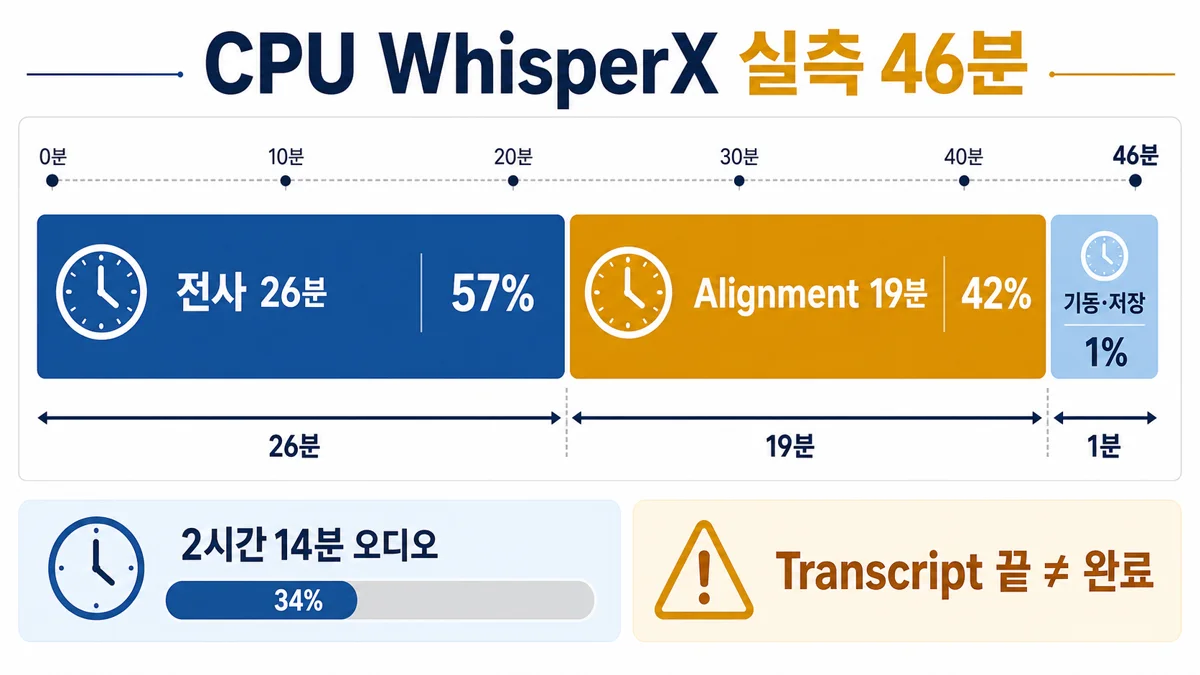 그림 3. alignment 구간은 콘솔 거의 무출력 — 멈춘 것처럼 보임
8. CPU WhisperX 실측 — 오디오 길이 vs 전사 시간
ffprobe로 측정한 압축 MP3(lecture_16k.mp3) 실제 길이: 8038.861초 = 2시간 13분 59초(약 2시간 14분).
WhisperX 3차 성공 실행 (2026-06-19, 전사 PowerShell 스크립트, medium · ko · CPU int8 · batch=4):
| 구분 | 시각 / 값 |
|---|---|
| 전사 스크립트 Start | 11:21:31 |
| VAD 시작 (로그) | 11:21:39 |
| Performing transcription | 11:21:43 |
| 마지막 Transcript 타임코드 | 8027.401 ~ 8029.021초 |
| Performing alignment | 11:47:49 |
| 전사 스크립트 End · Done | 12:07:12 |
| 총 wall-clock | 45분 41초 |
| exit code | 0 |
8.1. 단계별 소요 (wall-clock)
| 단계 | 소요 | 전체 대비 | 비고 |
|---|---|---|---|
| 기동 + VAD + 모델 로드 | ~12초 | 0.4% | 11:21:31 → 11:21:43 |
| Transcription (전사) | 26분 6초 | 57% | 콘솔에 Transcript 줄이 계속 출력 |
| Alignment (정렬) | 19분 23초 | 42% | 콘솔 거의 무출력 — 멈춘 것처럼 보임 |
| SRT/JSON 저장 | ~2초 | — | 12:07:11 일괄 기록 |
8.2. 실시간 배속 (RTF, Real-Time Factor)
「Nx 실시간」= 벽시계 1분에 N분 분량의 오디오를 처리한다는 뜻으로 본다.
| 구간 | 계산 | RTF |
|---|---|---|
| 전체 (전사+정렬+저장) | 8039초 ÷ 2741초 | 약 2.9× |
| Transcription만 | 8039초 ÷ 1566초 | 약 5.1× |
| Alignment만 | 8039초 ÷ 1163초 | 약 6.9× (워크로드 특성상 직접 비교는 부정확) |
해석: CPU medium int8 batch=4 기준 2시간 14분 오디오 → 약 46분이면 끝난다. GPU README의 「70× 실시간」과는 20배 이상 차이 난다.
8.3. 1차 실패 실행 (cp949, 수정 전)
| 항목 | 값 |
|---|---|
| Start | 10:49:59 |
| End (크래시) | 11:07:52 |
| wall-clock | 17분 53초 |
| 마지막 Transcript | ~4450초 (~74분, 오디오 55%) |
| exit code | 1 |
| 원인 | UnicodeEncodeError (cp949) |
수정 전에도 전사 속도는 대략 5× 전후였으나, 55% 지점에서 한글 출력 때문에 중단.
8.4. 2차 실패 (PowerShell stderr)
| 항목 | 값 |
|---|---|
| wall-clock | 약 7초 |
| 원인 | pyannote UserWarning → NativeCommandError + Stop |
8.5. CPU만 쓸 때 길이별 대략 예상 (medium int8 batch=4, alignment 포함)
| 오디오 길이 | 예상 wall-clock (2.9× RTF) |
|---|---|
| 30분 | ~10분 |
| 1시간 | ~21분 |
| 2시간 14분 | ~46분 (실측) |
| 3시간 | ~62분 |
--no_align이면 alignment 19분을 줄일 수 있어 총 ~27분까지 가능(타임스탬프 정밀도↓).
9. 로그 파일 특징과 읽는 법
로그 예: output/transcribe-YYYYMMDD-HHmmss.log (실행마다 새 파일)
9.1. 전사 스크립트이 남기는 것
| 출력 | 위치 |
|---|---|
| Start / End / Done | PowerShell 콘솔 + 터미널 캡처 |
| whisperx 전체 stdout·stderr | Tee-Object → .log 파일 |
9.2. 로그 안에서 단계 구분 (grep 키워드)
| 로그 줄 | 의미 |
|---|---|
Performing voice activity detection using Pyannote... | VAD 시작 |
Performing transcription... | 전사 시작 — 이후 Transcript 줄 출력 |
Transcript: [시작 --> 끝] 텍스트 | 구간별 인식 결과 (270줄 / 이번 실행) |
Performing alignment... | 전사 끝, 정렬 시작 — Transcript 더 이상 없음 |
| (alignment 중) | 거의 무출력 — 19분 가까이 조용함 |
| SRT 생성 | 로그에 별도 메시지 없음 — End/Done + .srt 파일로 확인 |
9.3. 로그 맨 앞에 붙는 PowerShell 잡음
| 패턴 | 성격 |
|---|---|
whisperx.exe : ... UserWarning | pyannote/torchcodec — 경고 |
CategoryInfo : NativeCommandError | PS가 stderr를 에러 레코드로 표시 — Continue 설정 시 무시하고 진행 |
| torchcodec libtorchcodec_core4~7.dll | Windows venv DLL 미로드 — WhisperX ffmpeg 경로는 별도 |
9.4. alignment 직전 HuggingFace 경고
| 경고 | 영향 |
|---|---|
| symlink not supported | kresnik--wav2vec2-large-xlsr-korean 캐시가 복사 방식 → 디스크만 더 씀 |
| hf_xet not installed | HTTP 다운로드 폴백 → 최초 1회만 느림 |
9.5. 완료 판정 체크리스트
- 콘솔
End : ...+Done. Check ... for .srt - output/lecture.srt LastWriteTime이 alignment 시작 시각 이후
- SRT 마지막 타임코드 ≈ 오디오 길이 (이번: 02:13:49)
10. 최종 산출물 (SRT) 스펙
3차 성공 후 output/ 예시:
| 파일 | 크기 | 설명 |
|---|---|---|
lecture.srt | 101,431 bytes | 자막 본체 — 614개 cue |
lecture.txt | 78,207 bytes | 순수 텍스트 |
lecture.vtt | 96,760 bytes | WebVTT |
lecture.tsv | 87,828 bytes | 탭 구분 |
lecture.json | 1,416,276 bytes | 세그먼트·단어 타임스탬프 JSON |
transcribe-YYYYMMDD-HHmmss.log | (실행마다) | 전사 Transcript 270줄 (alignment 이후 갱신 없음) |
SRT 마지막 블록:
| cue | 시간 | 텍스트 |
|---|---|---|
| 614 | 02:13:47,482 → 02:13:49,021 | 끌게요 꼭 해봐요 |
WhisperX alignment까지 완료된 정상 산출물이다. (당일 Vrew로도 작업했으나, WhisperX SRT는 비교·백업·자동화 입력용으로 보관)
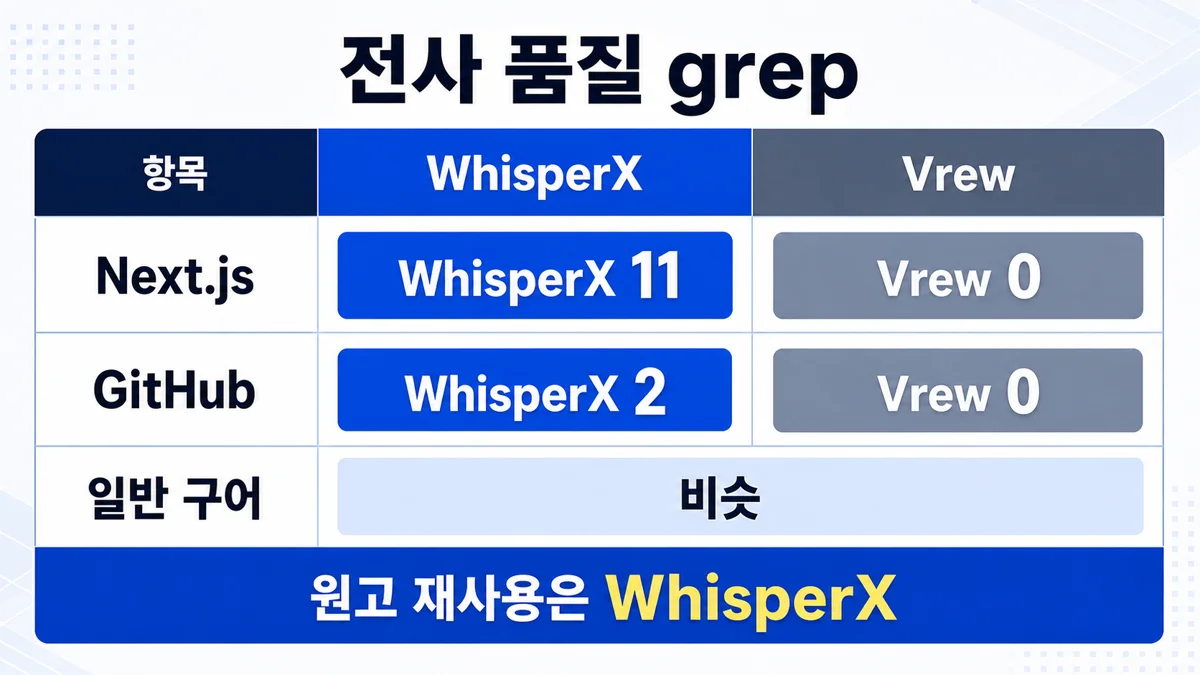 그림 4. IT 키워드 grep — WhisperX 우세, 구어는 비슷
11. CPU WhisperX vs Vrew — 같은 영상, 전사 품질 비교
같은 2시간 14분 라이브 강의(바이브 코딩·Vercel 배포)를 두 엔진으로 전사한 뒤, 텍스트만 나란히 펼쳐 비교했다. 속도·GUI는 Vrew, 받아쓰기·IT 용어 정확도는 WhisperX 쪽이 확실히 앞선다. 차이가 「조금」 수준이 아니라, 개발 강의를 위키·블로그 원고로 쓸 때는 Vrew만으로는 손이 많이 간다고 보는 편이 맞다.
11.1. 비교 파일 (동일 소스)
| 구분 | 경로 | 형식 |
|---|---|---|
| WhisperX | 003_whisper-x/output/lecture.txt | medium · ko · CPU int8 · alignment 완료 후 plain text |
| Vrew | 010_큐레-라이브-웹사이트-20260618-초안.txt | Vrew 영상 편집기 내장 음성 인식 내보내기 (타임코드 + 문장) |
| 지표 | WhisperX txt | Vrew 초안 |
|---|---|---|
| 분량 | 615줄 (문단형) | 2,123 cue (초 단위 잘림) |
| 문자 수 | 약 33,000자 | 약 53,000자 (타임코드 포함) |
| SRT | lecture.srt 614cue | Vrew GUI에서 별도 SRT 내보내기 |
Vrew는 짧은 cue로 잘게 쪼개져 자막 타이밍 편집에는 유리하지만, 한 덩어리 원고로 읽거나 검색·치환할 때는 WhisperX 쪽이 낫다.
11.2. 고유명·기술 용어 — grep 실측 (같은 MP3)
전체 텍스트에서 패턴 출현 횟수를 세었다. 영문 고유명·프레임워크명에서 격차가 가장 크다.
| 패턴 | WhisperX | Vrew | 해석 |
|---|---|---|---|
Next.js (정확 표기) | 11 | 0 | Vrew는 전부 「넥스트제이에스」 음성 표기 |
넥스트제이에스 (음성 표기) | 0 | 10 | 문서·검색·치환 불리 |
GitHub (정확) | 2 | 0 | Vrew는 기톱·깃헙·기탑 등 |
SQLite (정확) | 7 | 3 | Vrew는 sql 라이트 혼재 |
npm run dev | 0 | 1 | WhisperX는 npm run 대부(deploy 오인) |
localhost 정확 | 0 | 0 | 둘 다 실패 — 아래 표 참고 |
버셀 / Vercel | 29 | 30 | 비슷 |
| 버스·버스에·버스엘 (Vercel 오인) | 5 | 7 | Vrew가 「버스」 계열 더 많음 |
터소 (Turso) | 7 | 6 | 비슷 (둘 다 Turso 영문 0) |
요약: 일반 구어(「여러분」「배포」「회원가입」)는 비슷한데, Next.js·GitHub·SQLite·npm·localhost 같은 강의 핵심 키워드에서 Vrew가 구조적으로 밀린다.
11.3. 같은 구간 — 오프닝 2분대 (실제 전사)
| 실제 발화(의도) | WhisperX | Vrew |
|---|---|---|
| npm run dev | npm run 대부 | npm run dev ✅ (Vrew만 맞춤) |
| 보안 오류 | 보안 오류 ✅ | 번 오류 |
| 서비스 센터 | 서비스 센터 ✅ | 서울센터 |
| localhost:3000 | 로코로스트 3000 | 로컬어스트 / 로커로스트 3000 |
| Next.js | Next.js ✅ | 넥스트제이에스 |
| GitHub 가입 | 기턱 / 기텁 | 기톱 / 깃헙 |
| 이메일 공개 | 미멜 (둘 다 오인) | 미멜 |
WhisperX도 localhost·Kimi→「킴이」·이미지 모델→「나노바나나」처럼 틀리는 구간은 있다. 다만 Next.js·SQLite·React·PowerShell 등은 WhisperX가 영문 그대로 남기는 비율이 높고, Vrew는 한글 음역으로 굳어져 Ctrl+F·용어 사전 교정이 어렵다.
11.4. Vrew 내장 STT가 특히 약한 패턴
| 유형 | Vrew 예 | 문제 |
|---|---|---|
| 영문 제품명 | 버스에, 버스엘 | Vercel 맥락인데 「버스」로 고정 |
| 프레임워크 | 넥스트제이에스, sql 라이트 | 공식 표기·SEO·링크 불가 |
| DevTools | 깃헙, 기톱, MT 프로젝트 | GitHub, Empty project 오인 |
| 동음이의 | 서울센터, 번 오류 | 서비스센터, 보안 오류 |
| AI·모델명 | 킴이, QMA, 컴퍼저 | Kimi, Claude/Qwen 계열, Composer |
라이브 구어·감탄·반복은 둘 다 잘 잡는다. 차이는 「고유명사 + 코드 + 영어 혼용」 구간에서만 벌어지는데, 이번 강의는 그 비율이 높다.
11.5. WhisperX(medium)도 틀리는 것 — 공정 비교
| WhisperX 오인 | 비고 |
|---|---|
| 로코로스트 3000 | localhost — Vrew와 동급 실패 |
| npm run 대부 | deploy/dev 혼동 |
| 기턱·기탑·기텁 | GitHub 음성 표기 (가끔 GitHub 정확) |
| 킴이, 나노바나나 | Kimi, Gemini 이미지 모델 등 |
| 「요거」 연속 반복 | 드물게 짧은 환각 반복 (한 줄) |
WhisperX는 Whisper medium + wav2vec2 alignment라 SRT 타임스탬프·문장 경계까지 맞춘 뒤 txt를 뽑았고, Vrew는 편집기 실시간 인식에 가깝다. 엔진·후처리·모델 크기가 다르므로 공정 비교는 「같은 MP3 · 같은 날 · 같은 화자」 조건에서만 의미 있다.
11.6. 체감 등급 (이번 파일 기준, 주관 + 실측)
| 항목 | WhisperX CPU medium | Vrew 내장 STT |
|---|---|---|
| 일반 한국어 구어 | ★★★★ | ★★★★ |
| IT·영문 혼용 강의 | ★★★★ | ★★ |
| 위키/블로그 원고 재사용 | ★★★★ | ★★ |
| 당일 자막·GUI 편집 | ★★ | ★★★★★ |
| SRT 타임코드 (alignment) | ★★★★★ | ★★★★ |
「품질 차이가 매우 크다」 — IT 키워드·검색·치환 기준으로 과장이 아니다. Vrew SRT만으로도 유튜브·숏폼·위키·블로그는 가능하지만, IT·영문 혼용 강의는 WhisperX(또는 GPU/API)로 뽑거나 Vrew SRT를 grep·수동 교정하는 편이 낫다.
11.7. 권장 워크플로 (하이브리드)
| 목적 | 추천 |
|---|---|
| SRT·txt 뽑기 — 장비·자동화 OK | WhisperX (CPU/GPU) |
| SRT·txt 뽑기 — GUI·설정 부담↓ | Vrew |
| 뽑은 SRT로 유튜브·숏폼·위키·블로그 | 동일 파일 → 영상 편집 자동화 위키 |
| IT 용어·grep 품질 중요 | WhisperX 우선, 또는 Vrew SRT 수동 교정 |
| 품질·속도 최우선 | GPU WhisperX large-v3 또는 gpt-4o-transcribe |
하이브리드·당일 선택은 앞장 「결국 Vrew를 선택한 이유」·「상황별 최종 선택표」 참고.
12. WhisperX CPU 속도 개선 팁
12.1. 즉시 효과 (설정)
| 팁 | 효과 | 트레이드오프 |
|---|---|---|
--no_align | alignment ~19분 절약 | 단어 단위 타임스탬프·highlight_words 불가 |
-Model small 또는 base | 전사 구간 2~4배 빨라질 수 있음 | 한국어 오인식↑ |
--batch_size 8 (RAM 여유 시) | GPU/고사양 CPU에서 처리량↑ | 8GB 미만 RAM에서 OOM 위험 |
--diarize 끄기 (기본) | pyannote 추가 부하 없음 | 화자 분리 없음 |
12.2. 환경·인프라
| 팁 | 설명 |
|---|---|
| GPU + float16 + batch 16 | → 「GPU가 있다면」 장(추정치) |
Colab colab run --gpu T4 | Windows는 Docker colab-cli. 짧은 파일·실험용 |
| gpt-4o-transcribe API | wall-clock 사람 대기 거의 없음(API latency). 비용 ~1,000원/2h. 분할 스크립트 필요 |
| Vrew | GUI, 당일 완주. 자동화 파이프라인은 약함 |
12.3. Windows CPU 안정화 (속도 = 중단 없이 끝까지)
| 필수 | 이유 |
|---|---|
PYTHONUTF8=1 | cp949 크래시 방지 — 55%에서 죽으면 속도 0 |
ErrorActionPreference Continue (whisperx 구간) | 7초 만에 stderr로 종료 방지 |
| ffmpeg PATH | torchcodec 실패해도 디코딩 유지 |
Tee-Object 로그 | alignment 무출력 구간 진행 중 증거 |
12.4. ffmpeg 입력 최적화
| 항목 | 권장 |
|---|---|
| 샘플레이트 | WhisperX 내부 16kHz — 미리 16kHz mono로 압축하면 디코딩 부담↓ |
| 비트레이트 | 32k~64k mono (이번 31MB / 2h14m) |
| Colab 업로드 | 90MB 이하 |
12.5. CPU 코어 활용
PyTorch CPU wheel은 멀티스레드를 쓰지만 batch=4에서는 GPU만큼 체감이 크지 않다. 물리 코어 많을수록 medium/large CPU 전사에 유리. alignment(wav2vec2)도 CPU bound.
12.6. 「느린데 멈춘 건가?」 구분법
| 상태 | CPU | 디스크 | 로그 |
|---|---|---|---|
| Transcription 중 | 높음 | 낮음 | Transcript 줄 증가 |
| Alignment 중 | 중~높음 | 간헐 | Performing alignment... 이후 정적 |
| 크래시 | 0 | 0 | End 없음 · exit ≠ 0 |
| 완료 | 0 | SRT 타임스탬프 갱신 | Done + .srt |
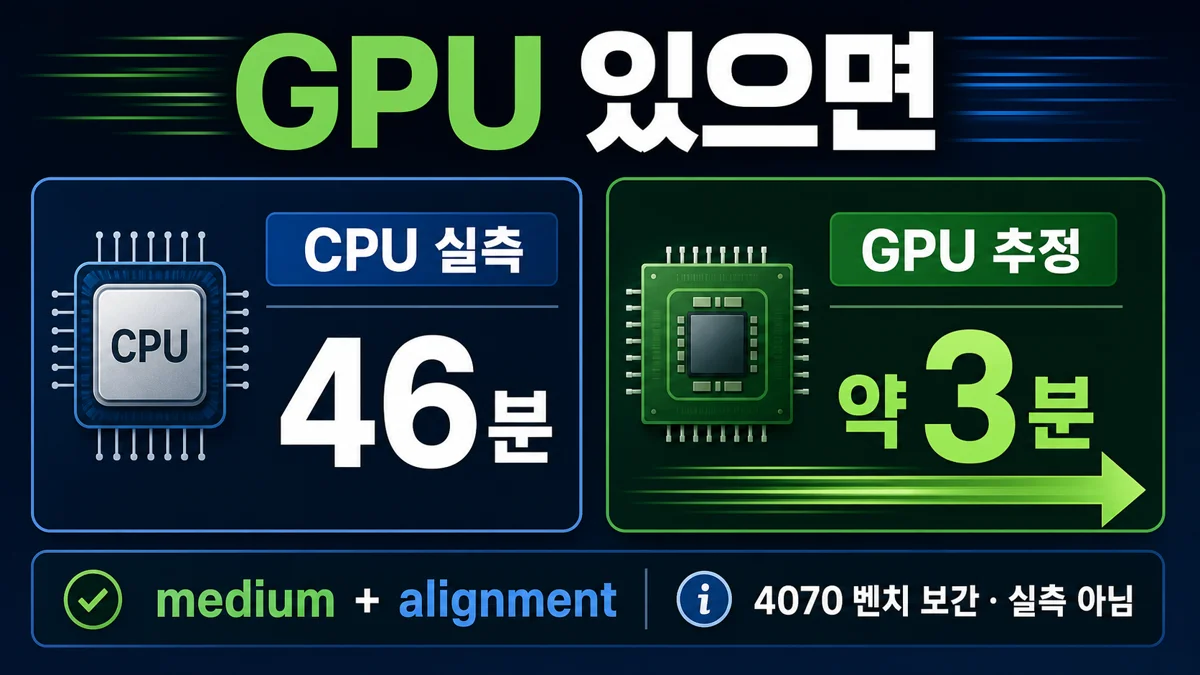 그림 5. GPU 시간은 4070 벤치 추정(2026-06, 실측 아님)
13. GPU가 있다면 — RTX 5060 Ti ~ 5080
같은 2시간 14분(134분) + medium + alignment 기준 추정치(2026-06, 실측 아님) — RTX 4070 FP16 벤치(전사 ~50×, alignment 포함 ~40×)에서 5070·5080 등을 보간한 값이다.
| GPU | VRAM | 추정 총 시간 | CPU(실측 46분) 대비 |
|---|---|---|---|
| RTX 5060 Ti 8GB | 8GB | 약 4~5분 | ~10배 |
| RTX 5060 Ti 16GB | 16GB | 약 3~4분 | ~12배 |
| RTX 5070 | 12GB | 약 2.5~3.5분 | ~15배 |
| RTX 5070 Ti | 16GB | 약 2~2.5분 | ~18배 |
| RTX 5080 | 16GB | 약 2~2.5분 | ~20배 |
GPU WhisperX 권장 옵션:
| 옵션 | 값 |
|---|---|
--device | cuda |
--compute_type | float16 |
--batch_size | 16 (12GB+) / 8 (8GB) |
WhisperX만 목적이면 5070이 가성비 스위트스pot. 5070 Ti vs 5080 차이는 자막 작업에서 1분 미만일 때가 많다.
참고: WhisperX GitHub · OpenRouter gpt-4o-transcribe
2026년 6월 기준 요율·제한. OpenRouter·OpenAI 정책은 수시 변경 — 배포 전 공식 문서 재확인.
14. gpt-4o-transcribe API (OpenRouter)
OpenRouter gpt-4o-transcribe 표시 가격:
| 구분 | 요율 |
|---|---|
| 입력(오디오) | $2.50 / 100만 토큰 |
| 출력(텍스트) | $10.00 / 100만 토큰 |
14.1. 2시간 한국어 비용 추정
| 기준 | 계산 | 결과 |
|---|---|---|
| OpenAI 공식 분당 | 120분 × $0.006 | 약 $0.72 (≈1,000원) |
| 토큰 환산 (출력 1.5만 토큰 가정) | 입력 거의 0 + 출력 | 약 $0.15~0.25 |
현실적으로 2시간 1건 1,000원 안팎, 넉넉히 2,000원 이하.
| 길이 | 추정 비용 |
|---|---|
| 25분 | 약 200~400원 (한 번 호출 제한에 걸리기 쉬움) |
| 2시간 | 약 1,000원 (분할 호출 합산) |
14.2. API로 2시간 처리할 때 파이프라인
GPU 없이 API만 쓸 때 직접 구현해야 하는 로직:
- ffmpeg — mp4 → mp3, 용량 줄이기
- 분할 — gpt-4o-transcribe 약 25분 / 25MB 제한 (2026-06 OpenAI·OpenRouter 정책, 변경 가능). 무음 구간·overlap으로 경계 단어 누락 방지
- 토막별 API 호출 — 각 chunk transcription
- 오프셋 보정 — 2번째 토막 타임스탬프에 +25분(누적) 더하기
- 병합·중복 제거 — overlap 구간 dedupe
- SRT 생성 — 세그먼트 → SRT 포맷
WhisperX는 2시간 통짜를 넣으면 VAD·배치·alignment·저장까지 한 번에 처리한다. API는 분할·오프셋·병합을 직접 짜야 하고, gpt-4o-transcribe는 whisperX만큼 세밀한 단어 타임스탬프를 주지 않는 경우가 있다.
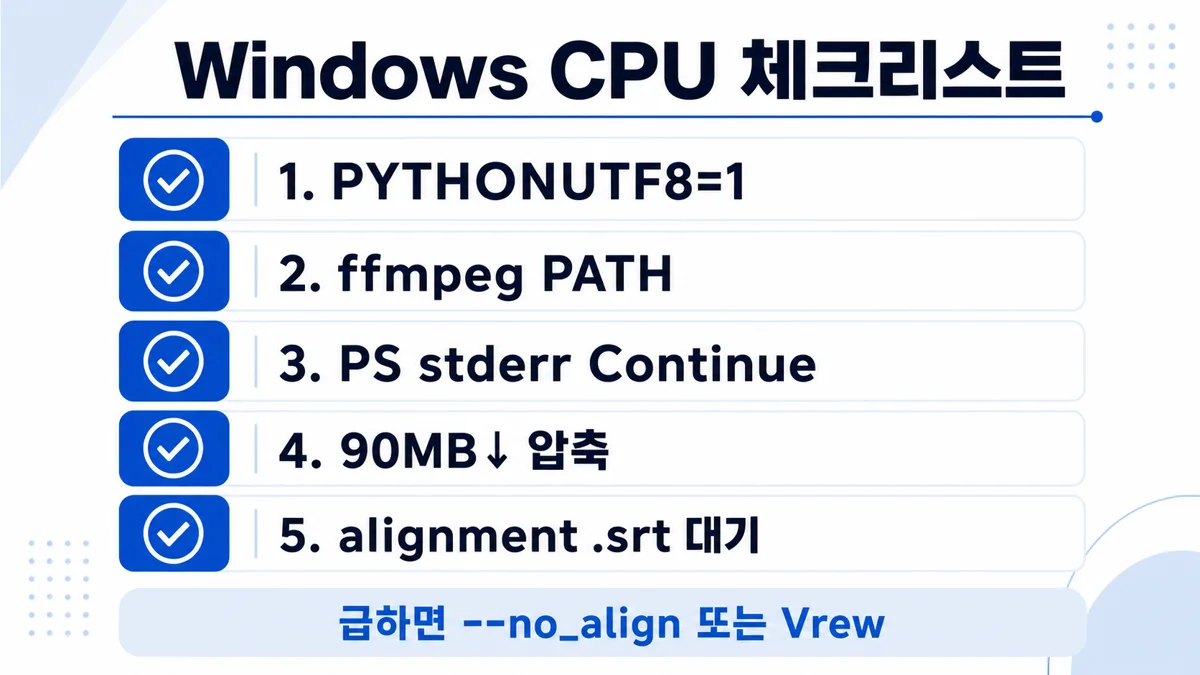 그림 6. cp949·stderr 함정 피하고 alignment까지 대기
15. 실전 체크리스트 (WhisperX Windows CPU)
| # | 확인 |
|---|---|
| 1 | ffmpeg PATH |
| 2 | PYTHONUTF8=1, PYTHONIOENCODING=utf-8:replace |
| 3 | PowerShell stderr가 whisperx를 죽이지 않게 ErrorActionPreference 분리 |
| 4 | 90MB+ 파일은 ffmpeg 압축 후 업로드/전사 |
| 5 | Transcript 끝 ≠ 완료. Performing alignment... 후 .srt 생성까지 대기 |
| 6 | torchcodec 경고는 무시 가능 (ffmpeg 경로 사용) |
| 7 | 급하면 --no_align 또는 Vrew |
16. 관련 문서
| 글 | 관점 | |
|---|---|---|
| [영상 및 음성 자막인식 AI 종류 | 텍스트 전사 모델 총정리](/wiki/stt-transcription-models-api-openrouter-2026/) | 무엇을 고를까 — OpenRouter Transcription·CER/WER·API 요율·출시 연혁 (이 글은 실측·실행 기록) |
| [영상 편집 자동화 | Vrew·Whisper·FFmpeg·Remotion](/wiki/video-editing-automation-whisper-ffmpeg-remotion/) | SRT 이후 FFmpeg·Remotion 자동 컷 |
17. 마무리
앞에서 다룬 장시간 한국어 강의 전사·자막 선택의 핵심만 짧게 정리한다.
- SRT 하나로: 유튜브·숏폼·위키·블로그 · 뽑기: GPU/CPU→WhisperX, GUI만→Vrew
- CPU 실측(2h14m): 46분 — 표·로그는 「CPU WhisperX 실측」 장
- GPU 시간: 4070 벤치 추정 ~3분대 — 「GPU가 있다면」 장, 실측 아님
- 품질 grep: 「CPU WhisperX vs Vrew」 한 장에만 상세
- Colab: Windows Docker, 장시간은 비현실적 — 요약만, 상세는 별도 글
- FFmpeg·Remotion 자동 컷: 영상 편집 자동화 위키 — 이 글과 역할 분리
「SRT만 있으면 숏폼·위키·블로그까지 연결 — 뽑는 쪽은 장비·자동화면 WhisperX, GUI만으로는 Vrew.」 — 수치·요금·모델 지원은 2026년 6월 기준이며 정책 변경 시 재확인한다.
자주 묻는 질문
- 한국어 2시간 강의, 뭘로 전사·자막 뽑나?
SRT·전사 txt는 한 번 만들면 유튜브·숏폼·위키·블로그·검색에 같이 쓴다. CPU/GPU·스크립트·자동화 OK면 WhisperX(실측 46분·GPU ~3분 추정). 장비·설정 부담 없이 GUI로 당일 끝내려면 Vrew. GPU 없고 API OK면 gpt-4o-transcribe 분할. 「상황별 최종 선택표」 참고.
- CPU WhisperX로 2시간 14분은 실제로 얼마나 걸리나?
2026-06-19 실측 총 45분 41초(RTF 2.9×). 전사 26분 + alignment 19분. 단계별 표·로그는 본문 「CPU WhisperX 실측」 장 참고.
- WhisperX와 Vrew 내장 STT 품질 차이는?
같은 MP3 기준 IT·영문 혼용에서 WhisperX 우세(Next.js 정확 11 vs 0). 일반 구어는 비슷. 용도 분기가 아니라 품질·뽑는 방식 분기 — Vrew SRT도 유튜브·위키에 쓸 수 있으나 IT 키워드 교정 부담↑. grep·오프닝은 「CPU WhisperX vs Vrew」 장.
- Transcript가 끝났는데 SRT가 없다.
WhisperX는 Performing alignment 이후에야 .srt가 생긴다. alignment는 15~20분 무출력일 수 있다. Done + .srt 파일로 완료 확인.
- Windows WhisperX cp949 UnicodeEncodeError
한글 Transcript print 시 cp949 한계. 전사 스크립트에 PYTHONUTF8=1, PYTHONIOENCODING=utf-8:replace, Console UTF-8. 실전 체크리스트 참고.
- RTX 5070이면 2시간 14분 WhisperX는?
2026-06 기준 RTX 4070 FP16 벤치로 추정한 값으로 5070은 약 2.5~3.5분(실측 아님). 표·옵션은 「GPU가 있다면」 장.
- gpt-4o-transcribe 2시간 한국어 비용·제한
2026-06 기준 약 25분·25MB 제한 → 분할·오프셋·SRT 병합 직접 구현. 비용은 대략 1,000원/2h. 요율·파이프라인은 「gpt-4o-transcribe API」 장.
- Google Colab CLI를 Windows에서 쓸 수 있나?
공식 CLI는 Linux·macOS만. Windows는 Docker colab-cli. 이번 2시간 분량은 T4로도 대기 부담으로 중단. 요약은 「Google Colab CLI (요약)」.
- WhisperX --no_align은 언제 쓰나?
alignment 19분을 줄여 총 ~27분까지 단축(2026-06 CPU 실측). 단어 단위 타임스탬프·highlight_words 불가. 급할 때 응급처치.
- 2026년에도 Whisper가 한국어 STT 1순위인가?
2026-06 기준 한국어 자막·SRT 타이밍까지 포함하면 WhisperX(faster-whisper+alignment)가 오픈소스 1순위. Parakeet v3 등 영어 벤치 우위 모델은 한국어 미지원(당시). 「한국어 STT 판도」 참고.