 테크·IT
1. Neuralwatt란 — kWh로 요금을 매기는 AI 추론 서비스
Neuralwatt는 AI 모델 추론(inference) 서비스를 제공하는 스타트업으로, 가장 큰 특징은 에너지 기반 과금(energy-based pricing)이다. 토큰 수가 아니라 실제로 소비한 GPU 전력량(kWh)을 기준으로 요금을 매기는 방식으로, Microsoft·Intel 출신 인력이 창업했다. GLM, Kimi, Qwen 같은 오픈웨이트 모델을 OpenAI 호환 API 형태로 제공하며, Cursor·Claude Code·Cline 같은 코딩 도구에서 그대로 끼워 쓸 수 있다.
핵심 전제는 단순하다. 같은 작업을 더 적은 전력으로 끝내는 모델일수록 요금이 싸진다. 그래서 MoE(Mixture of Experts) 구조로 GPU를 짧게만 쓰는 효율 좋은 모델일수록 토큰 과금 대비 유리해진다. 종량제 기본 요율은 $5/kWh로 모든 모델에 동일하게 적용된다.
Crusoe Cloud와 협력해 추론 처리량을 높이고 GPU 유휴 전력을 줄인다고 홍보한다. Reddit(r/opencode, r/opencodeCLI, r/ZaiGLM)에서는 OpenCode·Claude Code·Cline 연동 사례가 많고, Cursor 커스텀 키 연결도 가능하지만 Agent 동시 요청 때문에 OpenCode·CLI 직접 호출이 더 매끄럽다는 의견이 자주 나온다.
2. 에너지 과금 vs 토큰 과금 — 왜 95% 저렴해지는가
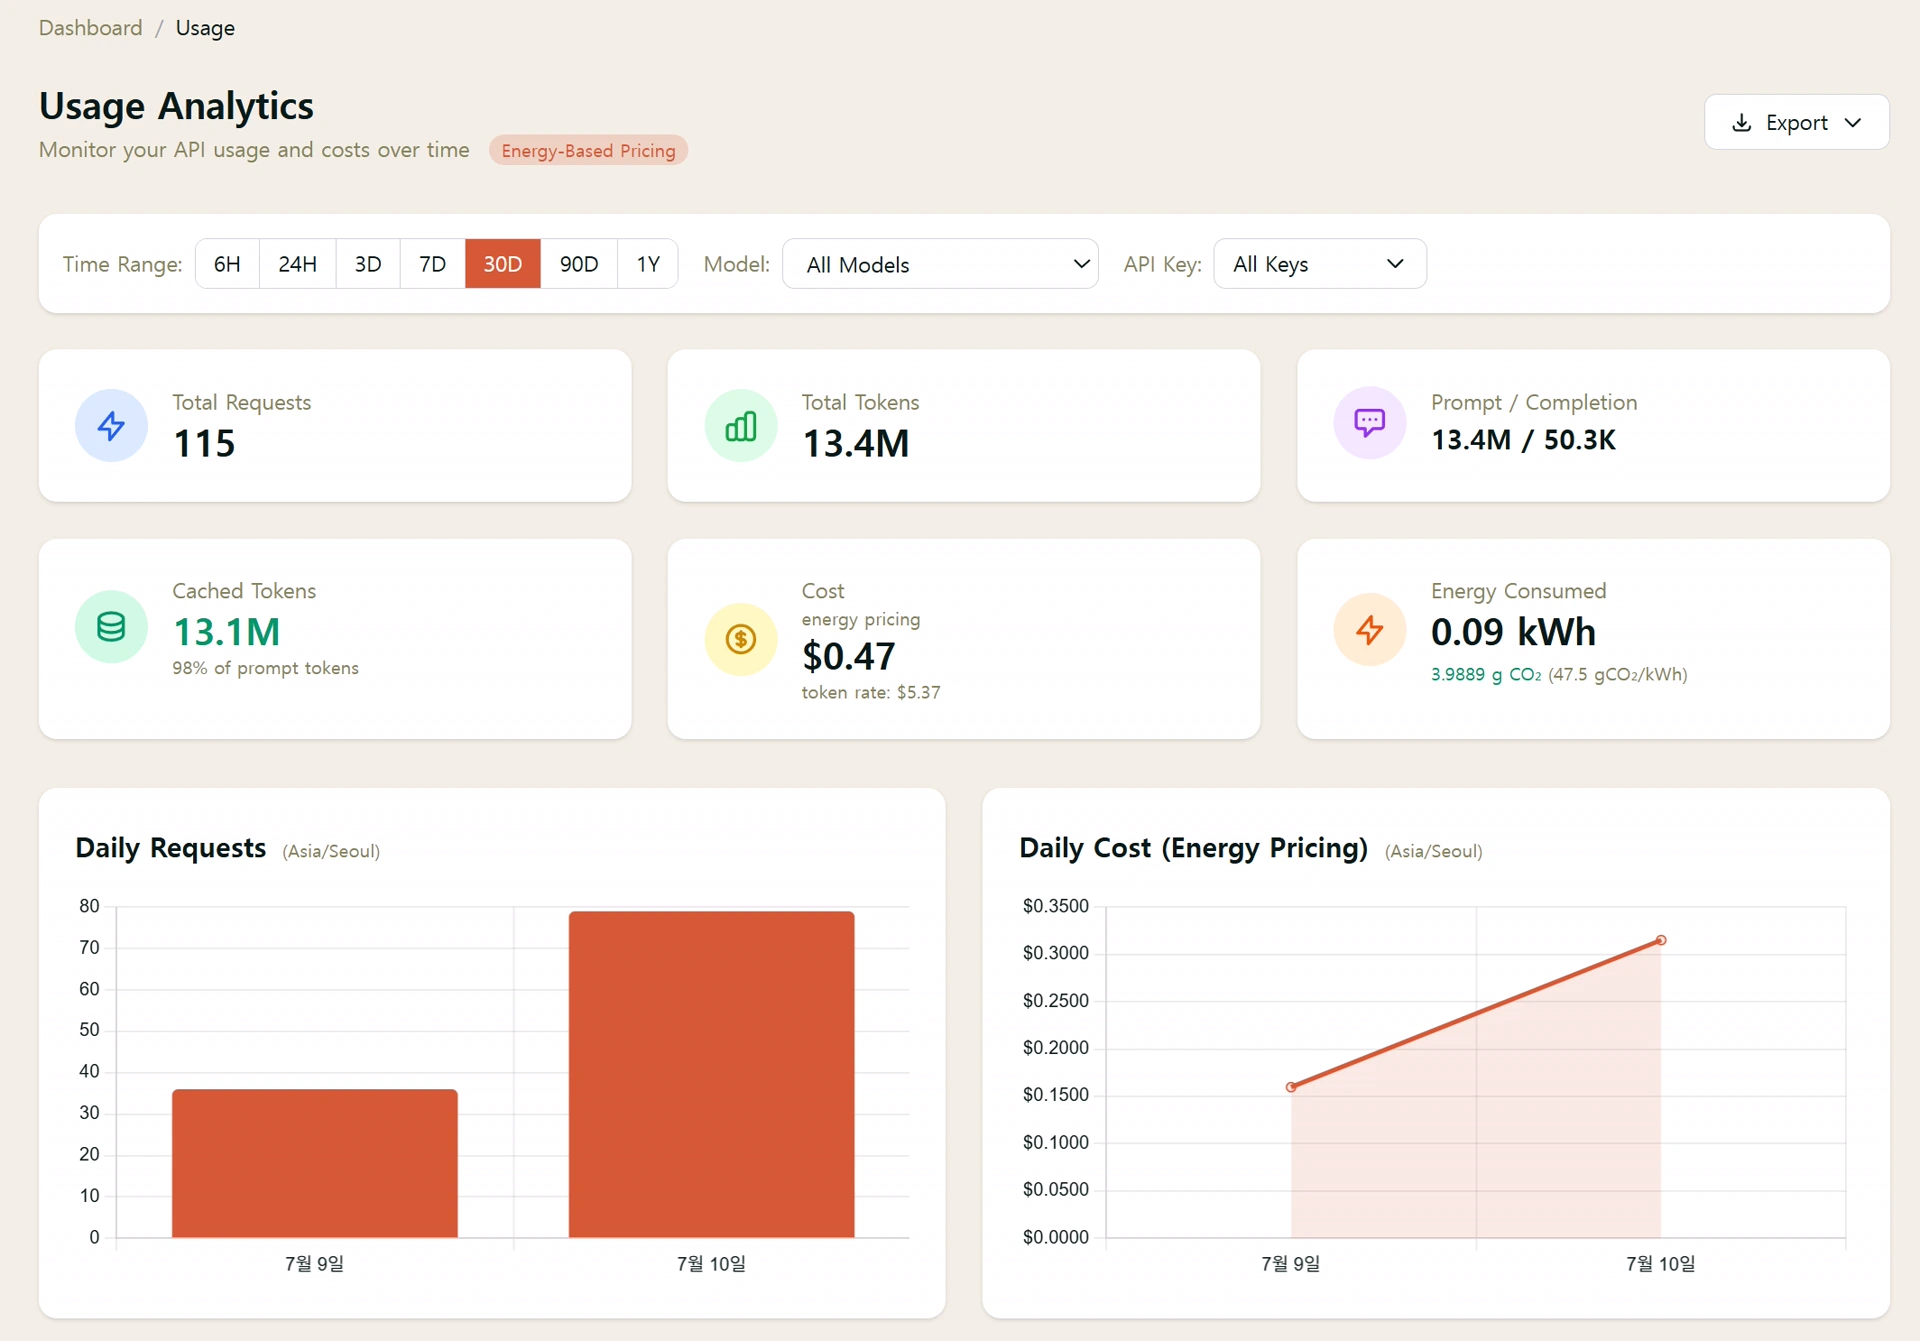 그림 1. Usage Analytics(대시보드 30D 탭·실제 작업은 하루) — 115요청·13.4M 토큰·캐시 98%·에너지 과금 $0.47(토큰 과금이었다면 $5.37)·0.09kWh.
이론상 에너지 과금이 토큰 과금보다 최대 95% 저렴하다고 해도, Cursor에서 glm-5.2-fast로 스킬·위키 포스팅 같은 복잡한 작업을 돌리면 생각보다 비용이 빠르게 올라간다. 위 스크린샷은 이 글 1건만 포스팅하는 데 약 $0.47(730원) 이 나온 실측이다. 13.4M 토큰 중 98%가 캐시 프롬프트인데도 그만 나왔다.
절감하려면 이렇게 해야 한다. glm-5.2-fast만 고집하지 말고, Neuralwatt 대시보드의 Avg Energy/Req 열을 보고 Qwen3.6 35B Fast(약 134mWh)처럼 전력 소모가 낮은 모델을 쓴다. Cursor Agent는 파일 읽기·도구 호출·검색을 동시에 여러 번 쏘아내므로 토큰이 폭증한다. Cursor를 거치지 않고 CLI(OpenAI 호환 curl·스크립트)에서 직접 API를 호출하면 중간 오버헤드가 줄어든다. 프롬프트를 짧게 유지하는 토큰 다이어트도 필수다.
다만 싸게 쓰려고 Neuralwatt + Cursor 커스텀 키 조합만 믿고 바로 실무에 투입하기엔 부담이 있다. 응답이 느리고, 피크 시간대엔 524 타임아웃이 나기도 한다. 스킬·에이전트처럼 복잡한 워크플로를 자주 돌린다면 종량제보다 Neuralwatt 구독(Standard $50)이나 GLM 공홈 정액제(Pro $50.4)가 오히려 낫다. 비용 절감과 즉시 쓸 만한 속도·안정성은 동시에 잡기 어렵다.
2.1. 하루 작업 실측 — 캐시 98% 워크로드
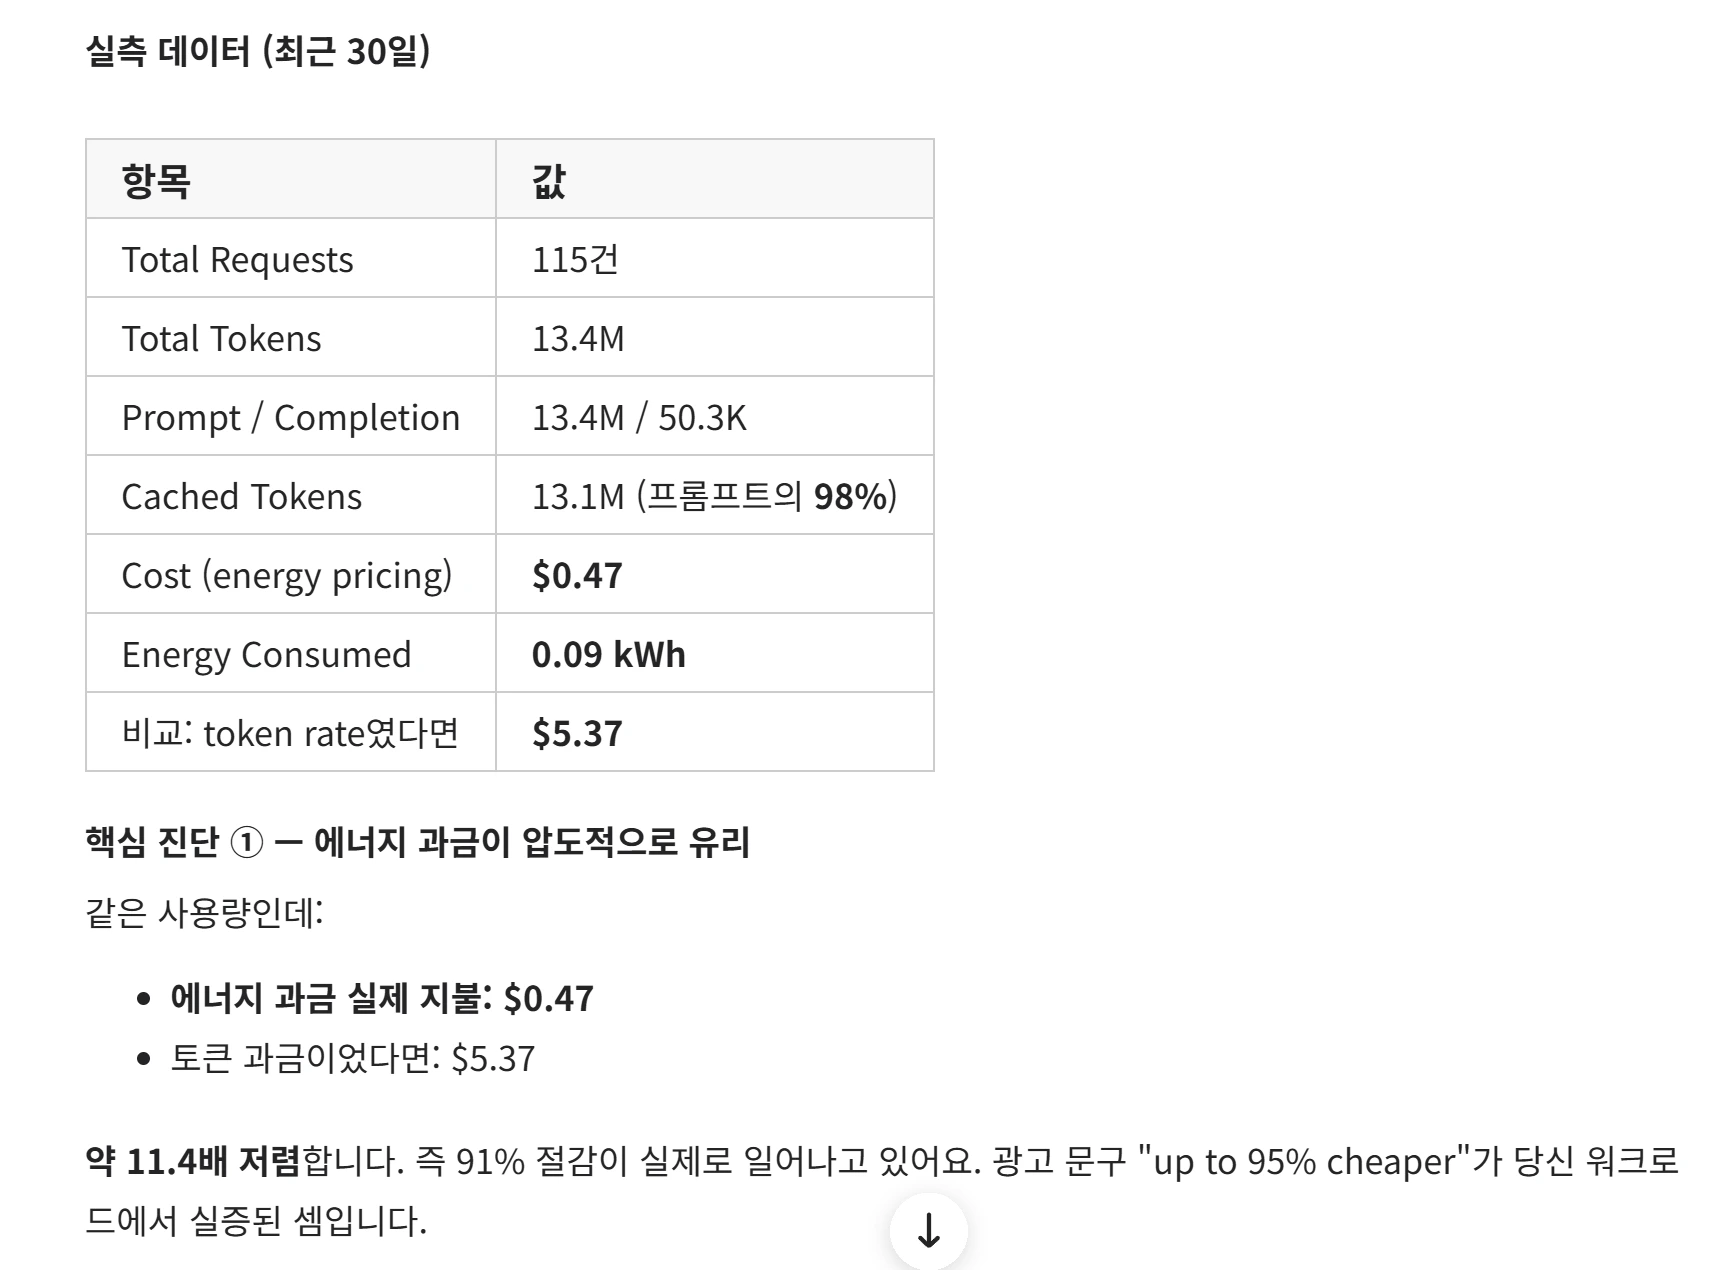 그림 2. 하루 작업 요약 — 에너지 과금 $0.47 vs 토큰 과금 $5.37(약 11.4배·91% 절감).
위 수치는 하루 만에 이 위키 글 1건만 작업한 결과다. 대시보드 청구 화면에 30D(30일) 가 보이지만, 이는 분석 기간 탭 이름이지 30일간 누적 사용량이 아니다. 그림 2는 같은 작업에 대해 에너지 과금과 토큰 과금을 나란히 비교한 요약이다.
| 항목 | 값 |
|---|---|
| Total Requests | 115건 |
| Total Tokens | 13.4M (Prompt 13.4M / Completion 50.3K) |
| Cached Tokens | 13.1M (프롬프트의 98%) |
| 에너지 과금 실제 | $0.47 (0.09 kWh) |
| 토큰 과금이었다면 | $5.37 |
| 절감 배수 | 약 11.4배(91% 절감) |
토큰당 실측 전력은 0.00672 mWh/토큰으로, 짧은 요청 추정(0.0344)이나 큰 요청 분포 추정(0.0106)보다 훨씬 낮다. 같은 코드베이스 컨텍스트를 반복 보내 prefix caching이 잘 먹으면 에너지가 급격히 줄어든다. 캐시 입력 단가($0.3625/M)는 일반 입력($1.45/M)의 1/4 수준이다.
이 효율을 그대로 적용한 월간 추정($5/kWh 종량제):
| 월 사용 토큰 | 에너지 소비 | 종량제 비용 | 원화(1,550원) |
|---|---|---|---|
| 1억 | 0.672 kWh | 약 $3.4 | 약 5,200원 |
| 10억 | 6.72 kWh | 약 $33.6 | 약 52,000원 |
| 40억 | 26.9 kWh | 약 $134 | 약 208,000원 |
캐시율이 극도로 높은 워크로드라면 월 30억 토큰 미만까지는 종량제가 구독($20 Basic)보다 저렴할 수 있다. 월 30억 이상이 되면 Pro 구독($100, 33kWh)이 의미가 생긴다. 여러 프로젝트를 옮겨다니면 캐시율이 떨어져 토큰당 전력이 올라간다.
토큰 과금은 모델 제공사가 토큰당 단가를 정한다. 입력·출력·캐시 입력 각각 다른 단가가 붙고, 모델이 실제로 GPU를 얼마나 썼는지와 무관하게 토큰 수에 비례해 청구된다. Neuralwatt의 에너지 과금은 구조가 다르다. 요청 하나가 GPU를 점유한 시간(전력 소비)을 측정해서 kWh 단가를 곱한다.


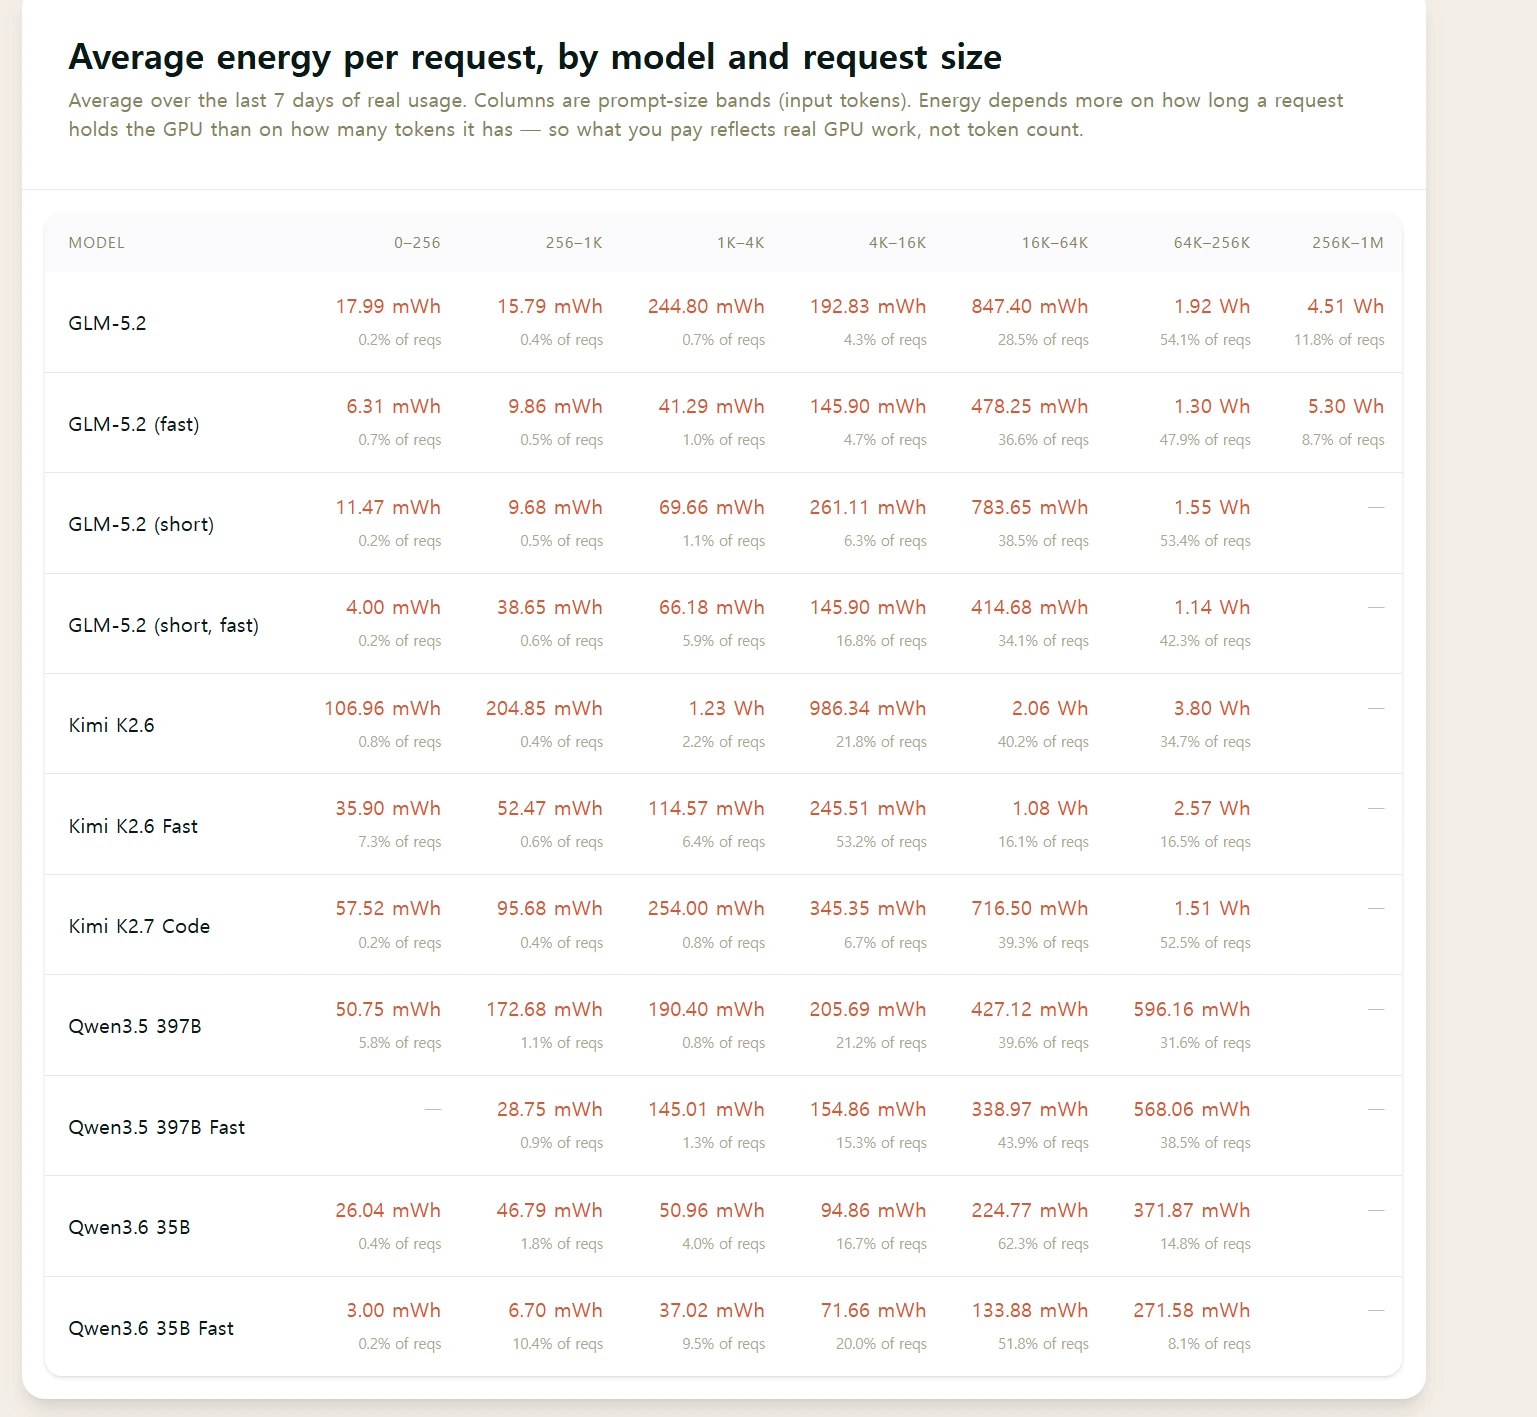 그림 5. Average energy per request by model and request size — GLM-5.2는 64K~256K 구간 54.1%, Qwen3.6 35B Fast는 0~256 토큰 3mWh.
즉 “얼마나 오래 GPU를 잡느냐”가 비용을 결정한다.
이 차이가 왜 큰가. 긴 컨텍스트 요청을 한 번에 몰아서 보내면 GPU를 한 번만 띄워 연속 처리할 수 있어 토큰당 전력 소비가 급격히 낮아진다. 반면 짧은 요청을 여러 번 왕복시키면 매번 GPU를 새로 점유하는 오버헤드가 붙어 토큰당 전력이 올라간다.
Neuralwatt가 제공하는 실측 데이터를 보면 64K~256K 토큰 구간 요청이 전체의 54%를 차지하며, 이 구간에서 토큰당 전력 효율이 가장 좋다.
GLM-5.2 기준으로 두 과금 방식의 백만 토큰당 단가를 비교하면 차이가 분명해진다.
| 과금 방식 | 백만 토큰당 단가 | 월 1억 토큰 예상 비용 |
|---|---|---|
| 토큰 과금(입력 $1.45/출력 $4.50, 입력90:출력10 가정) | 약 $1.75 | 약 $175 |
| 에너지 과금(큰 요청 분포 기준, 약 0.0106 mWh/토큰) | 약 $0.053 | 약 $5.3 |
| 에너지 과금(짧은 요청 실측, 약 0.0344 mWh/토큰) | 약 $0.172 | 약 $17.2 |


에너지 과금이 토큰 과금 대비 최대 95%가까이 저렴하다는 Neuralwatt의 주장은 큰 요청 위주 워크로드에서 성립한다. 다만 짧은 요청 위주라면 토큰당 전력이 3배가까이 높아져 절감폭이 줄어든다.
3. 예산·토큰량별 비용 계산
아래는 GLM-5.2 기준이며, 환율 1,550원/달러를 적용했다. 전력 과금은 요청 크기·캐시율에 따라 크게 달라진다.
3.1. 단건 실측에서 역산 — 2억 토큰
요청 1건(2,342 토큰, 80.59 mWh, $5/kWh) 기준 토큰당 약 0.0344 mWh/토큰이면:
- 2억 토큰 에너지: 약 6.88 kWh → 약 $34.4(약 53,300원)
- 같은 비율의 토큰 과금: 약 $717(약 111만 원) — 스크린샷 "95% cheaper"와 일치
3.2. $20 예산으로 몇 토큰?
| 기준 효율 | $20(4 kWh) 처리 토큰 | 비고 |
|---|---|---|
| 짧은 요청(0.0344 mWh/토큰) | 약 1.16억 | 보수적 상한 |
| 큰 요청 분포(0.0106 mWh/토큰) | 약 3.8억 | 64K~256K 위주 |
| 캐시 98% 실측(0.00672 mWh/토큰) | 약 6억 | 동일 프로젝트 집중 작업 |
Reddit 사례 "GLM-5.2로 7,300만 토큰 $8", "148M 토큰 후 $20 구독"과도 대체로 맞는다. $20 종량제 충전과 $20 Basic 구독(6kWh, 이월 없음)은 조건이 다르다.
3.3. Cursor 누적 통계 vs Neuralwatt 환산
| 구분 | 토큰 | Cursor 실제 | Neuralwatt 환산(0.0344 mWh) | 절감 |
|---|---|---|---|---|
| 전체 누적 | 161.87억 | $5,136 | 약 $2,784 | ~46% |
| 최근 1개월 | 8.62억 | $413 | 약 $148 | ~64% |
주의: Cursor 통계는 Claude·Grok 계열(Max Mode, 캐시 구조 포함)이고 Neuralwatt 환산은 GLM-5.2 기준이다. "같은 작업을 더 싸게"가 아니라 모델 전환에 가깝다. Cursor 캐시 91% 입력 구조와 Neuralwatt prefix caching은 메커니즘이 다르다.
3.4. 모델별 토큰 vs 전력 — 월 1억 토큰(입력 90% : 출력 10%)
| 모델 | 토큰 과금(원) | 전력 과금(원)* |
|---|---|---|
| GLM-5.2 | 약 272,000 | 약 8,200~26,700 |
| Kimi K2.6 | 약 146,000 | 근사치 동일 가정 |
| Qwen3.6 35B | 약 58,300 | 근사치 동일 가정 |
*전력 열은 모델별 실측이 없어 GLM-5.2 큰 요청 분포($5.3)와 짧은 요청($17.2) 범위로 표기. Qwen3.6 35B Fast는 Avg Energy/Req 자체가 낮아 실제로는 더 싸질 수 있다.
4. GLM-5.2 — 1M 컨텍스트 오픈웨이트 코딩 모델
GLM-5.2는 중국 지푸AI(Zhipu, Z.ai)가 2026년 6월에 공개한 오픈웨이트 코딩 모델이다. MIT 라이선스로 공개돼 있고 최대 1M(약 104만) 토큰 컨텍스트를 지원한다. 벤치마크에서 오픈웨이트 모델 중 최상위권 성능을 기록하고 있어, 비용 절감과 성능 사이에서 균형을 잡으려는 사용자에게 자주 언급된다.
GLM-5.2와 프론티어급 상용 모델인 Grok 4.5(2026년 7월 8일 출시)의 코딩 벤치마크를 비교하면 아래와 같다.
| 벤치마크 | GLM-5.2 | Grok 4.5 | 차이 |
|---|---|---|---|
| SWE-bench Pro(난이도 높은 소프트웨어 엔지니어링) | 62.1% | 64.7% | Grok 4.5 +2.6%p |
| DeepSWE 1.1(실제 GitHub 이슈 해결, 독립 평가) | 44% | 53% | Grok 4.5 +9%p |
| Terminal Bench 2.1(터미널 작업) | 81.0% | 83.3% | Grok 4.5 +2.3%p |
순수 벤치마크 점수는 Grok 4.5가 세 항목 모두에서 앞선다. 하지만 격차가 압도적이지는 않고, SWE-bench Pro에서는 2.6%p 차이에 그친다. 오픈웨이트 모델이면서 이 정도 성능이라는 점과, 토큰 단가가 더 낮다는 점이 GLM-5.2의 강점이다. 한 가지 주의할 점은 Grok 4.5가 환각률(틀린 답을 내놓는 비율)이 이전 모델 대비 크게 올랐다는 지적이 있다. 확신에 차서 틀리는 경우가 늘었기 때문에 코드 검증 없이 맹신하면 위험하다.
4.1. Grok 4.5와 월 비용 비교 (2026년 7월)
| 항목 | GLM-5.2 (Neuralwatt) | Grok 4.5 (API/Cursor) |
|---|---|---|
| 입력/출력 단가 | $1.45 / $4.50 per M | $2 / $6 per M |
| 월 1억 토큰(전력, 큰 요청) | 약 8,200~26,700원 | — |
| 월 1억 토큰(토큰 과금) | 약 272,000원 | 약 20만~35만 원대* |
| 오픈웨이트 | 예(MIT) | 아니오 |
| 컨텍스트 | 1M | — |
*입출력 비율·작업당 토큰 효율에 따라 변동. Grok 4.5는 작업당 토큰을 적게 쓰는 편이라 단가 차이만큼 총비용 격차가 벌어지지 않을 수 있다.
5. 어느 게 가장 저렴한가 — 모델·요금제 선택과 절약 팁
Neuralwatt Models 페이지의 Avg Energy/Req는 최근 7일 실사용 기준, 요청 1건당 평균 전력이다. 종량제 $5/kWh에 곱하면 요청당 전력 비용이 나온다. 그림 4(All Models 표)와 아래 순위를 함께 보면 된다.
5.1. 전력 과금 기준 — 요청당 비용 순위 ($5/kWh)
| 순위 | 모델 | Avg Energy/Req | 요청당 전력 비용 |
|---|---|---|---|
| 1 | Qwen3.6 35B Fast | 134.83 mWh | $0.000674 |
| 2 | Qwen3.6 35B | 226.71 mWh | $0.001134 |
| 3 | Kimi K2.6 Fast | 246.72 mWh | $0.001234 |
| 4 | Qwen3.5 397B Fast | 343.94 mWh | $0.001720 |
| 5 | GLM-5.2 (short, fast) | 424.12 mWh | $0.002121 |
| 6 | Qwen3.5 397B | 429.74 mWh | $0.002149 |
| — | GLM-5.2 (fast) | 1.30 Wh | $0.006500 |
| — | Kimi K2.7 Code | 1.44 Wh | $0.007200 |
| — | GLM-5.2 (short) | 1.55 Wh | $0.007750 |
| — | GLM-5.2 | 1.94 Wh | $0.009700 |
| — | Kimi K2.6 | 2.06 Wh | $0.010300 |
절대적으로 가장 저렴한 모델 ID: qwen3.6-35b-fast — 요청당 전력·토큰 단가(입력 $0.29/M, 출력 $1.15/M) 모두 최저권이다. 다만 35B·thinking OFF라 복잡한 코딩·추론에는 부족할 수 있다.
성능 대비 균형: 코딩 품질이 필요하면 glm-5.2-fast(1M, thinking OFF)나 kimi-k2.6·kimi-k2.6-fast가 낫다. GLM-5.2 본판 대비 fast는 전력 33% 절감(1.94Wh → 1.30Wh).
요금제까지 포함한 “가장 싼 조합”
| 상황 | 가장 저렴한 선택 |
|---|---|
| 단순 반복·라우팅·대량 호출 | 전력 과금 + qwen3.6-35b-fast |
| 코딩·에이전트(품질 필요) | 전력 과금 + glm-5.2-fast + 캐시 극대화 |
| 같은 프로젝트 집중 작업(캐시 90%+) | 종량제 PAYG — 구독보다 쌀 수 있음(실측 월 1억 약 $3.4) |
| 월 10억 토큰 미만·큰 요청 위주 | Neuralwatt 종량제 또는 Basic 구독 |
| 월 40억 토큰 꽉 채워 사용 | GLM 공홈 Max 정액제($112) |
| 토큰 과금 모드로 쓸 경우 | Qwen3.6 35B 계열이 GLM-5.2보다 토큰 단가 낮음 |
5.2. 함정 — “요청당”만 보면 왜곡된다
Avg Energy/Req는 토큰당 비용이 아니다. GLM-5.2는 1M 컨텍스트라 요청 하나에 토큰이 많이 실려 에너지가 높게 나오고, Qwen3.6 35B는 131K라 요청당 수치가 낮다. 같은 작업량을 처리했을 때 어느 쪽이 싼지는 이 표만으로는 알 수 없다.
정확히 비교하려면 동일 프롬프트를 여러 모델로 돌린 뒤 대시보드 Usage Analytics에서 실제 kWh·토큰당 mWh를 본인 데이터로 확인하는 게 맞다.
5.3. fast 버전이 항상 더 싼 이유
모든 계열에서 fast = reasoning(thinking) OFF라 GPU 점유 시간이 짧아진다.
| 모델 | 일반 | fast | 절감 |
|---|---|---|---|
| GLM-5.2 | 1.94 Wh | 1.30 Wh | 약 33% |
| Kimi K2.6 | 2.06 Wh | 246.72 mWh | 약 88% |
| Qwen3.6 35B | 226.71 mWh | 134.83 mWh | 약 40% |
사고 과정이 필요 없는 작업(포맷 변환, 단순 답변, 라우팅)은 fast를 기본으로 쓰면 된다.
5.4. 절약 팁 — 실무에서 바로 쓸 수 있는 것
- 과금 방식: Billing에서 Energy-Based Pricing을 켠다. 토큰 과금은 같은 사용량에 최대 10배 이상 비쌀 수 있다(실측 91% 절감).
- 모델 선택: 무조건 싼
qwen3.6-35b-fast만 고집하지 말고, 코딩은glm-5.2-fast, 200K 이하 작업은glm-5.2-short-fast(권한 있을 때)를 검토한다. - 캐시 극대화: 같은 코드베이스·같은 시스템 프롬프트를 반복하면 prefix caching으로 프롬프트 98% 캐시가 가능하다. 캐시 입력 단가는 일반의 1/4($0.3625/M).
- 요청 크기: 짧은 요청 여러 번보다 긴 컨텍스트를 한 번에 보내는 편이 토큰당 전력 효율이 좋다(64K~256K 구간이 전체의 54% — 그림 5).
- 토큰 다이어트: 불필요한 파일 전체 붙여넣기·장문 시스템 프롬프트를 줄인다. Cursor Agent는 도구 호출마다 토큰이 폭증한다.
- 호출 경로: Cursor Agent 대신 OpenCode·CLI·스크립트 직접 호출이 중간 오버헤드가 적다. Cursor만 쓸 때는 Ask 모드가 Agent보다 rate limit에 덜 걸린다.
- 요금제: 사용량 들쭉날쭉하면 종량제(PAYG). 매달 꾸준히 많이 쓰면 구독 kWh 할인(33~39%) 또는 GLM 공홈 정액제를 비교한다.
- 피크 회피: UTC 저녁 피크에 524·지연이 잦다. Standard 이상 구독은 priority access, 급하지 않으면 flex·short 모델을 고려한다.
- 실측 후 결정: 무료 $5 크레딧으로 본인 워크로드를 하루이틀 돌려 토큰당 mWh를 확인한 뒤 모델·요금제를 고정한다.
캐시율이 90% 넘는 워크로드(그림 1·2 실측)라면 소형 모델로 내릴 필요 없이 glm-5.2-fast + 종량제가 성능·비용 균형이 가장 좋다. 단순 반복만 대량이면 qwen3.6-35b-fast를 보조 모델로 두면 된다.
5.5. Kimi·Qwen 모델 ID (Cursor 커스텀용)
| 모델 ID | 입력/출력 ($/M) | 컨텍스트 | 비고 |
|---|---|---|---|
| kimi-k2.7-code | $0.95 / $4.00 | 262K | 비전·도구 |
| kimi-k2.6 | $0.69 / $3.22 | 262K | 비전·도구 |
| kimi-k2.6-fast | $0.69 / $3.22 | 262K | thinking OFF |
| qwen3.6-35b | $0.29 / $1.15 | 131K | 가장 낮은 토큰 단가 |
| qwen3.6-35b-fast | $0.29 / $1.15 | 131K | 전력·단가 모두 최저권 |
| qwen3.5-397b | $0.69 / $4.14 | 262K | — |
| qwen3.5-397b-fast | $0.69 / $4.14 | 262K | — |
6. Neuralwatt 요금제 — PAYG, 구독, 공홈 정액제 비교
Neuralwatt는 종량제(PAYG)와 구독 플랜을 모두 제공한다. 어느 쪽이 유리한지는 월 사용량과 요청 크기 분포에 따라 달라진다.
6.1. Neuralwatt 종량제 vs 구독 플랜
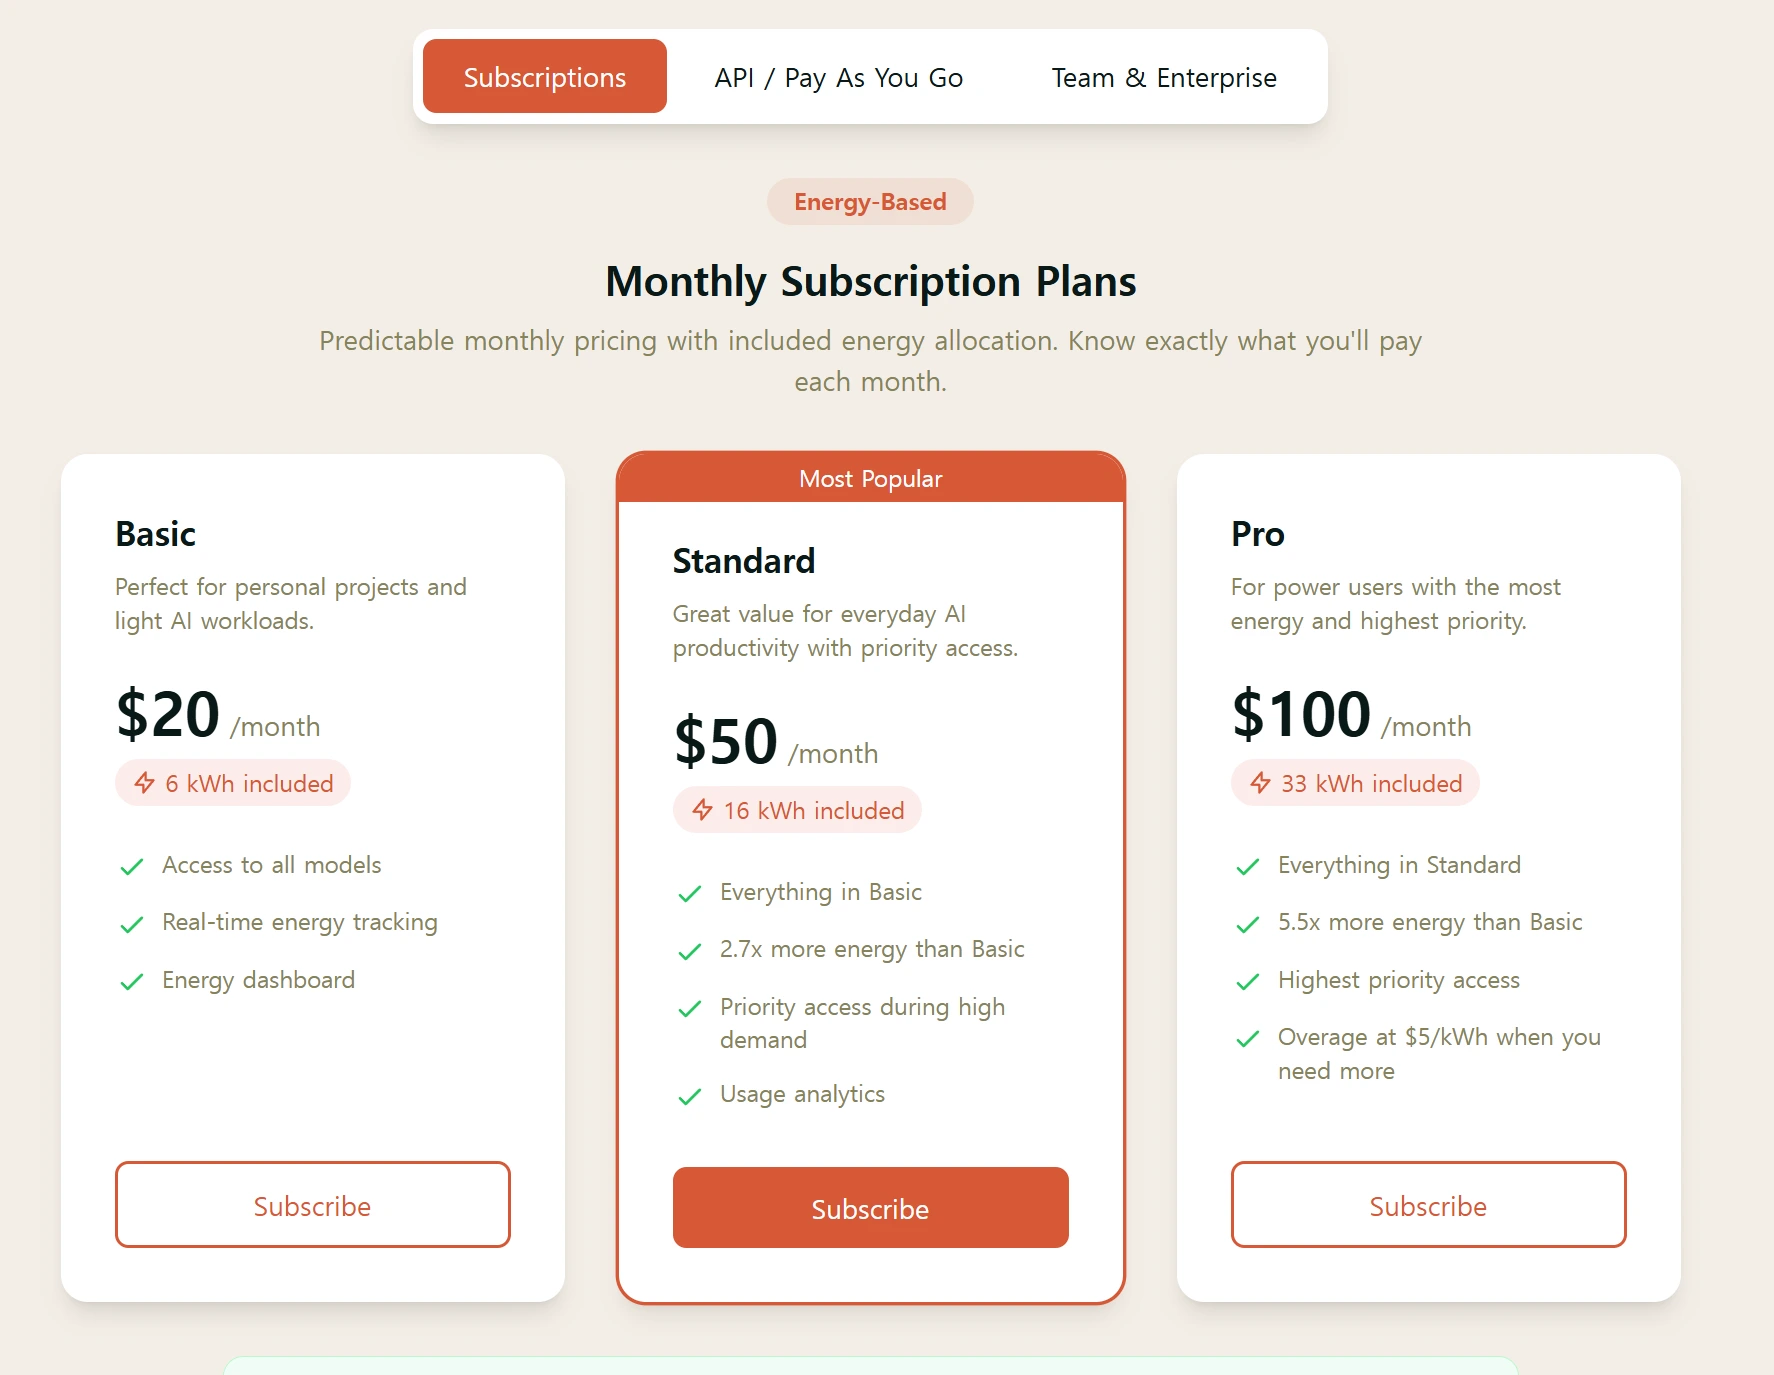 그림 8. Neuralwatt 구독 — Basic $20/6kWh, Standard $50/16kWh(인기), Pro $100/33kWh·overage $5/kWh.
| 구분 | 월 가격 | 포함 kWh | 실질 kWh 단가 | PAYG 대비 |
|---|---|---|---|---|
| PAYG(종량제) | 사용량만큼 | 없음 | $5.00/kWh | 기준 |
| Basic(구독) | $20 | 6 kWh | 약 $3.33/kWh | 33% 할인 |
| Standard(구독) | $50 | 16 kWh | 약 $3.13/kWh | 37% 할인 |
| Pro(구독) | $100 | 33 kWh | 약 $3.03/kWh | 39% 할인 |
구독 플랜에 가입하면 종량제 $5/kWh보다 33~39% 싼 단가로 에너지를 살 수 있다. 다만 구독에 포함된 에너지는 매월 리셋되며 이월되지 않는다. 사용량이 들쭉날쭉하면 오히려 종량제가 유리할 수 있다. Pro 등급을 초과하는 사용분(overage)은 다시 $5/kWh로 청구된다.
6.2. GLM 공홈(Z.ai) 정액제와 비교


GLM-5.2는 Z.ai 공홈에서도 정액제 구독(Coding Plan)으로 쓸 수 있다. 세 티어(Lite·Pro·Max)로 나뉘고, 연간 결제 시 30% 할인이 적용된다.
| GLM 공홈 플랜 | 월 가격(연간) | 주간 프롬프트 한도(역산) |
|---|---|---|
| Lite | $12.6 | 약 2억 토큰 |
| Pro | $50.4 | 약 10억 토큰 |
| Max | $112 | 약 40억 토큰 |
Neuralwatt 구독과 GLM 공홈 정액제를 같은 토큰량 기준으로 비교하면 손익분기점이 보인다.
| 비교 | Neuralwatt(큰 요청 기준) | GLM 공홈 정액제 |
|---|---|---|
| 약 2억 토큰 | Basic $20 → 약 $10.6 상당 | Lite $12.6(정액) |
| 약 10억 토큰 | Standard $50 → 약 $53 상당 | Pro $50.4(정액) |
| 약 30억 토큰 이상 | Pro $100 한도 초과 | Max $112(정액) |
월 10억 토큰 전후가 손익분기점이다. 그 이하면 Neuralwatt 종량제나 Basic 구독이 유리하고, 그 이상 안정적으로 쓴다면 GLM 공홈 Max 정액제가 근소하게 유리해진다. 단 GLM 공홈 정액제는 주간 리밋에 걸리면 그 주는 더 못 쓰는 반면, Neuralwatt 종량제는 리밋 없이 계속 쓸 수 있다는 유연성 차이가 있다. 큰 요청(배치) 위주로 쓸수록 Neuralwatt 에너지 과금의 효율이 극대화된다.
6.3. Neuralwatt 구독 vs GLM 공홈 — 플랜별 역산
한도를 꽉 채운다는 가정으로, Neuralwatt 구독(큰 요청 기준 약 0.0106 mWh/토큰)과 GLM 공홈 정액제를 나란히 놓으면:
| 비교 | Neuralwatt | 처리 토큰(큰 요청) | GLM 공홈 | 월 한도(역산) | 백만 토큰당 |
|---|---|---|---|---|---|
| Basic vs Lite | $20 / 6kWh | 약 5.7억 | Lite $12.6 | 약 2억 | NW $0.035 vs GLM $0.063 |
| Standard vs Pro | $50 / 16kWh | 약 15.1억 | Pro $50.4 | 약 10억 | NW $0.033 vs GLM $0.050 |
| Pro vs Max | $100 / 33kWh | 약 31.2억 | Max $112 | 약 40억 | NW $0.032 vs GLM $0.028 |
구독 할인(33~39%)을 넣으면 이전 종량제-only 계산과 달리 Basic~Standard 구간에서 Neuralwatt가 GLM 공홈보다 단가 1.5~1.8배 저렴해질 수 있다. Max($112, 월 40억)만 근소하게 앞선다.
종량제 $5/kWh만 쓸 때 손익분기는 월 약 21억 토큰(Max $112 ÷ $0.053/M). 짧은 요청 위주(0.0344 mWh)면 손익분기가 월 10억 전후로 내려간다. GLM Max를 사서 한도의 절반만 쓰면 실질 단가가 2배가 되어 Neuralwatt와 비슷해진다.
7. Rate limit과 동시 요청 슬롯 — Cursor Agent가 막히는 이유


Neuralwatt는 누적 사용액이나 구독 등급에 따라 동시 요청 슬롯(concurrency slots)과 분당 요청 한도를 제한한다. 이게 Cursor Agent 모드에서 “User Provided API Key Rate Limit Exceeded” 에러가 뜨는 핵심 원인이다.
| 티어 | 동시 슬롯 | 획득 조건 |
|---|---|---|
| Trial | 2 | 무료 계정, $1 크레딧 |
| PAYG | 2~5 | 종량제, 누적 $50 도달 시 5 슬롯 |
| Basic | 3 | 월 구독 |
| Standard | 5 | 월 구독 |
| Pro | 10 | 월 구독 |
| Enterprise | 20+ | 별도 계약 |
Cursor의 Agent 모드는 한 작업에서 파일 읽기·도구 호출·검색을 동시에 여러 개, 그리고 분당 수십 회 쏘아낸다. Basic의 3 슬롯과 낮은 분당 한도로는 이걸 감당하지 못한다. 크레딧이 있어도 티어의 동시성 한도가 낮아서 생기는 문제이므로, 결제나 설정이 잘못된 게 아니다. Ask(Chat) 모드처럼 요청이 순차적인 사용에서는 3 슬롯으로도 충분히 작동한다. Agent를 본격적으로 돌리려면 Standard($50) 이상 구독으로 슬롯을 올려야 한다.
8. Cursor에서 Neuralwatt GLM-5.2 연결 설정
 그림 15. Cursor Provider Error — 내장 "GLM 5.2 High"는 Neuralwatt에 없어 리소스를 찾지 못함.
 *그림 16. Cursor Settings — OpenAI API Key + Override Base URL `https://api.neuralwatt.com/v1`.*
Neuralwatt는 OpenAI 호환 엔드포인트를 제공하므로 Cursor의 커스텀 OpenAI 키 기능으로 연결할 수 있다. 설정 순서는 다음과 같다.
- Neuralwatt 대시보드에서 API 키를 발급받는다.
- Cursor Settings → Models → API Keys에서 OpenAI API Key를 켜고 발급받은 Neuralwatt 키를 넣는다.
- Override OpenAI Base URL을 켜고 `https://api.neuralwatt.com/v1`을 입력한다.
/v1까지만 넣는다. 뒤에/chat/completions까지 붙이면 경로가 중복돼 에러가 날 수 있다. - Custom Models에서 새 모델을 추가하고 이름을 Neuralwatt가 인식하는 정확한 ID로 넣는다.
모델 ID는 대소문자·하이픈까지 정확히 일치해야 한다. Neuralwatt의 /v1/models 엔드포인트에서 지원하는 ID 전체를 확인할 수 있다. GLM 계열은 아래 네 가지가 있다.
| 모델 ID | 설명 | 컨텍스트 | 추론(thinking) |
|---|---|---|---|
| glm-5.2 | 기본, 1M 컨텍스트 | 1,048,560 | O |
| glm-5.2-fast | 사고 생략, 빠름 | 1,048,560 | X |
| glm-5.2-short | 200K, 저에너지 | 199,984 | O(제한) |
| glm-5.2-short-fast | 200K, 가장 빠름 | 199,984 | X |
Cursor 내장 GLM-5.2(High/Max)와 이름이 겹쳐서 추가가 막히면, 내장 GLM 토글을 먼저 끄거나 glm-5.2-fast처럼 다른 ID로 추가하면 된다. Anthropic 키 칸은 비워둔다.
한 가지 주의. Cursor의 Override OpenAI Base URL은 전역 설정이라, 켜는 순간 Cursor 내장 모델(Grok 4.5, Claude 계열 등)이 작동하지 않게 된다. Neuralwatt만 쓸 때 켜고, 내장 모델로 돌아갈 때는 끄는 식으로 수동 전환해야 한다. Z.ai 직접 엔드포인트(`https://api.z.ai/api/paas/v4`)를 쓸 때도 같은 제약이 적용된다.
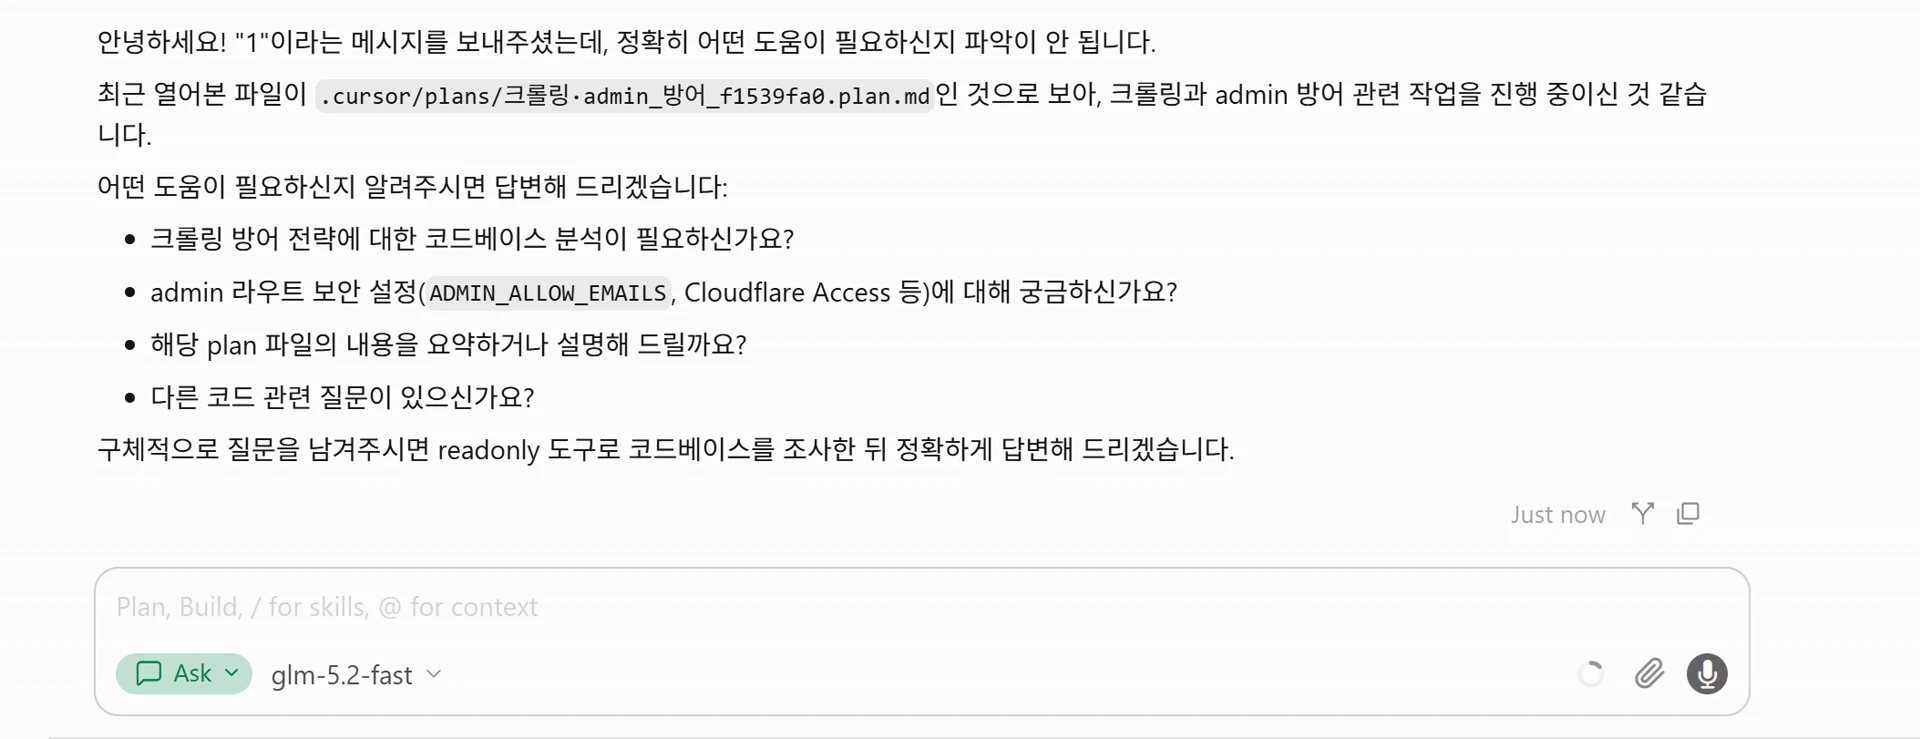 그림 17. glm-5.2-fast Ask 모드 연결 성공 — 열어둔 프로젝트 맥락을 파악한 뒤 한국어로 응답.
8.1. 자주 나는 에러와 해결
| 증상 | 원인 | 해결 |
|---|---|---|
| Provider Error — trouble finding the resource | 모델 ID 불일치(glm-5.2-high 등) | /v1/models의 id 그대로 입력 |
| glm-5.2 추가 시 "이미 존재" | Cursor 내장 GLM-5.2 High/Max와 충돌 | 내장 GLM 토글 OFF 또는 glm-5.2-fast 추가 |
| Rate Limit Exceeded (유료 크레딧 있음) | Basic 3 slots, Agent 동시 요청 폭주 | Ask 모드 또는 Standard+ 구독 |
| 524 / 타임아웃 | 피크 시간 서버 과부하 | flex·short 모델, 비피크 시간대, Standard priority |
Cursor Agent 대신 OpenCode·Claude Code·curl 스크립트로 Neuralwatt를 쓰면 동시성 제어가 쉽고 Reddit 후기도 이쪽이 많다. Neuralwatt 공식 문서에 Claude Code 연동 가이드가 별도로 있다.
9. Hermes(텔레그램 에이전트)에서 Neuralwatt 쓰기
Hermes는 OpenAI 호환 API를 지원하는 24시간 에이전트다. Neuralwatt 연동은 지원되지만, Hermes v0.15.1(현재 Docker 이미지) 에는 내장 1급 provider로는 아직 없고, 공식 가이드는 플러그인 + API 키 방식이다. portal.neuralwatt.com/dashboard/keys 에서 키를 발급한 뒤 `https://api.neuralwatt.com/v1` 로 연결한다. OAuth·포털 로그인은 없고 sk- 로 시작하는 API 키만 쓴다.
9.1. 한 줄 요약
지원한다. 다만 Hermes 코어 메뉴에 Neuralwatt가 기본 탑재돼 있지 않아, 공식 플러그인 설치 또는 custom_providers 수동 등록이 필요하다. 키만 넣고 config.yaml 만 바꿔도 동작하지만, /model·hermes status에 Neuralwatt가 뜨게 하려면 플러그인 방식이 권장된다.
9.2. 지원 수준
| 방식 | Hermes v0.15.1 | 설명 |
|---|---|---|
| Neuralwatt 공식 플러그인 | ✅ 권장 | neuralwatt-tools 레시피, /model·hermes status에 Neuralwatt 표시 |
| custom_providers (수동) | ✅ 가능 | config.yaml에 OpenAI 호환 endpoint 직접 등록 |
내장 native provider (hermes auth add neuralwatt) | ❌ 아직 없음 | GitHub 이슈 #48220 제안 단계 |
| OAuth / 포털 로그인 | ❌ | API 키(sk-...) 방식만 |
Hermes는 대시보드 URL 자체에 붙는 게 아니라 API 엔드포인트 `https://api.neuralwatt.com/v1` 를 쓴다. Billing에서 Energy-Based Pricing(전력 과금)을 켜 두면 이 글 앞부분의 비용 비교가 그대로 적용된다.
9.3. API 키 발급
- portal.neuralwatt.com 회원가입
- Dashboard > API Keys 에서 키 생성 (
sk-로 시작) - 모델 ID 확인: portal.neuralwatt.com/models 또는 `GET https://api.neuralwatt.com/v1/models`
9.4. 공식 연동 — 플러그인 방식 (권장)
데이터 폴더는 Windows 기준 C:\Users\사용자이름\.hermes-main\ 이다. Docker로 띄운 경우 컨테이너 안에서는 /opt/data 로 마운트된다. 사용자이름은 본인 Windows 계정명으로 바꾼다.
1) Hermes 중지 (Docker compose 사용 시)
docker compose -f <Hermes compose 파일 경로> stop hermes-main2) Neuralwatt 플러그인 설치
New-Item -ItemType Directory -Force -Path "$env:USERPROFILE\.hermes-main\plugins\model-providers\neuralwatt"Invoke-WebRequest -Uri "https://raw.githubusercontent.com/neuralwatt/neuralwatt-tools/main/recipes/hermes/plugin/__init__.py" -OutFile "$env:USERPROFILE\.hermes-main\plugins\model-providers\neuralwatt\__init__.py"Invoke-WebRequest -Uri "https://raw.githubusercontent.com/neuralwatt/neuralwatt-tools/main/recipes/hermes/plugin/plugin.yaml" -OutFile "$env:USERPROFILE\.hermes-main\plugins\model-providers\neuralwatt\plugin.yaml"공식 레시피: neuralwatt-tools/recipes/hermes
3) .env에 API 키 추가 — C:\Users\사용자이름\.hermes-main\.env
NEURALWATT_API_KEY=sk-여기에-키4) config.yaml 모델 설정 — C:\Users\사용자이름\.hermes-main\config.yaml
model:
  default: glm-5.2-fast
  provider: neuralwatt
일상 기본은 glm-5.2-fast, 어려운 추론은 glm-5.2 로 바꿀 수 있다.
5) 기동·확인
docker compose -f <Hermes compose 파일 경로> up -d hermes-maindocker run --rm -u hermes -v "$($env:USERPROFILE)\.hermes-main:/opt/data" --entrypoint hermes nousresearch/hermes-agent doctordoctor 출력에 Neuralwatt·모델 설정이 보이면 연결된 것이다.
9.5. 간단 설정 — 플러그인 없이 .env + config.yaml만
플러그인 설치를 건너뛰고 아래만 넣어도 API 호출은 된다. 다만 /model 메뉴에 Neuralwatt 프로바이더가 안 뜰 수 있어 처음 연결·모델 탐색에는 플러그인 방식이 낫다.
.env
NEURALWATT_API_KEY=sk-여기에-키config.yaml
model:
  default: glm-5.2-fast
  provider: neuralwatt
  base_url: https://api.neuralwatt.com/v1
저장 후 Hermes를 재시작한다.
9.6. 플러그인 없이 — custom_providers (수동)
config.yaml 예시:
custom_providers:
  - name: NeuralWatt
    base_url: https://api.neuralwatt.com/v1
    api_key: ${NEURALWATT_API_KEY}

model:
  default: glm-5.2-fast
  provider: custom
  base_url: https://api.neuralwatt.com/v1
  api_key: ${NEURALWATT_API_KEY}
Hermes 테스트 코드에도 이 패턴이 있다. 플러그인보다 설정이 번거롭고 /model UX가 약하다.
9.7. xAI Grok 등 다른 provider와의 관계
- Neuralwatt로 바꾸면
provider: neuralwatt+NEURALWATTAPIKEY를 쓴다. - xAI OAuth는 별도 — Neuralwatt 키와
.env에 동시에 둘 수 있지만, 활성 provider는config.yaml의model.provider하나다. Grok에서 Neuralwatt로 전환하려면model.provider·model.default를 neuralwatt·glm-5.2-fast 등으로 바꾼다.
9.8. 연동 방식 비교
| 질문 | 답 |
|---|---|
portal.neuralwatt.com/dashboard/keys 지원? | ✅ API 키 발급 후 Hermes에서 사용 가능 |
| Hermes 내장 메뉴에 Neuralwatt 있음? | ❌ v0.15.1 코어에는 없음 → 플러그인 또는 custom |
| OAuth 필요? | ❌ API 키만 |
/model 메뉴에 Neuralwatt 뜨게? | ✅ 공식 플러그인 설치 권장 |
대화 중 모델을 바꾸려면 /model <모델ID>, 영구 기본값은 /model glm-5.2-fast --global 처럼 --global 플래그를 쓴다. 지원 모델 ID는 대소문자·하이픈을 그대로 써야 한다.
9.9. 텔레그램에서 모델 설정하는 방법
Hermes 봇 채팅창에서 슬래시 명령과 인라인 버튼으로 모델을 바꿀 수 있다. API 키·Base URL을 미리 연결해 둔 뒤 아래 순서를 따르면 된다.
9.9.1. 방법 A — 메뉴로 고르기 (처음 할 때)
- 채팅에
/model을 입력한다. - Model Configuration 카드가 뜨면 Neuralwatt 프로바이더를 선택한다(모델 16개).
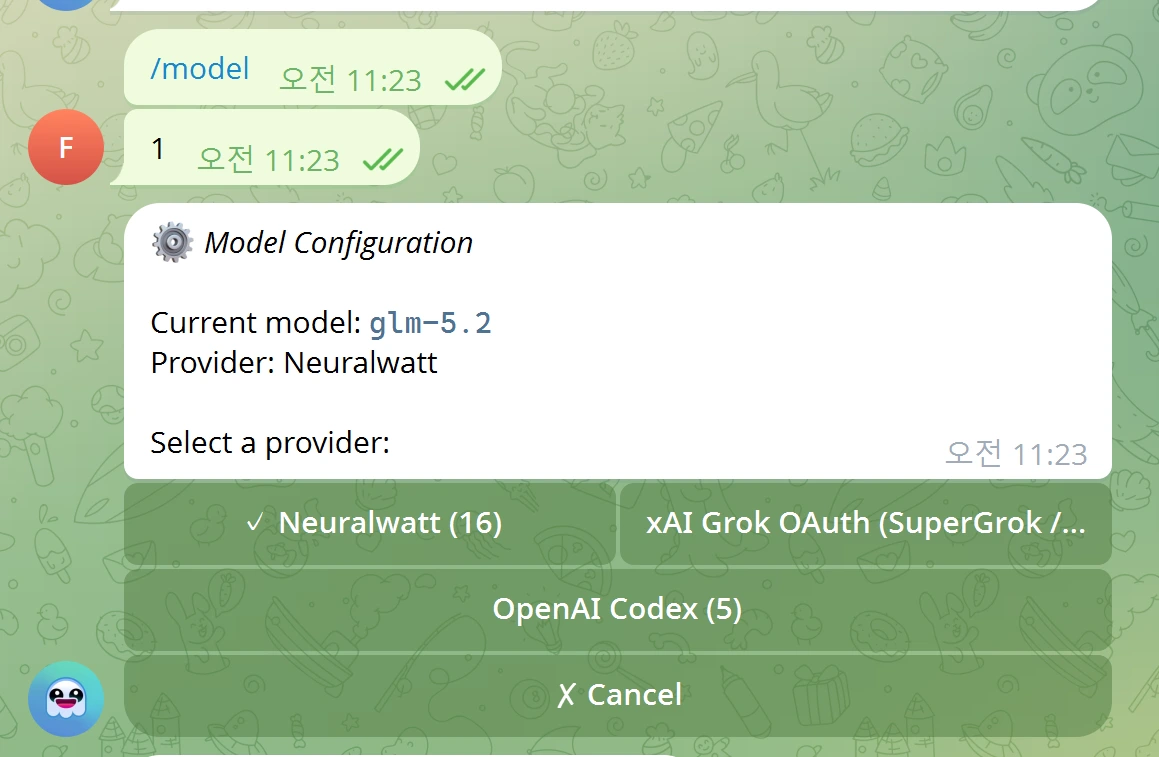
그림 18.
/model입력 → Model Configuration. Neuralwatt(16) 프로바이더가 선택된 상태. - 모델 목록 1/2에서 qwen·kimi·
glm-5.2(thinking ON) 등을 볼 수 있다. Next 로 다음 페이지로 넘긴다.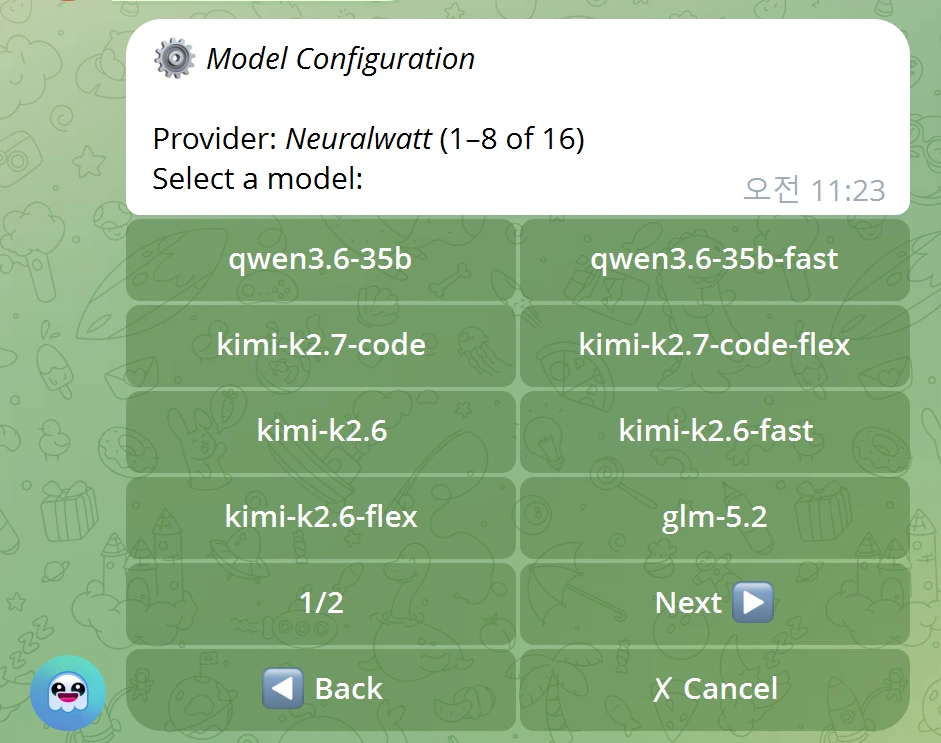
그림 19. Neuralwatt 모델 1~8/16 — qwen3.6-35b, kimi-k2.7-code, kimi-k2.6, glm-5.2(thinking ON) 등.
- 2/2 페이지에서
glm-5.2-fast를 누른다. 일상 기본 추천 모델이다.glm-5.2-flex·short 계열도 여기 있다.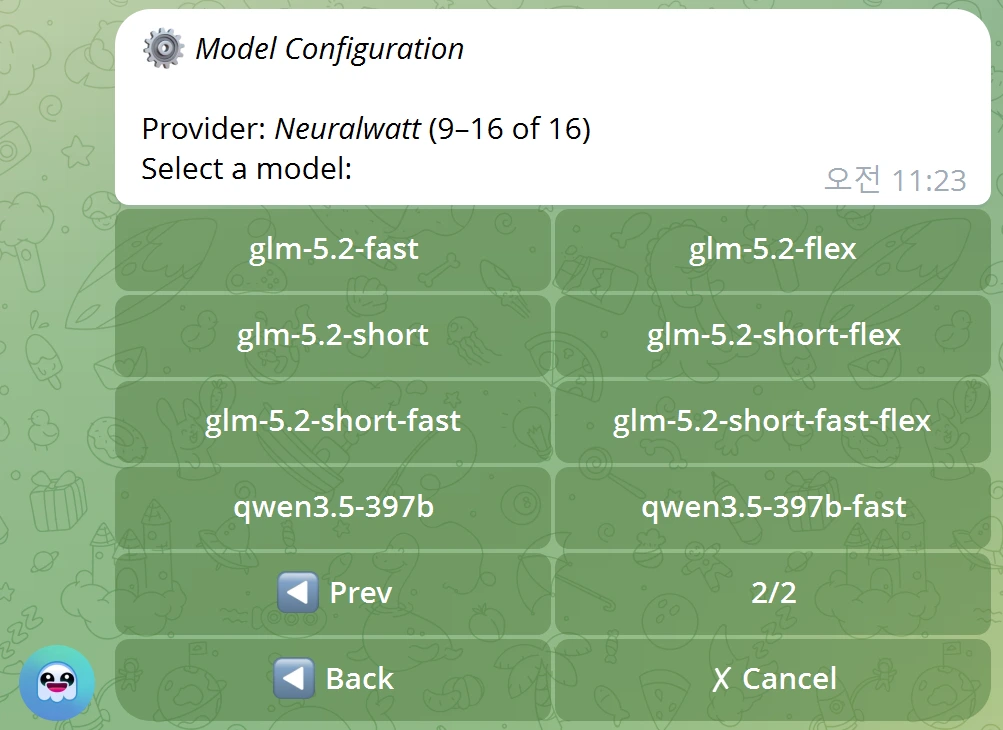
그림 20. Neuralwatt 모델 9~16/16 — glm-5.2-fast(일상 추천), glm-5.2-flex, short 계열, qwen3.5-397b.
- 선택이 끝나면 해당 대화부터 새 모델이 적용된다. Cancel 로 메뉴만 닫을 수 있다.
9.9.2. 방법 B — 명령어로 바로 지정 (익숙해지면 이게 빠름)
채팅에 모델 ID를 직접 적는다.
/model glm-5.2-fast영구 기본값으로 저장하려면 --global 을 붙인다.
/model glm-5.2-fast --global봇이 Provider·컨텍스트 한도·입출력 단가를 보여 주고, Saved to config (--global) 로 기본값이 저장됐음을 확인할 수 있다.
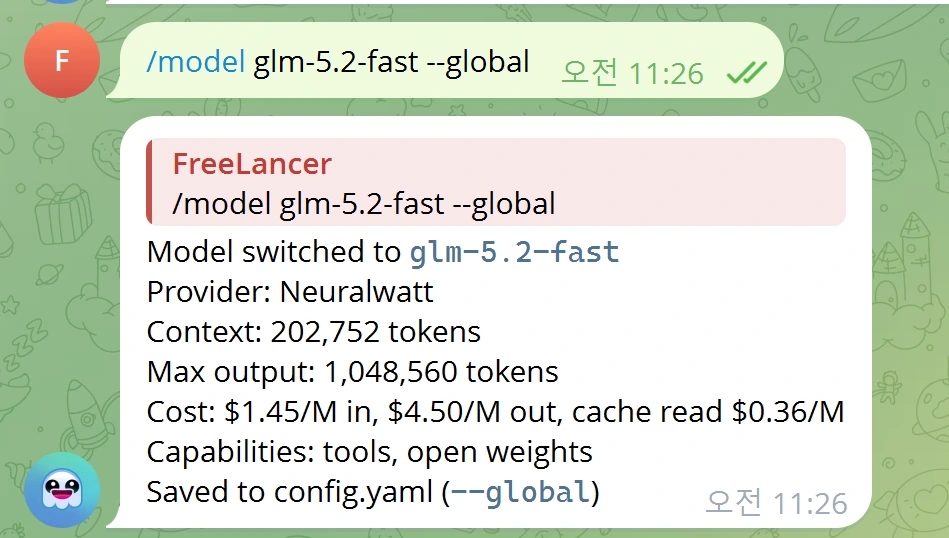 그림 21.
/model glm-5.2-fast --global — 모델 전환·입출력 단가 안내, --global로 기본값 영구 저장.
어려운 문제만 일시적으로 올릴 때:
/model glm-5.2코딩 위주로 쓸 때:
/model kimi-k2.7-code9.9.3. 메뉴 vs 명령어 — 언제 뭘 쓰나
| 상황 | 추천 |
|---|---|
| 처음 연결·모델 둘러보기 | /model 메뉴 (그림 18~20) |
| 매일 같은 모델 고정 | /model glm-5.2-fast --global (그림 21) |
| 한 번만 다른 모델 시험 | /model glm-5.2 (--global 없이) |
| 목록에 없는 조합 | `https://api.neuralwatt.com/v1/models` 에서 ID 확인 후 명령어 |
9.10. 용도별 추천 — 실전 패턴
| 용도 | 추천 모델 ID | 비고 |
|---|---|---|
| 일상 코딩·빠른 답변 (기본) | glm-5.2-fast | thinking OFF, 가성비 최고 |
| 막힌 버그·복잡한 설계 | glm-5.2 | thinking ON, 느리지만 깊음 |
| 코드 위주·리팩터링 | kimi-k2.7-code | 코딩 특화, 후보로 병행 |
| 단순 반복·라우팅 | qwen3.6-35b-fast | 최저 전력·단가 |
| 짧은 질문·가벼운 채팅 | glm-5.2-short-fast | 200K, 권한 있을 때 |
한 줄 요약: 평소 glm-5.2-fast, 안 풀리면 /model glm-5.2, 코드만 집중하면 kimi-k2.7-code.
/model glm-5.2-fast --global 로 영구 기본을 잡아두고, 어려운 질문만 일시적으로 glm-5.2로 올리는 패턴이 가장 효율적이다.
9.11. 모델 이름 읽는 법 (접미사)
| 접미사 | 의미 | 예시 |
|---|---|---|
| (없음) | thinking ON — 느리지만 깊은 추론 | glm-5.2 |
-fast | thinking OFF — 빠르고 저렴 | glm-5.2-fast |
-short | 컨텍스트 200K, 가벼운 질문용 | glm-5.2-short |
-flex | 지연 허용·저렴 티어 (아래 참고) | glm-5.2-flex |
같은 모델 계열에서 사고 ON/OFF 차이가 -fast 이다. -short는 컨텍스트 길이, -flex는 처리 우선순위·요금 티어다.
9.12. -fast vs -flex (헷갈리기 쉬움)
| 구분 | 바꾸는 것 | 예 |
|---|---|---|
-fast | thinking ON/OFF | glm-5.2-fast = 사고 끔, 일반 속도 |
-flex | 지연 허용 → 에너지(비용) 할인 | glm-5.2-flex = 대기해도 됨, 저렴 |
Neuralwatt 처리 티어는 대략 이렇게 나뉜다.
| 티어 | 의미 |
|---|---|
| Standard | 일반 동기 추론, 보통 속도 |
| Flex | 지연 허용 → 할인 (“Latency-tolerant inference at a discount”) |
| Express | 우선 처리, 프리미엄 |
| Enterprise | 전용 용량·SLA |
-flex는 모델 품질 등급이 아니라 “느려도 되니 싸게” 옵션이다. 기다려도 되면 싸고, 바로 답이 필요하면 flex가 아니다.
9.13. Hermes·텔레그램에서 flex 쓸까?
보통 비추천. 텔레그램 봇은 사용자가 기다리는 동안 이탈하기 쉽고, flex는 대기·지연이 생길 수 있다.
| 상황 | 선택 |
|---|---|
| 텔레그램 일상 대화 | glm-5.2-fast |
| 어려운 추론·설계 | glm-5.2 |
| 비용 줄이고 느려도 됨 (배치·cron·밤 작업) | glm-5.2-flex |
| flex가 목록에 없거나 애매 | 그냥 안 써도 됨 |
9.14. 지원 모델 한 줄 정리
GLM (ZhipuAI) — glm-5.2, glm-5.2-fast, glm-5.2-short, glm-5.2-short-fast, glm-5.2-flex(계정에 열려 있을 때)
Kimi (MoonshotAI) — kimi-k2.7-code(코딩), kimi-k2.6, kimi-k2.6-fast, kimi-k2.6-flex
Qwen — qwen3.6-35b, qwen3.6-35b-fast(최저가), qwen3.5-397b, qwen3.5-397b-fast(대형·무거울 수 있음)
9.15. Hermes 실전 팁
- 기본값 고정:
/model glm-5.2-fast --global로 매번 바꾸는 수고를 줄인다. - 단계적 승격: fast로 먼저 시도 → 답이 부족하면
/model glm-5.2한 번 더. - 코딩 에이전트 메인:
kimi-k2.7-code를 기본 후보에 넣고, GLM과 번갈아 비교해 본다. - 전력 과금 유지: Hermes도 호출마다 kWh가 나간다. 짧은 잡담에
glm-5.2(thinking ON)를 상시 쓰면 비용이 튄다. - rate limit: 텔레그램은 Cursor Agent만큼 동시 폭주하지 않아 Basic 티어도 버티는 경우가 많지만, cron으로 여러 작업을 겹치면 Standard 구독을 검토한다.
- flex는 배치용: RSS·리포트·야간 크롤링처럼 응답 시각이 중요하지 않은 작업에만 flex를 쓴다.
10. 무료 크레딧과 테스트 전략
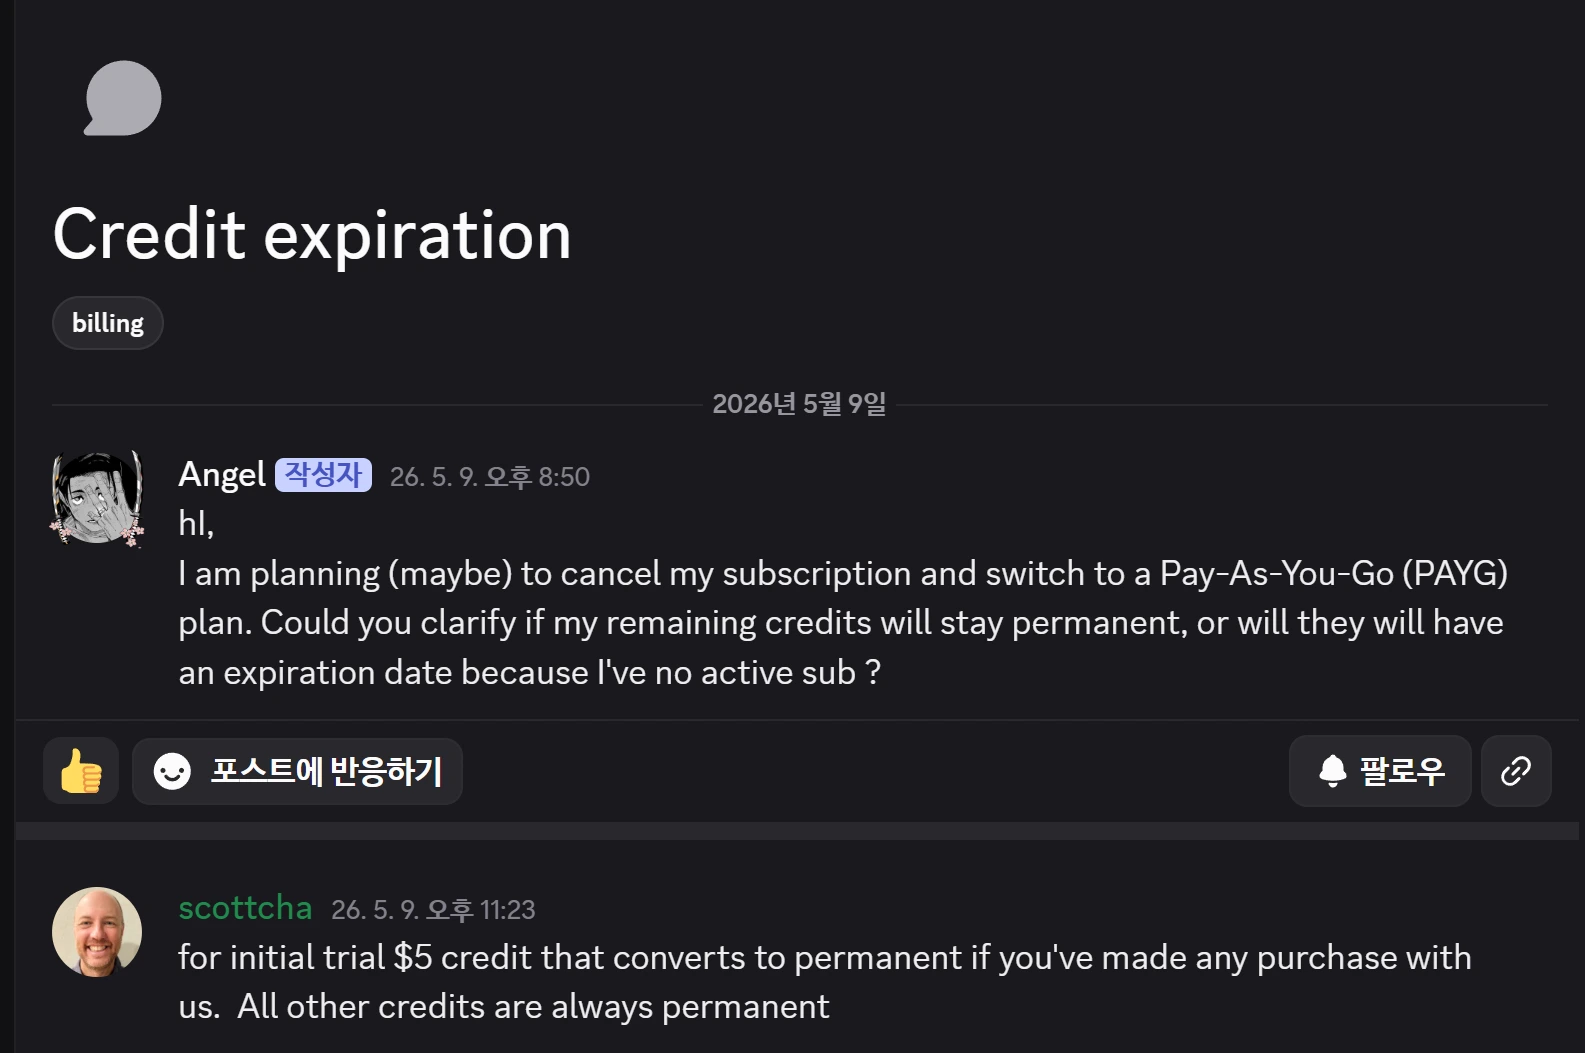 그림 22. Neuralwatt 커뮤니티(billing) — 구독 취소·PAYG 전환해도 충전 크레딧은 영구(permanent).
Neuralwatt는 가입 시 $1 무료 크레딧을 제공하고, 결제 수단을 등록하면 추가 $4를 더 줘 총 $5로 테스트할 수 있다. 무료 체험 등급은 분당 5회, 일당 50회 요청 제한이 있어 Agent 모드를 돌리기엔 부족하지만, Ask 모드에서 단건 요청으로 연결을 검증하기엔 충분하다.
가장 확실한 테스트 흐름은 이렇다.
받는 방법: portal.neuralwatt.com/auth/register 가입 → Billing에서 결제 수단 등록 시 추가 $4(합계 $5). 가입 페이지에 "하루 1만 토큰" 체험 문구가 있을 수 있다. referral 링크는 양쪽 보너스 구조지만 지급 불안정·프로그램 중단 불만이 Reddit에 여러 건 있다.
크레딧 vs 구독 에너지: 직접 충전한 계정 잔액은 이월·영구 보존(그림 22 FAQ)이고, 구독에 포함된 월간 kWh는 매달 소멸한다. 이 둘을 혼동하면 "충전했는데 왜 사라졌나" 오해가 생긴다.
먼저 $5 무료 크레딧으로 Ask 모드에서 연결이 되는지 확인한다. 대시보드 usage 리포트에서 실제 토큰당 mWh 소비량을 확인한다. 이 실측값을 앞선 비용 표에 대입하면 본인 워크로드 기준으로 Neuralwatt 종량제·구독·GLM 공홈 정액제 중 어느 쪽이 몇 배 유리한지 정확히 계산할 수 있다. 짧은 요청 위주면 토큰당 전력이 0.0344 mWh 수준으로 올라가고, 큰 요청 위주면 0.0106 mWh 수준까지 내려간다. 이 차이가 최종 비용을 3배가까이 갈라놓는다.
Reddit(r/opencode, r/ZaiGLM) 후기를 종합하면 평가가 극명하게 갈린다. 긍정 측은 GLM-5.2로 7,300만 토큰을 쓰고 $8밖에 안 나왔다거나, 모델을 몰래 양자화(다운그레이드)하지 않는다는 점을 높이 평가한다. 부정 측은 피크 시간대(UTC 저녁) 속도 저하·524 타임아웃·불안정성을 지적한다. Basic은 priority access가 없어 혼잡 시 더 느릴 수 있고, Standard부터 priority, Pro는 highest priority와 전용 자원이 붙는다.
11. Reddit·커뮤니티 후기 — 가격은 인정, 속도는 논쟁
2026년 6월경 r/opencode, r/ZaiGLM 등에서 Neuralwatt가 화제가 됐고 평가가 갈렸다.
긍정
- GLM-5.2로 7,300만 토큰 $8, 148M 토큰 후 $20 구독 등 가격 경쟁력에 대체로 동의
- OpenCode Go의 nvfp4 양자화 의혹과 달리 Neuralwatt는 FP8 표준을 명시한다는 신뢰
- short·flex(대기열) 모델로 40~50% 추가 절감 후기
- CTO가 Discord에서 밤새 이슈를 챙긴다는 지원 진정성 언급
- 주간/시간당 토큰 리밋이 없다는 점(정액제 대비)
부정
- 가입 전엔 빠르다가 구독 후 90% 느려졌다, 프롬프트당 10분, 524 타임아웃
- 무료 크레딧 하이프 후 1M→200K 컨텍스트 제한 등 불안정 지적
- referral 링크 광고성 도배(astroturfing) 의심 — 보너스 미지급·프로그램 down 불만
- 한 유저 순위: Neuralwatt < OpenCode Go < Ollama Cloud
종합하면 "잘 될 땐 가성비 최고, 피크(UTC 저녁)엔 답답함"이다. 무료 $5로 테스트 후 PAYG로 안정성을 확인하고 구독을 결정하라는 의견이 많다.
12. 상황별 선택표
| 상황 | 추천 | 이유 |
|---|---|---|
| 월 1억 토큰 이하, 큰 요청 위주 | Neuralwatt PAYG 또는 Basic | 종량제로도 몇천 원~2만 원 수준 |
| 월 10억 토큰 전후, 안정적 사용 | Neuralwatt Standard 또는 GLM 공홈 Pro | 손익분기점 부근, 둘 다 비슷 |
| 월 40억 토큰 이상 꽉 채워 사용 | GLM 공홈 Max($112) | 정액제 단가가 가장 낮음 |
| Cursor Agent 본격 사용 | Neuralwatt Pro($100) 이상 | 10 슬롯 이상 필요 |
| 요청이 들쭉날쭉 | Neuralwatt PAYG | 구독 에너지 소멸 방지 |
| 최고 성능 우선 | Grok 4.5(Cursor·API) | 벤치마크 근소 우위 |
| 캐시 90%+ 동일 프로젝트 | Neuralwatt PAYG | 실측 0.00672 mWh/토큰, 월 1억 약 $3.4 |
| 단순 반복·라우팅 대량 | qwen3.6-35b-fast | 전력·토큰 단가 모두 최저 |
| Cursor Agent + Neuralwatt | 비추천(기본) | 3 slots로 부족, OpenCode·CLI 권장 |
| GLM 공홈 Max 한도 50%만 사용 | Neuralwatt Standard | Max 실질 단가 $0.056/M로 역전 가능 |
| Hermes·텔레그램 일상 | glm-5.2-fast (--global) | 즉시 응답·저렴, flex 비추 |
| Hermes 어려운 추론 | glm-5.2 | fast로 안 풀릴 때만 |
| Hermes 배치·cron·야간 | glm-5.2-flex | 느려도 됨·비용 절감 |
한 가지 명심할 점은, GLM-5.2와 Claude·Grok은 모델 자체의 성능·품질이 다르다는 것이다. 단순히 “같은 작업을 더 싸게”가 아니라 “다른(더 저렴한) 모델로 갈아타는 것”에 가깝다. 코딩 품질이 GLM-5.2로 충분한지 같은 작업을 두 모델로 돌려 직접 비교해보는 게 가장 확실하다.
13. 마무리
앞에서 다룬 Neuralwatt 에너지 과금과 GLM-5.2 조합의 핵심만 짧게 정리한다.
- 과금 기준이 토큰 수가 아니라 GPU 전력 소비(kWh)라는 점이 비용 절감의 출발점이다. 큰 요청을 배치로 몰아 처리할수록 토큰당 전력 효율이 좋아진다.
- 월 1억 토큰 기준 에너지 과금은 약 $5~17 수준으로, 토큰 과금($175) 대비 최대 95%까지 저렴하다.
- Neuralwatt 구독 플랜은 종량제 대비 33~39% 할인된 kWh 단가를 제공하지만, 월 에너지 한도는 이월되지 않는다.
- 손익분기점은 월 10억 토큰 전후다. 그 이하는 Neuralwatt가, 이상은 GLM 공홈 Max 정액제가 근소하게 유리하다.
- Cursor Agent 모드는 동시 요청 슬롯이 많이 필요하다. Basic(3 슬롯)으로는 부족하고 Standard($50, 5 슬롯) 이상이 안정적이다.
- 모델 ID와 Base URL을 정확히 맞춰야 한다.
/v1까지만 넣고 모델명은 소문자·하이픈 그대로(glm-5.2-fast) 입력한다. - GLM-5.2는 오픈웨이트라 저렴하지만 Grok 4.5 등 프론티어 모델과 성능 차이가 있다. 비용 절감이 우선인지 코딩 품질이 우선인지 먼저 정하라.
- Neuralwatt는 초기 스타트업이라 피크 시간대 속도·안정성 변동이 있다. 무료 $5 크레딧으로 본인 워크로드를 직접 측정한 뒤 구독을 결정하는 게 안전하다.
- 본문의 단가·한도·벤치마크 수치는 2026년 6~7월 기준이며, 서비스 정책이 바뀔 수 있으니 가입 시점에 공식 페이지에서 최신 값을 확인해야 한다.
- 캐시율 98% 실측 워크로드에서는 토큰당 0.00672 mWh까지 내려가 월 1억 토큰이 약 $3.4 수준이다. 프로젝트를 옮기면 이 수치는 올라간다.
- 전력 과금 최저 모델은 qwen3.6-35b-fast이나, 코딩은 glm-5.2-fast가 성능·비용 균형이 좋다.
- Neuralwatt 구독(Basic~Standard)은 GLM 공홈 Lite·Pro 대비 단가 1.5~1.8배 유리할 수 있고, Max(40억)만 근소하게 앞선다.
- Reddit 후기는 가격·FP8 정직성은 인정하나 피크 속도·referral 신뢰 문제를 지적한다.
- Hermes는 glm-5.2-fast 기본, 어려울 때 glm-5.2, 코드 집중은 kimi-k2.7-code. flex는 텔레그램이 아니라 배치·cron용이다.
「에너지 과금은 토큰이 아니라 GPU 점유 시간에 비용을 묻는다」 — 큰 요청을 한 번에 처리하고 동시성에 맞는 티어를 고르면, 같은 모델로도 비용을 극단적으로 줄일 수 있다. 본인의 실제 요청 패턴을 대시보드에서 한 달 관찰한 뒤, 그 수치에 맞춰 종량제·구독·공홈 정액제 중 하나를 선택하는 게 가장 정확한 결정이다.
자주 묻는 질문
- Neuralwatt의 에너지 과금은 토큰 과금과 어떻게 다른가요?
토큰 과금은 토큰 수에 비례해 요금을 매기지만, Neuralwatt는 요청이 실제로 소비한 GPU 전력량(kWh)을 측정해 청구한다. 같은 작업이라도 GPU 점유 시간이 짧으면 요금이 낮아지므로, 큰 요청을 배치로 몰아서 처리할수록 토큰당 비용이 크게 떨어진다. 종량제 기본 요율은 $5/kWh이며 모델에 관계없이 동일하게 적용된다.
- GLM-5.2는 Grok 4.5와 비교해 성능이 어떤가요?
2026년 7월 기준 코딩 벤치마크에서 Grok 4.5가 근소하게 앞선다. SWE-bench Pro 64.7% vs 62.1%, DeepSWE 1.1 53% vs 44%, Terminal Bench 2.1 83.3% vs 81.0%로 Grok 4.5가 세 항목 모두 우위지만 격차가 압도적이지는 않다. 다만 GLM-5.2는 오픈웨이트(MIT 라이선스)라 단가가 더 낮고, Grok 4.5는 환각률이 크게 올랐다는 지적이 있어 코드 검증 없이 맹신하면 위험하다.
- 월 1억 토큰을 쓰면 비용이 얼마나 나오나요?
GLM-5.2 기준 에너지 과금으로 큰 요청(64K~256K 구간) 위주면 약 $5, 짧은 요청 위주면 약 $17 수준이다. 같은 양을 토큰 과금으로 쓰면 약 $175가 되므로, 최대 95%까지 절감된다. 정확한 비용은 본인의 요청 크기 분포에 따라 달라지므로 대시보드에서 실제 토큰당 mWh를 확인하는 게 가장 확실하다.
- Neuralwatt 구독 플랜과 GLM 공홈 정액제 중 뭘 선택해야 하나요?
월 10억 토큰 전후가 손익분기점이다. 그 이하면 Neuralwatt 종량제나 Basic($20) 구독이 유리하고, 그 이상 안정적으로 쓴다면 GLM 공홈 Max($112, 연간 결제 시 30% 할인)가 근소하게 유리하다. 단 GLM 공홈은 주간 리밋이 있고 Neuralwatt 종량제는 리밋 없이 계속 쓸 수 있다는 차이가 있다. 사용량이 들쭉날쭉하면 구독 에너지가 매달 소멸되므로 종량제가 안전하다.
- Cursor에서 Neuralwatt를 연결할 때 Base URL은 어떻게 설정하나요?
Cursor Settings → Models → API Keys에서 Override OpenAI Base URL을 켜고 https://api.neuralwatt.com/v1 까지만 입력한다. 뒤에 /chat/completions까지 붙이면 경로가 중복돼 에러가 날 수 있다. OpenAI API Key 칸에는 Neuralwatt에서 발급받은 키를 넣고, Anthropic 키 칸은 비워둔다. 모델 ID는 glm-5.2, glm-5.2-fast처럼 소문자·하이픈 그대로 정확히 입력해야 한다.
- Cursor Agent 모드에서 Rate Limit Exceeded 에러가 뜨는 이유는?
Neuralwatt의 티어별 동시 요청 슬롯 제한 때문이다. Basic 티어는 3 슬롯만 주어지는데, Cursor Agent는 한 작업에서 수십 회의 동시 요청을 쏘아내므로 이 한도를 순식간에 초과한다. 크레딧이 있어도 티어의 동시성 한도가 낮아서 생기는 문제로, 결제나 설정이 잘못된 게 아니다. Ask(Chat) 모드에서는 3 슬롯으로도 충분히 작동하며, Agent를 본격적으로 돌리려면 Standard($50, 5 슬롯) 이상 구독으로 올려야 한다.
- Neuralwatt 무료 크레딧은 어떻게 받나요?
가입 시 $1 무료 크레딧을 받고, 결제 수단을 등록하면 추가 $4를 더 받아 총 $5로 테스트할 수 있다. 무료 체험 등급은 분당 5회, 일당 50회 요청 제한이 있어 Agent 모드로 돌리기엔 부족하지만, Ask 모드에서 단건 요청으로 연결과 요청당 전력 소비를 검증하기엔 충분하다. 이 실측값을 비용 계산에 대입하면 본인에게 가장 유리한 요금제를 정확히 고를 수 있다.
- Neuralwatt의 단점이나 주의할 점은 무엇인가요?
초기 스타트업이라 피크 시간대(UTC 저녁) 속도 저하·524 타임아웃·서버 과부하가 간헐적으로 보고된다. Reddit 후기에서도 가격 경쟁력은 인정하면서도 안정성을 걱정하는 목소리가 있다. Basic 티어는 priority access가 없어 혼잡 시 더 느릴 수 있고, Standard부터 priority, Pro는 highest priority와 전용 자원이 붙는다. GLM-5.2 자체도 프론티어 모델 대비 성능이 근소하게 낮으므로, 코딩 품질이 본인 기준에 맞는지 소액으로 먼저 검증하는 게 안전하다.