 테크·IT
코딩 에이전트 시대에는 프롬프트·샌드박스·옵트아웃 UI만으로는 부족하다. 네트워크단 검증이 기본 점검 항목이 된 사건으로 보면 된다. 2026년 7월, 보안 연구자 cereblab이 xAI Grok Build CLI(버전 0.2.93)의 TLS 트래픽을 열어 공개한 내용은 그 전환점을 구체적 숫자로 보여 준다. 모델이 실제로 읽은 양과 저장소 전체가 별도 채널로 올라간 양이 수천 배 차이 났고, 「모델 개선」을 꺼도 업로드는 계속됐다.
12GB 규모 테스트 저장소에서 모델 대화 채널(/v1/responses)은 약 192KB만 오갔다. 같은 세션의 저장 채널(/v1/storage)로는 약 5.1GB가 Google Cloud Storage 버킷 grok-code-session-traces로 올라갔다. 프롬프트에 「파일 열지 마」라고 적어도, 추적된 Git 저장소가 git bundle로 패키징되어 서버가 HTTP 200으로 받은 기록이 남았다. 번들을 복원하면 에이전트에게 읽지 말라고 한 카나리 파일과 커밋 이력까지 그대로 나왔다.
분석이 공개된 다음 날(7월 13일) 같은 클라이언트에서 서버가 disablecodebaseupload: true, traceuploadenabled: false를 돌려주며 업로드가 관측되지 않았다. 다만 xAI의 공식 보안 공지·수집분 삭제 계획은 확인되지 않았고, 서버 토글은 언제든 다시 바뀔 수 있다. 그래서 지금 필요한 질문은 「벤더가 껐다고 했나」가 아니라 「내 머신·내 조직 이그레스에서 통째 업로드가 실제로 막혀 있나」다.
국내에서는 Threads choi.openai 공유로 AI·개발 커뮤니티에 빠르게 퍼졌고, GeekNews 토픽에도 와이어 분석 요지가 정리됐다. 해외에서는 International Cyber Digest 보도와 Reddit r/LocalLLaMA 토론에서 「옵트아웃이 업로드를 끄지 않는다」「네트워크로 검증하라」는 반응이 이어졌다. 1차 증거는 cereblab gist와 재현 레포에 있다.
이 글은 그 증거를 바탕으로 무슨 일이 있었는지, AI 개발사가 코드·세션을 탐내는 유인과 유사 사례, 윈도우·프록시에서 이상 트래픽을 어떻게 잡는지, 옵트아웃을 넘어 로컬 설정·이그레스·조직 정책으로 어떻게 막는지를 정리한다. 테스트는 반드시 가짜 카나리 시크릿만 넣은 더미 저장소에서 하고, 실제 회사 코드로는 확인이 끝날 때까지 붙이지 않는 편이 안전하다.
1. 무엇이 확인됐나
연구자가 쓴 방법은 본인 머신에서 본인 트래픽을 mitmproxy로 복호화하는 방식이다. Grok CLI는 인증서 피닝을 하지 않아 OS 신뢰 저장소에 CA만 넣으면 TLS를 열 수 있다. 대상 바이너리는 grok 0.2.93이며, 문자열 추출에서 xai-data-collector, grok-code-session-traces, storage.googleapis.com 같은 흔적이 확인됐다.
| 항목 | 관측 내용 |
|---|---|
| 클라이언트 | Grok Build CLI 0.2.93 (소비자 로그인) |
| 모델 채널 | POST cli-chat-proxy.grok.com/v1/responses |
| 저장 채널 | POST .../v1/storage (+ multipart init) |
| GCS 버킷 | grok-code-session-traces (presigned PUT 경로 포함) |
| 12GB 테스트 | 모델 ~192KB vs 저장 ~5.1GB (약 27,800배) |
| 결정적 증거 | 캡처된 git bundle을 git clone하면 never-read 카나리 복원 |
| 시크릿 | 추적된 .env 카나리 값이 요청 바디에 평문 |
핵심 포인트: 이 분석은 전송·수락·저장을 증명한다. xAI가 그 코드로 모델을 학습했는지, 직원이 열람했는지는 별개 정책 문제다. 반대로 「어차피 클라우드 AI는 다 가져간다」로 뭉개면, 재현 가능한 통째 업로드와 필요 컨텍스트만 보내는 추론을 구분하지 못하게 된다.
입증 범위의 한계도 같이 적는다. .gitignore된 파일이 번들에 항상 포함되는지는 연구자도 완전 검증하지 않았다. 엔터프라이즈·API 키·ZDR 계정이 소비자와 동일한지는 공개 캡처만으로 확정할 수 없다. 그래도 추적된 저장소 + 전체 히스토리가 별도 채널로 나간 사실은 번들 복원으로 고정된다.
2. 국내·해외에서 퍼진 경로
소식이 한 갈래로만 돌지 않았다. 출처를 역할별로 나누면 검증·공유·해설이 겹치지 않는다.
| 출처 | 역할 | 링크 |
|---|---|---|
| cereblab gist / 재현 레포 | 와이어 증거·재현 스크립트 | gist · exfil-repro |
| International Cyber Digest | 영문 요약·서버 플래그 후속 | ICD 기사 |
Threads choi.openai | 국내 AI 스레더가 요지 공유 | 공유 스레드 |
| GeekNews | 국내 기술 뉴스 아카이브 | 토픽 31375 |
| Reddit r/LocalLLaMA | 개발자·로컬 LLM 커뮤니티 토론 | 게시물 |
GeekNews 정리본도 gist와 같은 골격을 따른다. 두 채널 분리, 12GB 비율, 옵트아웃 무력화, 「학습 사용 여부는 미입증」 한계를 함께 적었다. Reddit 쪽 반응은 「로컬 퍼스트」 마케팅과 통째 번들 업로드의 간극, 옵트아웃 UI를 데이터 최소화 스위치로 착각하면 안 된다는 쪽으로 모이는 편이다. ICD는 공개 다음 날 서버 플래그로 업로드가 관측되지 않았다는 후속까지 짧게 묶어 두었다.
3. 두 채널의 의미
클라우드 코딩 에이전트는 원격 모델에 컨텍스트를 보내야 한다. 문제는 읽은 파일만 가는지, 작업과 무관한 스냅샷까지 가는지다.
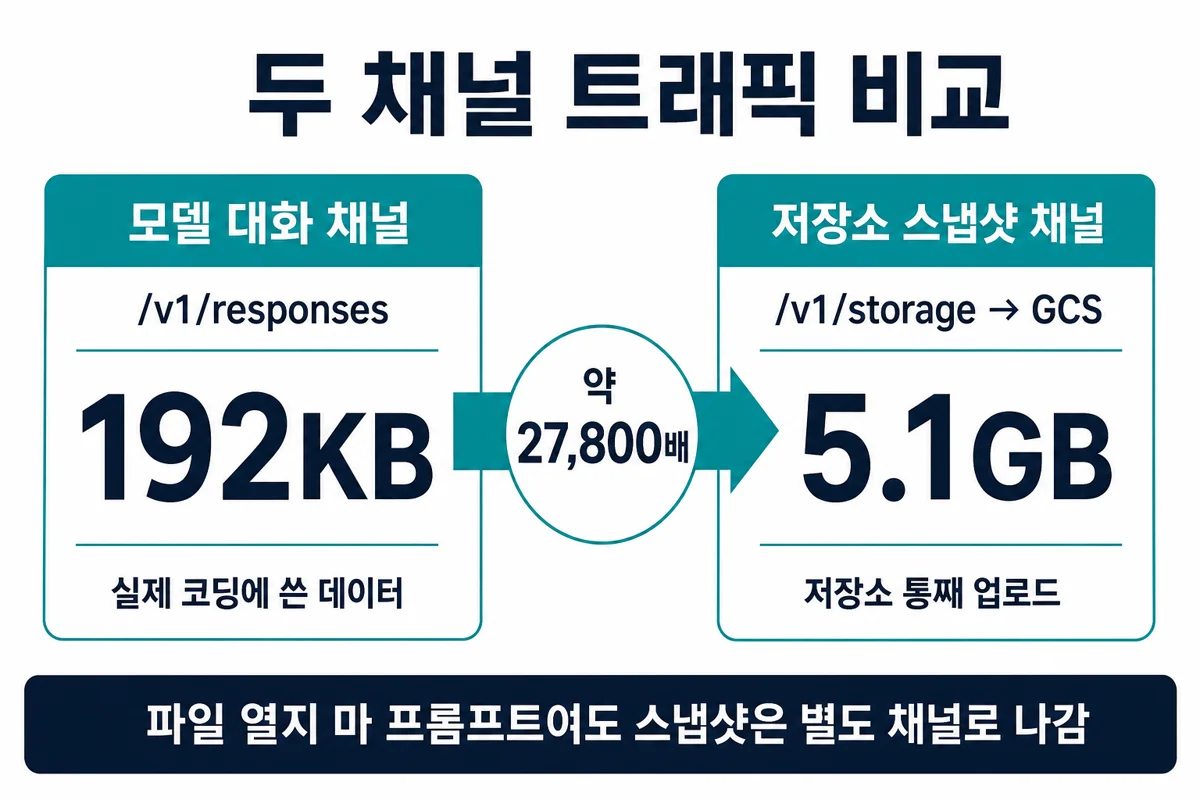 그림 1. 모델 대화 채널 192KB와 저장소 스냅샷 채널 5.1GB — 채널 간 바이트 비율이 판별 핵심이다.
3.1. 모델 대화 채널
/v1/responses로 프롬프트·에이전트가 연 파일 내용이 실린다.- 에이전트가
.env를 읽으면 값이 평문으로 실릴 수 있다. 카나리APIKEY/DBPASSWORD가 그대로 잡혔다. - 「파일 열지 마」 제어 실험에서는 읽지 않은 파일 마커가 이 채널 바디에 안 나왔다. 즉 이 채널은 읽기 행위에 가깝다.
3.2. 저장소 스냅샷 채널
/v1/storage로 git bundle·세션 아카이브가 올라간다.- 목적지는 GCS
grok-code-session-traces로 메타데이터·바이너리 문자열에 명시된다. - 「파일 열지 마」여도 번들을 복원하면 never-read 카나리가 그대로다. 읽기 권한과 무관하게 추적 저장소 스냅샷이 나간다.
- 대용량에서는 청크(~75MB) 다수가 200으로 수락됐다. 모델 쪽 쿼터(402/429)와 별개로 저장 업로드는 이어졌다.
연구자가 처음에 놓치기 쉬운 지점도 있다. GCS로 가는 presigned PUT은 API 호스트를 안 거치고 Google IP로 직접 나갈 수 있다. grok PID만 필터하면 업로드 코디네이터 프로세스를 놓친다. 호스트·볼륨 기준으로 봐야 한다.
| 구분 | /v1/responses | /v1/storage |
|---|---|---|
| 역할 | 모델 턴·추론 컨텍스트 | 세션/저장소 아티팩트 |
| 「열지 마」 시 | 읽지 않은 파일은 보통 안 실림 | 번들에 never-read 포함 가능 |
| 바이트 스케일 | 프롬프트·연 파일에 비례 | 저장소 크기에 비례할 수 있음 |
| 옵트아웃 | 학습 동의와 별개 | 당시 traceuploadenabled: true 유지 |
4. 옵트아웃이 막지 못한 이유
소비자 FAQ의 「Improve the model / 모델 개선」은 새 대화를 학습에 쓸지에 가깝다. 원격 추론 자체나 저장소 스냅샷을 끈다고 약속하지 않는다. 캡처된 설정 응답에는 traceuploadenabled: true, upload_enabled: true가 남아 있었고, 토글을 꺼도 번들 업로드가 진행됐다. ICD·GeekNews·Reddit 토론에서 반복되는 문장도 같다. 옵트아웃 ≠ 업로드 끔.
| 통제 축 | 묻는 질문 | 당시 소비자 UI만으로 |
|---|---|---|
| 학습 옵트아웃 | 이 내용으로 미래 모델을 개선해도 되나 | 「모델 개선」 토글이 담당 |
| 추론 컨텍스트 | 이 질문에 답하려면 어떤 파일을 보내야 하나 | 작업에 따라 전송됨 |
| 세션/트레이스 | 디버깅·재개를 위해 무엇을 보관하나 | 별도 플래그·서버 설정 |
| 저장소 스냅샷 | 전체 히스토리를 클라우드에 둘까 | 옵트아웃으로 안 꺼짐(캡처 시점) |
| 보존·삭제 | 아티팩트는 얼마나 남고 어떻게 지우나 | 공개 공지 부족 |
제품이 이 축을 한 UI 스위치로 섞어 두면, 사용자는 「데이터 수집을 껐다」고 착각한다. Grok Build 퀵스타트는 프로젝트 디렉터리에서 에이전트를 돌리라고 안내하면서, 설치 흐름에서 저장소 통째 git bundle 업로드를 전면에 두지 않았다(연구자·이차 보도 기준). 문서 공백이 신뢰를 깨는 지점이다.
5. 공개 다음 날 서버 플래그
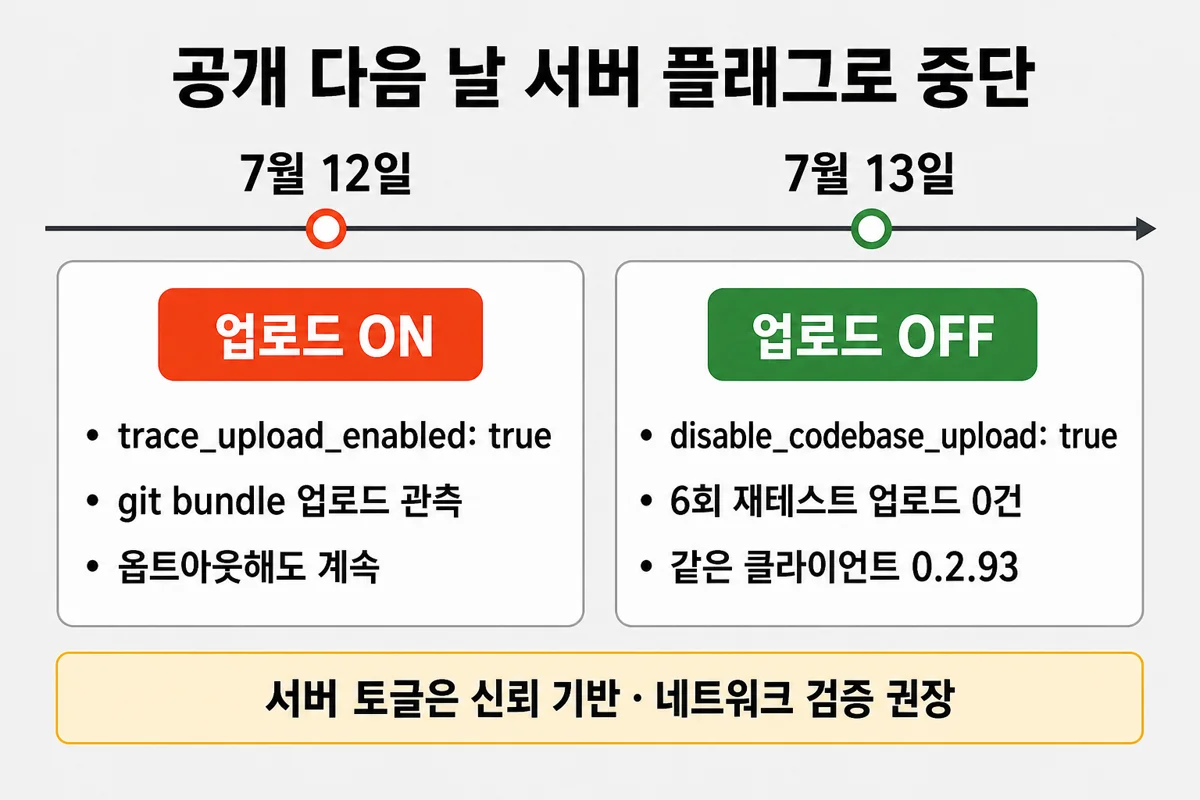 그림 2. 7월 12일 업로드 ON → 7월 13일 서버 플래그로 OFF. 클라이언트 버전은 동일하다.
| 상태 | 7월 12일 캡처 | 7월 13일 재테스트 |
|---|---|---|
| 클라이언트 | 0.2.93 | 동일 0.2.93 |
traceuploadenabled | true | false |
disablecodebaseupload | 없거나 미활성 | true |
/v1/storage 저장소 업로드 | 관측·번들 확보 | 6회 재테스트에서 0건 |
| xAI 공식 설명 | 없음 | 없음(확인 범위) |
바이너리가 안 바뀌었으므로 차이는 서버가 내려주는 설정으로 보는 게 타당하다. ICD 후속 정리도 같은 표를 강조한다. 한 계정·한 머신 검증이라 전 세계 동일 배포인지는 단정할 수 없다. 이미 grok-code-session-traces에 쌓인 데이터의 삭제·보존도 공지되지 않았다. changelog에 0.2.98이 올라와도 저장소 업로드 행동을 언급하지 않았다면, 버전 번호만으로 「안전」을 선언하기 어렵다.
6. AI 개발사는 왜 이런 수집을 감행하나
Grok 사건에서 증명된 것은 전송·수락·저장이다. 「그래서 학습에 썼다」까지는 cereblab도 입증하지 않았다. 그래도 업계가 코드·세션·저장소를 탐내는 구조적 이유는 논문·벤치마크·요금제·유사 정책에서 반복적으로 드러난다. 아래는 그 유인과 유사 사례를 정리한 유추다. 유추 ≠ 해당 회사의 내부 의도 확정이다.
6.1. 학습에 코드가 중요한 이유
코딩 모델은 웹 텍스트만으로 「문장처럼 보이는 코드」는 잘 만들지만, 저장소 안에서 이슈를 고치고 테스트를 통과시키는 에이전트는 다른 종류의 데이터를 요구한다.
| 데이터 종류 | 모델이 배우는 것 | 한계 |
|---|---|---|
| 공개 GitHub 정적 파일 | 문법·관용구·API 패턴 | 「완성된 결과물」만 보고, 디버깅 과정이 빠짐 |
| 이슈·PR·패치 쌍 (SWE-bench류) | 문제 서술 → 수정 패치 | 규모가 수백~수천 단위로 작고, 오염·유출 이슈 |
| 실행 가능 환경 + 테스트 보상 (SWE-Gym 등) | 시도·실패·재시도 궤적 | 환경 재현·라벨 비용이 큼 |
| 실제 IDE/CLI 상호작용 | 수용·수정·거절, 커서 주변, 탐색 순서 | 개인·기업 코드·시크릿이 섞이기 쉬움 |
| 저장소 스냅샷·히스토리 | 멀티파일 의존성, 과거 커밋, 리팩터 맥락 | 통째 업로드 시 동의·최소화 원칙과 충돌 |
연구 쪽에서는 「정적 코드만으로는 에이전트 추론이 부족하다」는 진단이 반복된다. SWE-Gym(에이전트·검증기 학습용 실행 환경), SWE-rebench(GitHub에서 대화형 SWE 과제를 대량 추출), RepoForge(커밋·빌드·테스트를 자동 재구성해 SFT·RL 파이프라인에 넣는 시도) 등은 모두 실행·궤적·보상이 병목이라고 본다. 공개 벤치만으로는 수만 건의 상호작용을 만들기 어렵고, 수동 라벨은 비싸다. 그래서 제품 회사 입장에서는 이미 매일 돌고 있는 코딩 에이전트 트래픽이 가장 값싼 「실세계 궤적」 후보가 된다.
GitHub이 2026년 3월 공식 블로그에서 Copilot 상호작용 데이터를 모델 개선에 쓰겠다고 밝힌 논리도 같은 축이다. 공개 데이터·수작업 샘플만으로는 부족했고, Microsoft 직원 상호작용을 넣자 수용률이 올랐다는 식의 서사다. 수집 예시에 프롬프트, 수락·수정된 출력, 커서 주변 코드, 파일명·저장소 구조·탐색 패턴, 피드백이 포함된다. 「저장소 at rest 전체를 긁는다」고 쓰진 않았지만, 활성 사용 중 private 저장소 컨텍스트는 상호작용으로 잡힐 수 있다고 명시했다. Free/Pro/Pro+는 옵트아웃, Business/Enterprise는 제외 — 개인·저가 구간이 학습 연료, 유료 조직은 예외라는 요금제 설계가 드러난다.
6.2. 통째 저장소·세션 트레이스가 스니펫보다 「비싼」 이유
에이전트 경쟁은 한 줄 자동완성에서 멀티파일 리팩터·테스트 루프·도구 호출로 옮겼다. 스니펫만으로는 부족하고, 아래 신호가 학습·평가·제품 개선에 직결된다.
- 의존성 그래프: 한 파일이 아니라 import·설정·CI·테스트가 묶인 상태.
- 시간축: 커밋 히스토리는 「지금 코드」뿐 아니라 리팩터·되돌리기·보안 패치 궤적을 준다. Grok 캡처에서 히스토리까지 번들에 들어간 점이 민감한 이유다.
- 에이전트 궤적: 어떤 도구를 불렀는지, 어디서 막혔는지, 사용자가 수락했는지 — RL·증류·실패 분석용.
- 신선도: 공개 벤치는 오염되기 쉽다. 제품 세션은 컷오프 이후의 「새 코드」를 지속적으로 공급한다.
- 디버깅·품질: 학습이 아니라도 세션 트레이스는 장애 재현·프롬프트 개선·할당량 분석에 쓰인다. 「모델 개선 옵트아웃」과 「트레이스 업로드」가 갈라진 Grok 설정이 바로 그 혼선을 보여 준다.
핵심 포인트: 스니펫은 자동완성에, 저장소·세션은 에이전트에 가깝다. 제품이 에이전트로 갈수록 수집 유인도 「지금 연 파일」에서 「작업 공간 전체」로 커진다. 그렇다고 통째 업로드가 정당해지는 것은 아니다. 데이터 최소화·명시 동의·경로별 문서화가 더 중요해질 뿐이다.
6.3. 제품·경쟁·요금제가 만드는 유인
유추 가능한 동기를 한곳에 모으면 아래와 같다. Grok에 대해 각각이 「입증」된 것은 아니다.
| 유인 | 설명 | 관찰되는 패턴 |
|---|---|---|
| 벤치마크 경쟁 | SWE-bench류 점수가 마케팅·투자 서사가 됨 | 실세계 궤적·실행 데이터 수요 증가 |
| 기본값의 힘 | 대부분 사용자는 옵트아웃을 안 건드림 | 옵트인→옵트아웃 전환(Copilot 2026), 토글 의미 모호화 |
| 요금제 차등 | 소비자=학습 가능, 기업=ZDR·무학습 | privacy를 업셀 상품으로 판매 |
| 제품 텔레메트리 | 실패 세션 분석, 업로드 큐, 할당량 | 학습과 다른 스위치로 남기기 쉬움 |
| 로컬 퍼스트 마케팅 | 「내 PC에서 돈다」와 클라우드 수집의 간극 | 문서에 스냅샷 경로가 안 보이면 신뢰 붕괴 |
| 규제·경쟁 압력 | 데이터가 많을수록 다음 모델이 유리 | 공개 전 서버 플래그로 끄는 식의 사후 완화 |
「어차피 추론하려면 코드가 나가야 한다」는 반론은 절반만 맞다. 추론에 필요한 컨텍스트와 작업과 무관한 저장소 스냅샷·히스토리 보관은 다른 행위다. Grok 사례의 결정적 숫자는 그 구분(192KB vs 5.1GB)에 있다.
6.4. 유사 사례와 구분점
같은 「코드가 클라우드로 간다」라도 메커니즘이 다르다. 혼동하면 대응이 빗나간다.
| 사례 | 무엇이 나갔나 | 성격 | Grok 번들과의 차이 |
|---|---|---|---|
| GitHub Copilot 상호작용 학습 (2026-04-24~, Free/Pro/Pro+) | 프롬프트·제안·커서 주변·구조·피드백 등 | 정책상 학습 목적, 옵트아웃 가능, Biz/Ent 제외 | 공식 고지된 상호작용. git bundle 통째와는 다름 |
| Cursor·Claude Code·Copilot 추론 | 연 파일·검색 청크·에이전트가 읽은 파일 | 서비스 동작에 필요한 전송 | 읽기/인덱스 기반. 「읽지 마」여도 전체 히스토리 번들은 별개 |
| Cursor Privacy Mode / 기업 ZDR | 저장·학습 축소 약속 | 계약·정책 통제 (클라이언트 증명과 별개) | 네트워크 검증이 여전히 필요 |
| OpenCode 등 「로컬」 논란 | 기본 텔레메트리·클라우드 추론 | 마케팅과 기본값 불일치 | 통째 GCS 번들 증거와는 별 축 |
| 삼성전자 ChatGPT 유출 (2023) | 직원이 소스·회의록을 직접 붙여넣기 | 사용자 실수 → 사내 생성형 AI 제한 | 벤더 백그라운드 업로드가 아님 |
| CamoLeak 등 Copilot 프롬프트 인젝션 | 숨은 지시로 사설 코드 유출 가능 | 공격 기법 | 제품 기능으로서의 스냅샷과 다름 |
정리하면, 업계에는 (A) 추론용 컨텍스트, (B) 학습용 상호작용, (C) 제품 트레이스·텔레메트리, (D) 드물게 작업과 무관한 저장소 스냅샷이 섞여 있다. Grok Build 0.2.93 캡처는 (D)에 가깝고, 「모델 개선」 토글은 (B)에 가까운 라벨이었다. 스위치가 어긋난 것이 불신의 핵심이다.
6.5. 유추의 한계 — 이 글이 단정하지 않는 것
- xAI가 업로드분을 학습에 썼다는 증거는 공개되지 않았다.
- 직원 열람·제3자 공유 여부도 미입증이다.
- 모든 계정·지역·요금제에 동일 플래그가 적용됐는지는 한 계정 재테스트로 단정할 수 없다.
- 「AI 회사는 원래 다 훔친다」는 말은 (A)~(D)를 뭉개서, 정작 막아야 할 경로를 흐리게 한다.
실무적으로는 의도를 재판하기보다 경로를 분리해 통제하는 편이 낫다. 추론은 허용하되 /v1/storage·버킷 PUT은 거부하고, 학습 동의와 트레이스 스위치를 따로 확인하며, 소비자 기본값과 기업 ZDR을 계약으로 고정한다. 동기 유추는 「왜 이런 기능이 제품에 붙는지」를 이해하는 틀이지, 특정 기업의 고의를 판결하는 문장이 아니다.
7. 네트워크단 조사 방법
판별의 핵심은 채널 간 바이트 비율이다. 「파일 열지 마」인데도 저장소 크기만큼 나가면 스냅샷 업로드 신호다. 내용까지 확정하려면 복호화·번들 복원이 필요하고, 1차 스크리닝은 목적지 + Sent Bytes만으로도 충분하다.
7.1. mitmproxy로 와이어 확인
mitmproxy/mitmdump를 띄워 CA를 OS 신뢰 저장소에 등록한다.HTTPS_PROXY와 신뢰 CA 경로를 넣고, 더미 저장소에서grok를 「정확히 OK만 답하고 어떤 파일도 열지 마」로 실행한다.- 로그에서
POST .../v1/responses와POST .../v1/storage(및 multipart) 바이트·상태코드를 집계한다. storage.googleapis.com으로 가는 PUT도 같이 본다. API 호스트만 보면 GCS 직접 업로드를 놓친다.- 캡처된 바디에 git bundle 시그니처가 있으면
git clone으로 복원해 카나리 파일이 있는지 확인한다.
로컬 ~/.grok/upload_queue만 보고 「올리지 않았다」고 단정하지 않는다. 와이어에서 200으로 확인된 요청이 기준이다. 재현 스크립트는 exfil-repro에 정리돼 있다.
7.2. 바이너리·이그레스 상시 감시
strings로 바이너리에 grok-code-session-traces·Uploading bytes to GCS 문자열이 있는지 보면 메커니즘 존재를 뒷받침한다. 조직에서는 방화벽·프록시 이그레스 로그에 cli-chat-proxy.grok.com의 /v1/storage 볼륨과 storage.googleapis.com(해당 버킷 경로) 이상을 알럿으로 건다.
8. 윈도우에서 간단히 보는 법
복호화 없이 볼륨 이상만 잡으려면 Windows 내장·무료 도구로도 된다. Sysinternals TCPView가 가장 직관적이다.
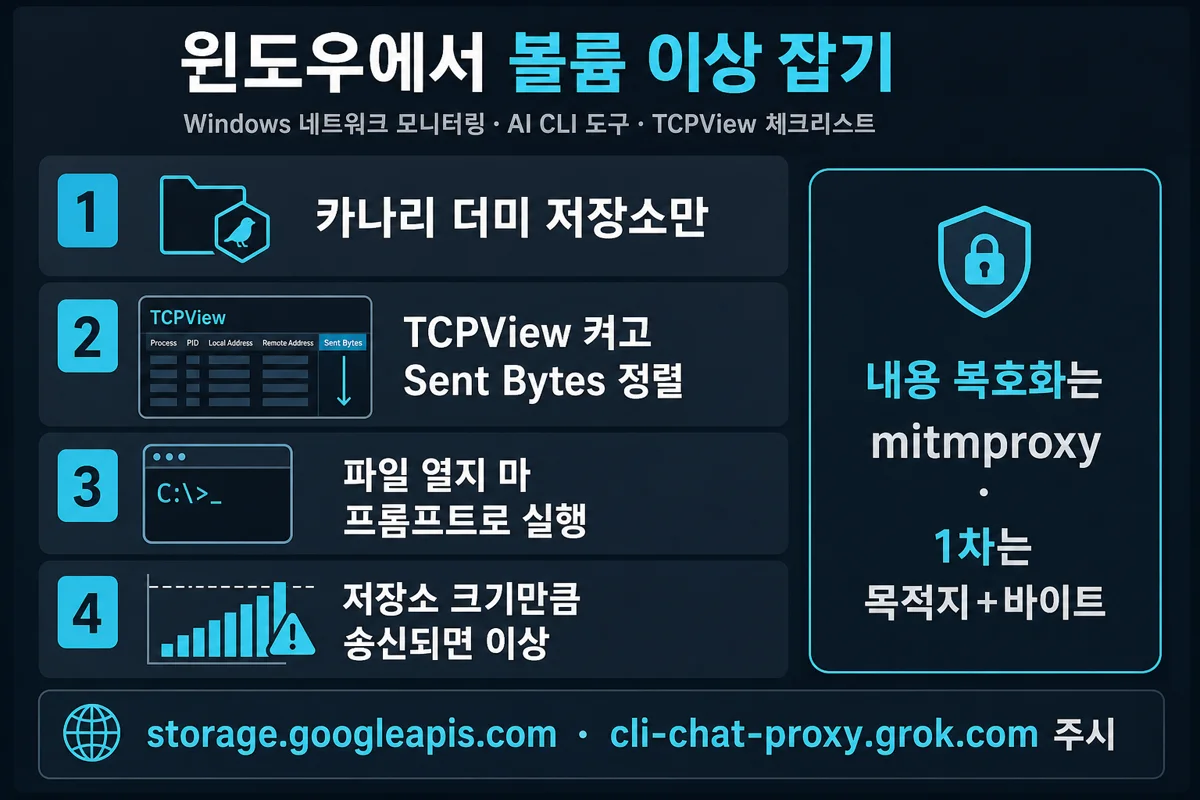 그림 3. 카나리 더미 → TCPView Sent Bytes 정렬 → 「파일 열지 마」 실행 → 저장소 크기만큼 송신되면 이상으로 본다.
8.1. TCPView 절차
- Microsoft 문서(Sysinternals TCPView)에서 받아
tcpview64.exe를 실행한다. - View에서 Resolve Addresses를 켠다. IP 대신 호스트명이 보인다.
- Sent Bytes 열로 내림차순 정렬한다. 대량 송신 프로세스가 위로 온다.
- 브라우저·Steam·클라우드 동기화 등 잡음을 잠시 줄이면 읽기 쉽다.
- 더미 저장소에서 grok을 돌린다. 목록에 grok 또는 별도 업로드 프로세스가 노란(신규) 행으로 뜬다.
- 그 행의 Sent Bytes가 저장소 크기만큼 쌓이고, Remote Address가
storage.googleapis.com·grok.com/x.ai계열이면 1차 이상이다.
검색창에 grok만 치면 별도 프로세스 업로드를 놓칠 수 있다. 필터를 풀고 GCS·대량 송신 행도 한 번 훑는다.
8.2. 리소스 모니터·PowerShell
resmon → 네트워크 탭에서 프로세스별 보내기(B/초)를 본다. PowerShell로는 Get-NetTCPConnection -State Established로 원격 주소를 실시간 확인할 수 있다. 다만 PID를 grok만으로 좁히면 업로드 코디네이터를 놓칠 수 있어, 목적지 기준 교차 확인이 필요하다.
| 도구 | 잘 보는 것 | 못 보는 것 |
|---|---|---|
| TCPView / resmon | 프로세스·목적지·Sent/Recv 바이트 | TLS 안의 파일·시크릿 내용 |
| mitmproxy | 경로·바디·번들 복원 | (설정·동의 없이 타인 트래픽 가로채기 — 금지) |
| 이그레스 로그 | 조직 단위 지속 집계 | 엔드포인트별 GUI 편의성 |
TCPView는 「여기 뭔가 이상하다」를 싸게 잡는 1차 스크리닝이다. 「5GB가 내 저장소 통째인가」까지는 mitmproxy·번들 복원이 2차다. 본인 소유 기기에서 본인 트래픽을 보는 방어적 감사는 정당하지만, 사내망·타인 기기에서 TLS 가로채기는 규정·동의 범위 안에서만 한다.
9. 막는 방법 — 옵트아웃을 넘어
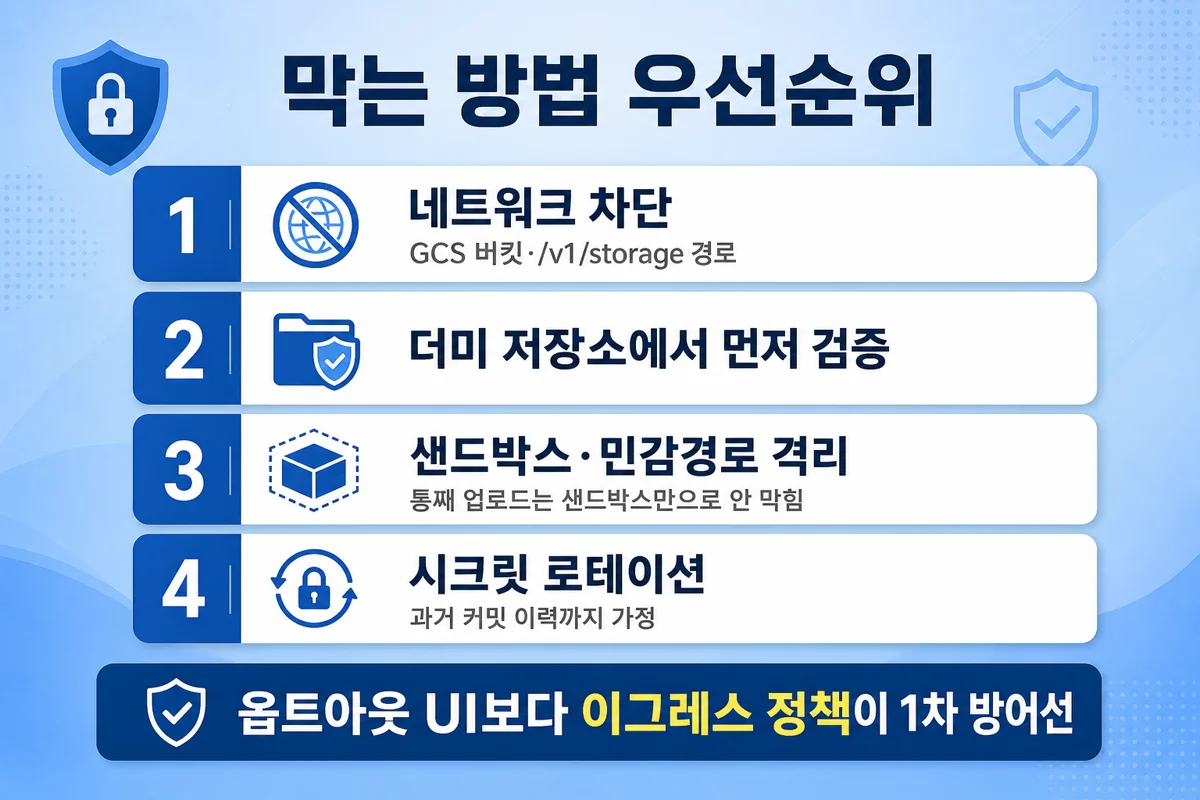 그림 4. 네트워크 차단이 1차. 샌드박스만으로는 통째 업로드를 막지 못한다.
「모델 개선」만 끄고 끝내면 같은 함정에 다시 빠진다. 방어는 레이어를 겹치는 쪽이 맞다. 우선순위는 (1) 이그레스, (2) 로컬/시스템 설정 핀, (3) 샌드박스·권한, (4) 계약·ZDR 서면, (5) 노출 가정 로테이션이다.
9.1. 네트워크가 1차 방어선
xAI 엔터프라이즈 배포 문서 기준으로 핵심 추론·인증에 꼭 필요한 호스트는 cli-chat-proxy.grok.com, auth.x.ai 쪽이다. storage.googleapis.com은 문서상 셸 설치·업데이트용으로 적혀 있지만, 소비자 캡처에서는 세션 트레이스 버킷 PUT에도 쓰였다. 호스트 통째 차단은 설치 경로와 트레이스를 한꺼번에 자를 수 있어, 정책은 경로·버킷 단위로 세분화하는 편이 낫다.
| 차단 대상 | 기대 효과 | 주의 |
|---|---|---|
grok-code-session-traces 경로 PUT | 통째 스냅샷 직접 업로드 차단 | 버킷 경로 매칭 필요 |
프록시에서 /v1/storage* 거부 | 프록시 경유 스냅샷 차단 | 추론 호스트와 경로를 분리해야 함 |
code.grok.com 차단 | 원격 세션 동기화 축소 | 공유 링크·원격 이어가기 불가 |
| 프로그램 경로만 방화벽 차단 | 간단 | 자식·코디네이터 프로세스 누락 가능 |
Windows에서도 프로그램 경로만 막지 말고 도메인·경로 기반을 우선한다. 차단 후 더미에서 「파일 열지 마」로 다시 돌려 Sent Bytes가 저장소 크기만큼 안 쌓이는지 확인한다.
9.2. 로컬·시스템 설정으로 업로드 채널 핀
커뮤니티에서 정리한 로컬 킬 스위치(privacy-hardening 등)와 공식 설정 계층을 겹쳐 쓰면, 「서버가 다시 켠다」 리스크를 줄일 수 있다. 공식 우선순위는 대략 env > 사용자 config > 원격 설정이고, 조직용 /etc/grok/requirements.toml(root) 은 하위·원격·사용자 우회를 막는 핀 레이어다.
| 키·수단 | 역할 | 실무 메모 |
|---|---|---|
[harness] disablecodebaseupload = true | 저장소 통째 업로드 파이프라인 하드 거부 | 커뮤니티 재현에서 강제 업로드 env에도 버팀 |
[telemetry] trace_upload = false | 세션 트레이스 업로드 끔 | 오염된 env가 true면 env가 이김 |
[features] telemetry = false | 텔레메트리 일괄 축소 | 깨끗한 셸에서 적용·재확인 |
GROKTELEMETRYENABLED=0 / GROKTELEMETRYTRACE_UPLOAD=0 | env 최상위 | 래퍼 스크립트·CI에 고정 |
/etc/grok/requirements.toml | 조직 fail-closed 핀 | MDM·골든 이미지에 배포 |
disablebypasspermissions_mode = true | --yolo류 우회 봉쇄 | root 소유 requirements에서만 신뢰 |
CLI /privacy | 코딩 데이터 보존 UI 점검 | Team/Enterprise ZDR과 별개로 확인 |
사용자 홈 ~/.grok/config.toml만 바꾸면 원격 설정·상속 env에 밀릴 수 있다. 조직 머신은 requirements에 박고, 개인은 config + 셸 env를 같이 건 뒤 더미에서 와이어/TCPView로 재검증한다. 설정만 넣고 끝내지 않는다.
9.3. 샌드박스·권한·무시 파일의 한계
--sandbox strict·read-only는 파일 쓰기·(Linux) 자식 네트워크를 줄인다. SSH·클라우드 자격 경로 쓰기 보호도 도움이 된다. 다만 업로드는 CLI 본체(또는 그 자식)가 하고, git bundle은 읽기만 되면 만들어진다. --deny Read(secret.txt)는 모델이 읽는 행위를 막을 뿐, 추적 파일이 번들에 들어가는 것과는 별개다(재현 레포가 강조한 구분). .grokignore·.gitignore는 보조일 뿐, 이 사건처럼 번들이 추적 파일 기준이면 무시 규칙만으로 안심하기 어렵다.
9.4. ZDR·엔터프라이즈는 서면으로
Zero Data Retention은 엔터프라이즈 문서상 추론 계층 잔존을 팀 단위로 다루는 경로다. 저장소 스냅샷 업로드가 ZDR과 같은 스위치인지는 문서만으로 단정하지 말고, 도입 전 xAI에 서면으로 확인한다.
/v1/storage→grok-code-session-traces가 ZDR/옵트아웃에서 실제로 비활성인지- 이미 수집된 번들의 삭제 범위·일정·증명
- 소비자·팀·엔터프라이즈·API 키 경로별 포함/제외 표
- 감사 로그로
/v1/storage볼륨을 고객이 볼 수 있는지
9.5. 노출 가정 시 조치
이미 민감 저장소에서 돌렸다면 파일 삭제만으로 끝나지 않는다. API 키·DB 비밀번호·클라우드 토큰·웹훅 시크릿을 로테이션한다. git 히스토리에 한 번이라도 들어간 값은 현행 브랜치에서 지워도 번들에 남을 수 있다. 평가가 필요하면 더미·살균 export만 쓰고 .git·실 .env·고객 픽스처는 복사하지 않는다.
10. AI 공급자 일반 감시에 TCPView가 쓰이는가
쓰인다. 범위는 명확하다. 어디로 얼마나 나가는지는 잘 보이고, 그 안에 뭐가 들었는지는 안 보인다. Grok 사건도 결정적 증거는 「모델이 쓴 192KB vs 실제로 나간 5GB+」라는 볼륨 비율이었고, 그 신호는 TCPView 수준에서도 잡힌다.
한계도 있다. 업로드가 본체와 다른 프로세스명이면 이름 필터만으로 놓친다. CDN·범용 클라우드 스토리지만 보이면 「어느 회사 버킷인지」는 이름만으로 애매하다. 짧은 연결은 화면에서 사라지니 누적 Sent Bytes·지속 모니터링이 더 신뢰할 만하다. 조직 상시는 엔드포인트 GUI보다 이그레스 로깅 + 볼륨 알럿이 견고하다.
다른 코딩 CLI(Claude Code, Codex, Gemini CLI 등)와 비교한 공개 재현(cereblab COMPARISON, 2026-07-13 캡처)에서는 Grok이 통째 저장소 업로드의 이상치로 잡혔고, 같은 날 서버 플래그 이후에는 재현되지 않았다. 도구마다 다르므로 「AI면 다 같다」가 아니라 도구별 와이어 검증이 맞다.
11. 상황별 선택표
| 상황 | 권장 행동 |
|---|---|
| 회사 코드·고객 데이터 있는 PC | 소비자 Grok Build를 붙이지 않거나, 격리 devbox + 이그레스·requirements 핀 후만 |
| 제품 평가만 필요 | 카나리 더미 + TCPView/mitmproxy로 볼륨·경로 확인 |
| 옵트아웃만 끈 상태 | 불충분. config/env/requirements + 네트워크 재검증 |
| 이상 송신 의심 | Sent Bytes·목적지 1차 → mitmproxy·번들 복원 2차 |
| 이미 실저장소에서 실행 | 시크릿 로테이션 + git 히스토리 점검 + 벤더에 삭제·범위 문의 |
| 조직 도입 | /etc/grok/requirements.toml + 계약상 보존·경로별 통제표 + ZDR 서면 |
| 개인 학습용 공개 저장소 | 위험은 낮지만 동일하게 옵트아웃≠업로드 끔으로 이해 |
12. 마무리
앞에서 다룬 Grok Build 저장소 업로드 이슈의 핵심만 짧게 정리한다.
- 증명된 것: 0.2.93 소비자 세션에서 추적 저장소(+히스토리)가
/v1/storage→GCS로 올라갔고, 읽지 말라고 한 파일도 번들에 있었다. - 판별 신호: 모델 채널 바이트 ≪ 저장 채널 바이트(사례 ~27,800:1).
- 옵트아웃: 「모델 개선」은 학습 동의에 가깝고, 당시 스냅샷을 끄지 않았다.
- 유인(유추): SWE 에이전트용 실세계 궤적·저장소 맥락이 희소하고, 기본값·요금제·텔레메트리가 수집을 키운다. 학습 사용 자체는 Grok에서 미입증.
- 유사 사례: Copilot 상호작용 학습(옵트아웃), 추론용 컨텍스트 전송, 삼성 ChatGPT 붙여넣기 유출 등은 메커니즘이 다르다. 통째 git bundle과는 구분한다.
- 이후: 7월 13일 서버 플래그로 한 계정에서 업로드 0건. 공식 공지·기수집 삭제는 미확인.
- 1차 방어: GCS 버킷·
/v1/storage이그레스 + requirements/config/env 핀. 샌드박스만으로는 부족하다. - 윈도우 1차 감시: TCPView Sent Bytes + 목적지. 내용 확정은 mitmproxy.
- 퍼진 경로: Threads · GeekNews · ICD · Reddit — 증거 원본은 gist.
- 공통 함정: 「클라우드면 다 가져간다」로 통째 스냅샷과 필요 컨텍스트를 구분하지 않는 것. 수치·정책은 벤더 공지와 본인 계정·이그레스 재검증이 필요하다.
「옵트아웃 UI보다 이그레스와 바이트 비율이 먼저다.」 — 민감 저장소에 에이전트를 붙이기 전에 더미에서 목적지·볼륨을 확인하고, 설정·네트워크로 끊은 뒤 시크릿을 돌리자.
자주 묻는 질문
- Grok Build가 저장소 전체를 올렸다는 근거는 무엇인가?
cereblab이 mitmproxy로 0.2.93 트래픽을 캡처했다. 「파일 열지 마」 프롬프트에도 /v1/storage로 git bundle이 올라갔고, 번들을 clone하면 never-read 카나리와 커밋 이력이 복원됐다. 12GB 테스트에서는 모델 채널 약 192KB 대비 저장 채널 약 5.1GB가 관측됐다. 원본은 gist와 재현 레포에 있다.
- 모델 개선 옵트아웃을 끄면 업로드가 멈추나?
당시 캡처에서는 멈추지 않았다. 해당 토글은 학습 동의에 가깝고, 설정 응답에 traceuploadenabled가 true로 남아 저장소 스냅샷이 진행됐다. 학습 동의와 스냅샷·텔레메트리는 다른 통제 축으로 봐야 한다. ICD·GeekNews 정리도 같은 구분을 강조한다.
- 지금은 안전한가? 서버가 껐다고 들었다.
7월 13일 같은 클라이언트에서 disablecodebaseupload true와 traceuploadenabled false가 관측되며 6회 재테스트에서 /v1/storage 저장소 업로드가 0건이었다. 한 계정 검증이고 공식 공지·기수집 삭제는 없다. 서버 토글은 바뀔 수 있어 로컬 핀과 네트워크 검증이 필요하다.
- 옵트아웃 외에 로컬에서 끌 수 있는 설정이 있나?
커뮤니티·공식 계층을 겹친다. harness의 disablecodebaseupload, telemetry의 traceupload=false, features telemetry=false, 셸의 GROKTELEMETRY_* env, 조직은 /etc/grok/requirements.toml에 핀한다. env가 config보다 우선하므로 오염된 환경 변수도 점검하고, 적용 후 더미에서 와이어나 TCPView로 재확인한다.
- 윈도우에서 mitmproxy 없이 어떻게 보나?
Sysinternals TCPView로 Sent Bytes를 정렬하고, 더미 저장소에서 「파일 열지 마」로 grok을 돌린다. 저장소 크기만큼 송신이 쌓이고 목적지가 storage.googleapis.com이나 grok/x.ai 계열이면 1차 이상이다. 리소스 모니터의 보내기(B/초)도 보조로 쓸 수 있다.
- TCPView만으로 통째 업로드를 확정할 수 있나?
확정은 어렵다. TCPView는 목적지와 바이트만 보여 TLS 내용·번들 구성은 안 보인다. 이상 징후 스크리닝용이고, 카나리 파일이 번들에 들어갔는지까지는 mitmproxy 복호화와 git clone 복원이 필요하다.
- 방화벽으로 storage.googleapis.com만 막으면 되나?
GCS 직접 PUT 차단은 중요하다. 다만 일부 저장 트래픽은 추론 프록시 cli-chat-proxy.grok.com의 /v1/storage로도 간다. 호스트 통째 차단은 추론까지 죽일 수 있어, 버킷·경로 거부와 /v1/storage 거부를 조합하는 편이 낫다. 엔터프라이즈 문서의 필수 호스트 표와 교차해 정책을 짠다.
- 샌드박스 strict면 통째 업로드가 막히나?
파일 접근은 줄지만 업로드는 CLI가 수행하고 git bundle은 읽기만 되면 만들어진다. Read deny는 모델 읽기만 막을 수 있고 번들 포함과는 별개다. 이그레스와 설정 핀이 1차 방어선이다.
- 국내에서는 어디서 이 소식을 볼 수 있나?
Threads의 choi.openai 공유 스레드와 GeekNews 토픽 31375에 요지가 정리돼 있다. 영문 요약은 International Cyber Digest, 커뮤니티 토론은 Reddit r/LocalLLaMA, 증거 원본은 cereblab gist와 재현 레포를 보면 된다.
- 이미 회사 저장소에서 돌렸다면 무엇을 하나?
에이전트가 읽었거나 히스토리에 있던 시크릿을 로테이션한다. 현행 파일만 지워서는 부족하다. 벤더에 수집 범위·삭제 계획을 문의하고, 이후에는 requirements/env 핀과 이그레스 차단을 건 뒤 더미에서 네트워크 검증을 먼저 한다.
- 다른 AI 코딩 CLI도 같은가?
공개 비교 재현에서는 Grok이 통째 저장소 업로드의 이상치로 잡혔고, 같은 날 서버 플래그 이후에는 재현되지 않았다. 도구마다 다르므로 동일 카나리·프록시 방법으로 각각 검증하는 편이 맞다.
- Zero Data Retention이면 저장소 업로드도 끄나?
문서상 ZDR은 주로 추론 계층 잔존을 팀 단위로 다룬다. /v1/storage 스냅샷 경로까지 같은 스위치인지는 서면 확인이 필요하다. ZDR만 믿고 이그레스·로컬 핀을 생략하지 않는 편이 안전하다.
- AI 회사는 왜 코드나 저장소를 모으려 하나?
공개 정적 코드만으로는 멀티파일 디버깅·테스트 통과형 에이전트를 키우기 어렵다. SWE-Gym·SWE-rebench·RepoForge 같은 연구가 보여 주듯 실행 환경·상호작용 궤적·보상이 병목이다. 제품 세션은 그 궤적을 싸게 모을 후보가 된다. 다만 Grok 업로드분이 학습에 쓰였다는 증거는 공개되지 않았다.
- 학습에 정말 통째 저장소가 필요한가?
자동완성에는 스니펫·커서 주변이면 충분한 경우가 많다. 에이전트·벤치마크 경쟁으로 갈수록 의존성·히스토리·도구 호출 궤적의 가치가 커진다. 필요성과 동의 없는 통째 업로드의 정당성은 별개다. 데이터 최소화와 경로별 문서화가 기준이 돼야 한다.
- 비슷한 사례로 무엇이 있나?
GitHub Copilot은 2026년 4월부터 Free/Pro/Pro+ 상호작용을 기본 학습에 쓰고 옵트아웃을 요구했다. Cursor·Claude Code 등은 추론을 위해 컨텍스트를 보낸다. 2023년 삼성 ChatGPT 건은 직원이 직접 붙여 넣은 유출이다. Grok 0.2.93의 읽기 무관 git bundle·GCS 저장과는 메커니즘을 구분해야 한다.
- 그럼 학습용 수집과 트레이스는 어떻게 구분하나?
학습 동의 토글, 세션 트레이스 플래그, 추론 컨텍스트, 저장소 스냅샷은 다른 축이다. Grok에서는 모델 개선을 꺼도 trace_upload가 켜져 있었다. 설정 이름만 믿지 말고 /v1/storage·Sent Bytes·버킷 경로를 네트워크로 확인하는 편이 안전하다.